
YHOAN FRANCO
MUY BUENO
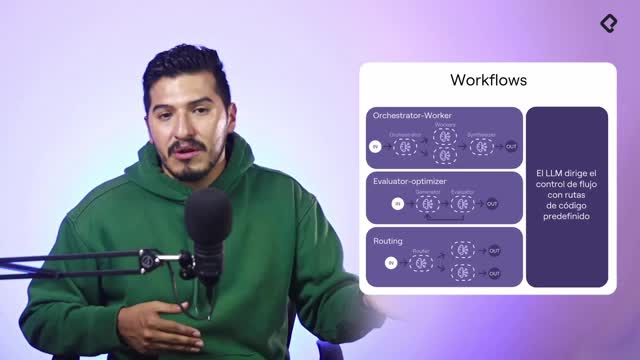
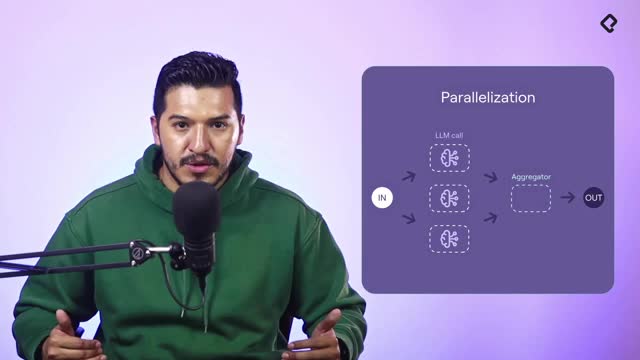
Un agente eficaz no sigue un guion fijo: se adapta, decide y ejecuta lo imprescindible para resolver la tarea. Aquí aprenderás cómo el patrón orchestrator permite elegir dinámicamente qué nodos correr, cuándo hacerlo en paralelo y cómo sintetizar una única respuesta final con un aggregator.
¿Qué es el patrón orchestrator y por qué supera la paralelización y el routing?
El objetivo del patrón es claro: seleccionar de forma dinámica los nodos a ejecutar según el contexto y correrlos en paralelo solo cuando haga falta. A diferencia de otros patrones:
Esta decisión puede apoyarse en AI, el historial o reglas. El flujo típico: selección de nodos, ejecución en paralelo de los elegidos y síntesis con un aggregator. La estructura de salida y el historial ayudan a que el motor tome decisiones consistentes.
¿Cómo decide qué nodos ejecutar?
La decisión puede estar guiada por un large language model, reglas o incluso algo aleatorio para ilustrar el concepto. Lo importante es que el orchestrator actualiza el estado con los nodos seleccionados y esos se lanzan en paralelo. El orden de inicio puede variar y el de finalización también, por lo que el aggregator debe consolidar solo los resultados presentes y generar un summary robusto.
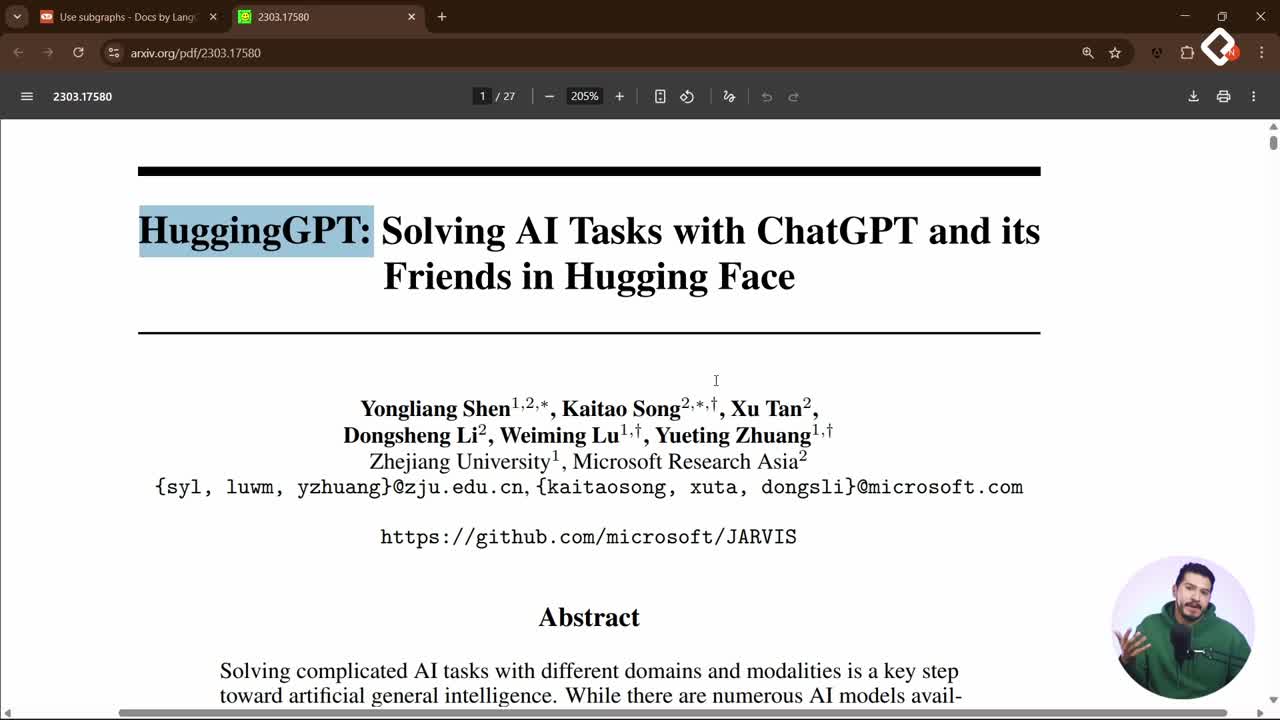
¿En qué ayuda HuggingGPT con el task planning?
Como inspiración, se emplea la idea de HuggingGPT para descomponer un request y asignar el mejor modelo por paso. Flujo típico:
Ejemplos comentados: describir una imagen y contar objetos, o generar una imagen con la pose de otra y luego describirla con voz. El orchestrator replica esta lógica: divide, elige modelos, ejecuta en paralelo y sintetiza.
¿Cómo implementarlo con send y una función asignar nodos?
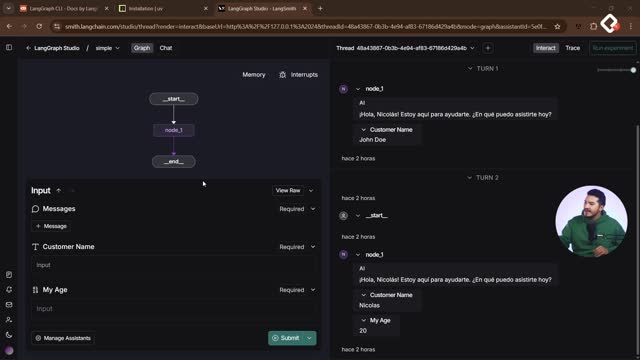
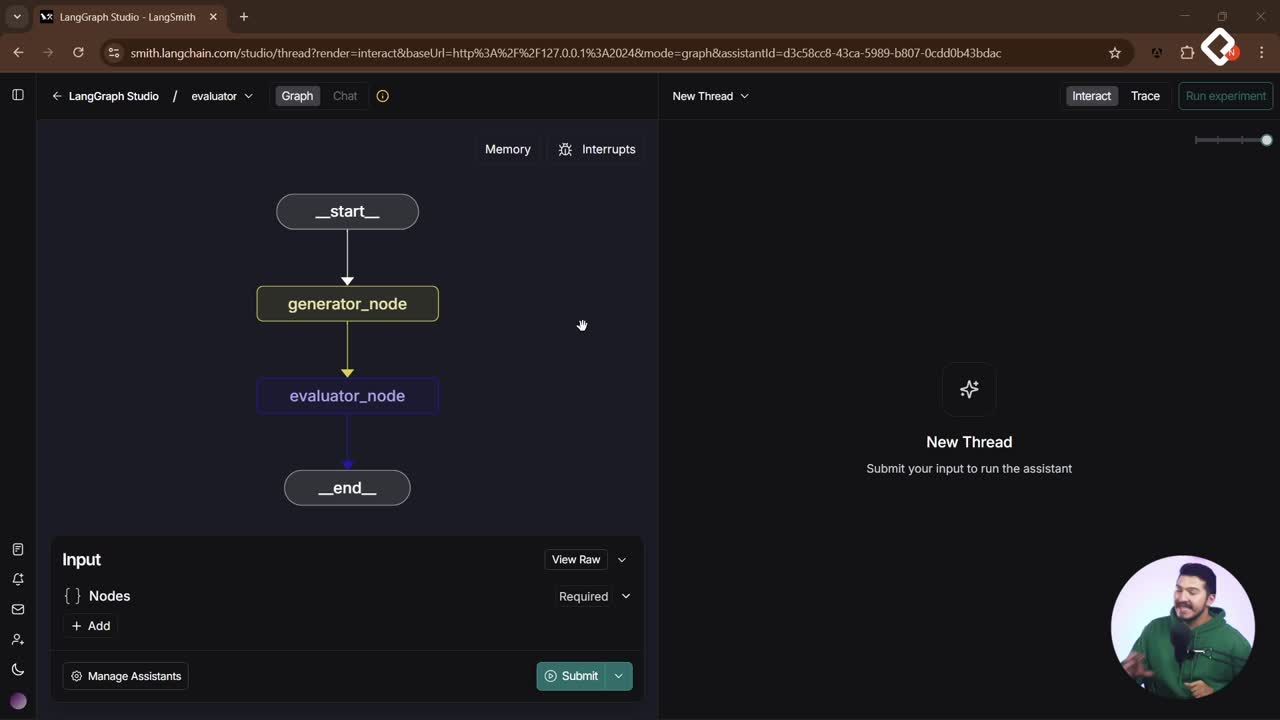
Se parte de un template que hoy imita paralelización (siempre corre nodo 1, 2 y 3). El ajuste clave es mover la decisión al orchestrator para que elija qué nodos ejecutar y luego los dispare en paralelo con el comando send.
¿Cómo preparar el estado y actualizar los nodos?
El orchestrator decide y guarda en el estado la lista de nodos a ejecutar. Para ilustrar la idea se puede usar un criterio aleatorio; en producción, la decisión puede venir de un LLM con structured output y el historial.
import random def orchestrator(state: dict) -> dict: # Ejemplo pedagógico: decisión aleatoria de qué nodos correr posibles = [ ["nodo_1"], ["nodo_2"], ["nodo_3"], ["nodo_1", "nodo_2"], ["nodo_2", "nodo_3"], ["nodo_1", "nodo_3"], ["nodo_1", "nodo_2", "nodo_3"] ] elegidos = random.choice(posibles) state["nodos"] = elegidos return state # el orquestador actualiza el estado con los nodos elegidos
Puntos clave:
¿Cómo disparar ejecuciones en paralelo con send?
El edge de asignación lee el estado y envía, con send, una lista de nodos a ejecutar en paralelo. Cada envío puede llevar su propio estado.
def asignar_nodos(state: dict): # Ejecuta en paralelo los nodos seleccionados por el orquestador return [ send(nodo, {}) for nodo in state.get("nodos", []) ]
De forma explícita, sería equivalente a:
# Ejemplo ilustrativo si se hubieran elegido los tres send("nodo_1", {}) send("nodo_2", {}) send("nodo_3", {})
Consideraciones prácticas:
¿Cuándo aplicarlo en customer support y tareas multimodales?
En soporte, si el usuario pide dos cosas a la vez, por ejemplo: consejos para optimizar el sitio y agendar una cita con el doctor Pérez, el orchestrator podría lanzar en paralelo el agente de conversación y el de reservas, y luego unificar la respuesta. Aun así, se recomienda en soporte guiar a una sola tarea por turno, especialmente si se integra con canales como WhatsApp.
Dónde brilla el patrón:
¿En qué otros escenarios aplicarías un orchestrator para ganar velocidad y claridad? Comparte ideas y casos que te gustaría explorar.
Les recomiendo correr este script (de la documentación de LangGraph), y mirar cómo el llm hace múltiples llamadas en paralelo (crea workers), para generar algo. Yo le mandé en topic “Informe sobre LLMs”, y me creó 8 workers, y me hizo un ensayo practicamente, jaja. Qué genial.
from langchain.chat_models import init_chat_model from langchain_core.messages import SystemMessage, HumanMessage from langgraph.graph import START, END, StateGraph from langgraph.graph.state import BaseModel from langgraph.types import Send from typing import TypedDict, Annotated, List import operator from pydantic import Field # Schema for structured output to use in planning class Section(BaseModel): name: str = Field( description="Name for this section of the report.", ) description: str = Field( description="Brief overview of the main topics and concepts to be covered in this section.", ) class Sections(BaseModel): sections: List[Section] = Field( description="Sections of the report.", ) # Augment the LLM with schema for structured output llm = init_chat_model("openai:gpt-4o", temperature=1) planner = llm.with_structured_output(Sections) # Graph state class State(TypedDict): topic: str # Report topic sections: list[Section] # List of report sections completed_sections: Annotated[ list, operator.add ] # All workers write to this key in parallel final_report: str # Final report # Worker state class WorkerState(TypedDict): section: Section completed_sections: Annotated[list, operator.add] # Nodes def orchestrator(state: State): """Orchestrator that generates a plan for the report""" # Generate queries report_sections = planner.invoke( [ SystemMessage(content="Generate a plan for the report."), HumanMessage(content=f"Here is the report topic: {state['topic']}"), ] ) return {"sections": report_sections.sections} def llm_call(state: WorkerState): """Worker writes a section of the report""" # Generate section section = llm.invoke( [ SystemMessage( content="Write a report section following the provided name and description. Include no preamble for each section. Use markdown formatting." ), HumanMessage( content=f"Here is the section name: {state['section'].name} and description: {state['section'].description}" ), ] ) # Write the updated section to completed sections return {"completed_sections": [section.content]} def synthesizer(state: State): """Synthesize full report from sections""" # List of completed sections completed_sections = state["completed_sections"] # Format completed section to str to use as context for final sections completed_report_sections = "\n\n---\n\n".join(completed_sections) return {"final_report": completed_report_sections} # Conditional edge function to create llm_call workers that each write a section of the report def assign_workers(state: State): """Assign a worker to each section in the plan""" # Kick off section writing in parallel via Send() API return [Send("llm_call", {"section": s}) for s in state["sections"]] # Build workflow orchestrator_worker_builder = StateGraph(State) # Add the nodes orchestrator_worker_builder.add_node("orchestrator", orchestrator) orchestrator_worker_builder.add_node("llm_call", llm_call) orchestrator_worker_builder.add_node("synthesizer", synthesizer) # Add edges to connect nodes orchestrator_worker_builder.add_edge(START, "orchestrator") orchestrator_worker_builder.add_conditional_edges( "orchestrator", assign_workers, ["llm_call"] ) orchestrator_worker_builder.add_edge("llm_call", "synthesizer") orchestrator_worker_builder.add_edge("synthesizer", END) # Compile the workflow orchestrator_worker = orchestrator_worker_builder.compile()

YHOAN FRANCO
MUY BUENO
Fabio Alvarez
Durante los primeros 5 minutos ha repetido la misma idea multiples veces, lo cual no es óptimo y hace que el tiempo de la clase aumente sin agregar mucho valor.
Jose Antonio Pinto Gimeno
En un agente de ayuda para recursos humanos creo que seria un patron adecuado:
Nodo1: Se conecta a la BD en tiempo real para consultar el estado actual, vacaciones, horarios asignados, personal disponible, etc.
Nodo2: Se conecta a la API de wheather para evaluar las previsiones del tiempo, ideal para equipos que trabajan al aire libre y preveer posibles problemas operativos
Nodo3: Se conecta a la API de servicios de mensajeria, para poder confirmar con los equipos indisposiciones, cambios solicitados o confirmaciones.
Nodo4: Se conecta a la aplicación de gestión de proyectos de la empresa para analizar proyectos en proceso, tareas pendientes, plazos previstos o necesidades puntuales.
Nodo5: Provee información del sistema RAG de la empresa, proyectos anteriores, posibles problemas imprevistos, información tecnica y operativa.
Y el orchestator se encarga de activar los nodos necesarios dependiendo de la solicitud del usuario, analizando la situación y avisando a los responsables o equipos necesarios con actuaciones pendientes o incidencias.
Jaime Aza
en esta parte
def assign_nodes(state: State) -> Literal['node_1', 'node_2', 'node_3']: nodes = state['nodes'] return [Send(node, {}) for node in nodes]
Está bien enviar el estado vacio {} ?? no se debería enviar el estado para que los nodos vayan con el estado completo ? 🤔🤔
Nicolas Molina
ProfesorEl estado en un agente de LangGraph es compartido, entonces realmente puedes obtener el estado en cada nodo de forma individual y en este caso el Send es obligatorio, entonces por eso lo pasamos en vacío, ahora también puedes enviarle tu propio estado y no hay problema digamos que las 2 formas funcionan, pasarle el estado u obtenerlo de la memoria compartida.