



Esther Janeth Machado Valenzuela
Genial, me gusta la idea de reforzar lo aprendido con retos.


Ricardo Alanis
ProfesorChi

Luis Jacobo Hernandez Campuzano
Muy buena idea el incluir retos.
¡Hola! Qué emoción tenerte en este curso donde comenzarás a formarte como toda una o un Data Engineer.
Durante las clases compartiré varios retos que son preguntas o actividades sencillas donde tendrás que investigar o compartir tu opinión o perspectiva. Para ello llevarás una guía de retos, un documento donde escribirás tus respuestas..
Para continuar con el curso descarga aquí la Guía de retos del Curso de Fundamentos de Ingeniería de Datos. ⬅️
En este documento responderás las preguntas y actividades de los retos que aparecen al final de cada clase. Además, al terminar cada módulo tendrás un espacio donde dejarás tus propias reflexiones sobre lo que has aprendido. Siéntete libre de investigar, buscar y escribir lo que hayas encontrado.
Bonus: anatomía Data Engineer
Las y los Data Engineer o Ingenieros de Datos se encargan de tomar los datos crudos de valor, para transformarlos y almacenarlos en bases de datos de analítica y disponibilizarlos a software que funciona en sistemas de producción. Para ello crean pipelines ETL y utilizan bases de datos especializadas, con los que abastecen de datos a los demás roles de un equipo de data y a sistemas de software que funcionan con datos y machine learning.
Recuerda esto que es la base de la definición de un Data Engineer. Descarga la infografía de su anatomía para que te empieces a familiarizar en el perfil en el que te convertirás. 💪🏽

Al terminar el curso comparte todos tus aprendizajes en los comentarios de la clase final. Así podrás intercambiar ideas y soluciones con toda la comunidad de data de Platzi. 🙌🏽
Esther Janeth Machado Valenzuela
Genial, me gusta la idea de reforzar lo aprendido con retos.
Ricardo Alanis
ProfesorChi
Luis Jacobo Hernandez Campuzano
Muy buena idea el incluir retos.
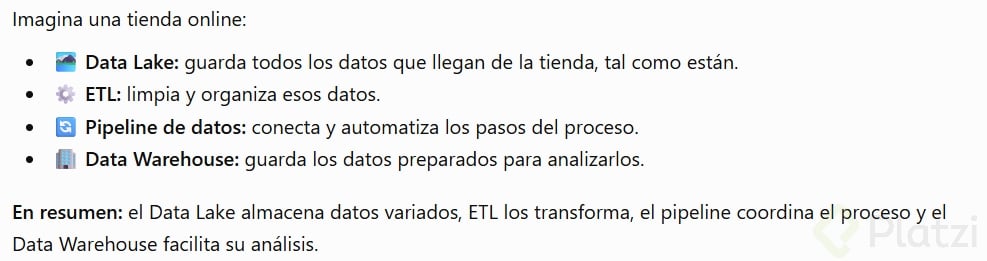
Esto fue lo que encontré sobre los conceptos de la imagen, espero sea útil :D
Pipeline de Datos: Una pipeline de datos es una construcción lógica que representa un proceso dividido en fases. Las pipelines de datos se caracterizan por definir el conjunto de pasos o fases y las tecnologías involucradas en un proceso de movimiento o procesamiento de datos. Las pipelines de datos son necesarias ya que no debemos analizar los datos en los mismos sistemas donde se crean.
Data Warehouse: Un Data Warehouse es un almacén electrónico donde generalmente una empresa u organización mantiene una gran cantidad de información. Los datos de un data warehouse deben almacenarse de forma segura, fiable, fácil de recuperar y fácil de administrar.
Data Lake: Es un sistema o biblioteca de datos almacenados en su formato bruto, usualmente blobs o ficheros
ETL: es el proceso que permite a las organizaciones mover datos desde múltiples fuentes, reformatearlos y limpiarlos, y cargarlos en otra base de datos, data mart, o data warehouse para analizar, o en otro sistema operacional para apoyar un proceso de negocio.
Pablo Rivera
VOCABULARIO
ETL: (Extract, Transform, Load)
Data lake: (se refiere a un sistema de almacenamiento centralizado que permite almacenar grandes cantidades de datos en bruto, en su formato nativo, sin necesidad de estructurarlos previamente)
Pipeline de datos: (un pipeline de datos simplifica y automatiza el flujo de datos, desde su origen hasta su destino, garantizando la coherencia y la calidad a lo largo de todo el proceso.)
Data Warehouse:(es un sistema de almacenamiento centralizado y optimizado para el análisis y la consulta eficiente de grandes volúmenes de datos.)
Programación con Python y bases solidas de ingeniería de Software
Manejo de datos estructurados y no estructurados
Computo, almacenamiento y bases de datos en la nube
ETL con herramientas como SQL, Apache Spark y airflow
Apache Airflow: es una plataforma de orquestación de código abierto diseñada para programar, monitorear y gestionar flujos de trabajo (workflows) de datos
Apache Spark: es un framework de procesamiento de datos de código abierto diseñado para el procesamiento distribuido y rápido de grandes conjuntos de datos

Ricardo Alanis
Profesor<3
Julian Castro Pulgarin
Cool! Me gusta esta metodologia de los ultimos cursos de Platzi, más interactivos y que te incita a expandir el concoimiento que te da el curso 0.0
Ricardo Alanis
Profesor<3 gracias por seguir este curso, Julián!
Patricio Sánchez Fernández
Muy instructiva la infografía. El Data Engineer es todo un Rambo de la data.
Andres Velasquez
Los retos desarrollan habilidades. Excelente comienzo de curso!
Ricardo Alanis
ProfesorExactamente!!

Boris Barrera
Muy bien, estoy emocionado de comenzar a aprender

Luis Alfredo Villalta López
Data Engineer, Quiero aprender a programar con Python de forma correcta, aplicar las mejores practicas, Saber como funciona Spark y Airflow, necesito implementar un DW, con millones de registros.

Nathaly Johanna Rodriguez Triana
Actualmente ya realizo varias de las actividades como Ingeniero de Datos, sé que todavía hay mucho por aprender y poner en práctica, así que continuare.

Daniel Alfredo Castro Velásquez
Un data lake es un repositorio de almacenamiento que permite guardar grandes volúmenes de datos en su forma original, sin necesidad de estructurarlos previamente. Esto facilita la ingesta de datos provenientes de diversas fuentes, como bases de datos, archivos y aplicaciones.
Un pipeline de datos, por otro lado, es un conjunto de procesos que permite mover, transformar y cargar datos desde su origen hasta el destino, como un data warehouse o un data lake. Este proceso incluye etapas de extracción, transformación y carga (ETL).
Ambos conceptos son fundamentales en la ingeniería de datos, ya que permiten gestionar y analizar grandes volúmenes de información de manera eficiente.

Diego Andrés Díaz Gómez
ETL (Extracción, Transformación y Carga): Es un proceso en ingeniería de datos que consiste en extraer datos de múltiples fuentes, transformarlos para que sean limpios, consistentes y adecuados para su análisis, y finalmente cargarlos en un sistema de destino como un data warehouse o data lake. Es fundamental para integrar y preparar datos para posteriores análisis y toma de decisiones.
Data lake: Es un repositorio de almacenamiento que permite guardar grandes volúmenes de datos en su formato original, ya sean estructurados, semi-estructurados o no estructurados. Los data lakes permiten almacenar datos sin necesidad de procesarlos o transformarlos antes, facilitando su uso en análisis avanzados y machine learning.
Data warehouse (almacén de datos): Es una base de datos organizada y optimizada para la consulta y el análisis de grandes volúmenes de datos estructurados, que han sido previamente procesados y limpiados. Los data warehouses soportan inteligencia empresarial y reporting, y suelen recibir datos mediante procesos ETL.
Pipeline de datos: Es un conjunto automatizado de procesos que mueven y transforman datos desde sus fuentes hasta su destino final para su almacenamiento o análisis. Incluye etapas como extracción, transformación, carga, validación y monitoreo. Los pipelines ETL son un tipo específico de pipeline de datos enfocados en las fases de extracción, transformación y carga.
Herramientas de Apache:

Andrés González
Lo que más me gusta de la ingeniería de datos es que es una profesión donde después de dominar la parte técnica se debe pensar para transformar los datos en información útil para la sociedad y se puede aplicar en cualquier área. esto está emocionante

Edward Franz Zevallos Horna
UN nuevo vocabulario en esta travesía: pipeline de datos es un conjunto de pasos y procesos secuenciales diseñados para mover, transformar y procesar datos de manera automatizada desde una fuente hasta un destino final. Es una estructura que permite la orquestación y ejecución ordenada de diversas tareas relacionadas con el flujo de datos ETL: ETC(EXTRACT, TRANSFORM Y LOAD) **DATALAKE: **Es un repositorio centralizado y escalable que almacena grandes volúmenes de datos en su forma original y sin procesar. data warehouse se centra en el análisis a gran escala y la generación de informes utilizando datos consolidados de diversas fuentes. El data warehouse está diseñado para facilitar el análisis empresarial y proporcionar una vista unificada de los datos para una toma de decisiones informada.
Ricardo Alanis
ProfesorGracias por compartir!
Nestor Antonio Pineda Otero
Reto aceptado.
Ricardo Alanis
ProfesorVamos para adelante!
Miguel Angel Reyes Moreno
El obstáculo es el camino
Ricardo Alanis
ProfesorVamos con todo!

Kyara Peluso

Jorge Armando Góngora Rojas
pero que significa ETL?
ETL son las siglas en inglés de Extract, Transform, Load (Extracción, Transformación y Carga).
Es el acrónimo exacto de los tres pasos que mueven y preparan la información: sacarla de donde vive, adaptarla para que sirva, y guardarla donde se va a usar. ¿Cuál de esas tres fases crees que suele consumir más tiempo en un proyecto real?
Jesús Eduardo Paredes Alcaraz
En la nube, o en otra base de datos especializada?
¡Exacto! Van directo a repositorios en la nube o bases de datos especializadas (como un data warehouse) listos para que analistas y modelos los consuman sin fricción.
¿Te late si pasamos a ver cuáles son las herramientas principales que orquestan todo este flujo?

Jhoan Sebastian Lozano Gutierrez
Actualmente estoy terminando mi carrera como ingeniero de software, pero en mi trayectoria encontré una pasión y esa fue en los datos quiero enfocarme a este segmento en verdad veo un gran potencial, para este mercado de la mano con la ia.

Tony Te Olortegui Leon
Interesante curso