Recursos
Resumen
Saber cuándo usar Jev y cuándo no es la decisión que cierra este curso, y es relevante para cualquiera que esté construyendo clasificadores de texto sin modelos que hablan. Jev le ganó a GPT 5.6 Luna en cada prueba, pero siempre contra el mismo rival y en tareas cómodas. La pregunta interesante aparece cuando cambias de rival y de tarea.
¿Qué tan bueno es Jev cuando cambias de prueba?
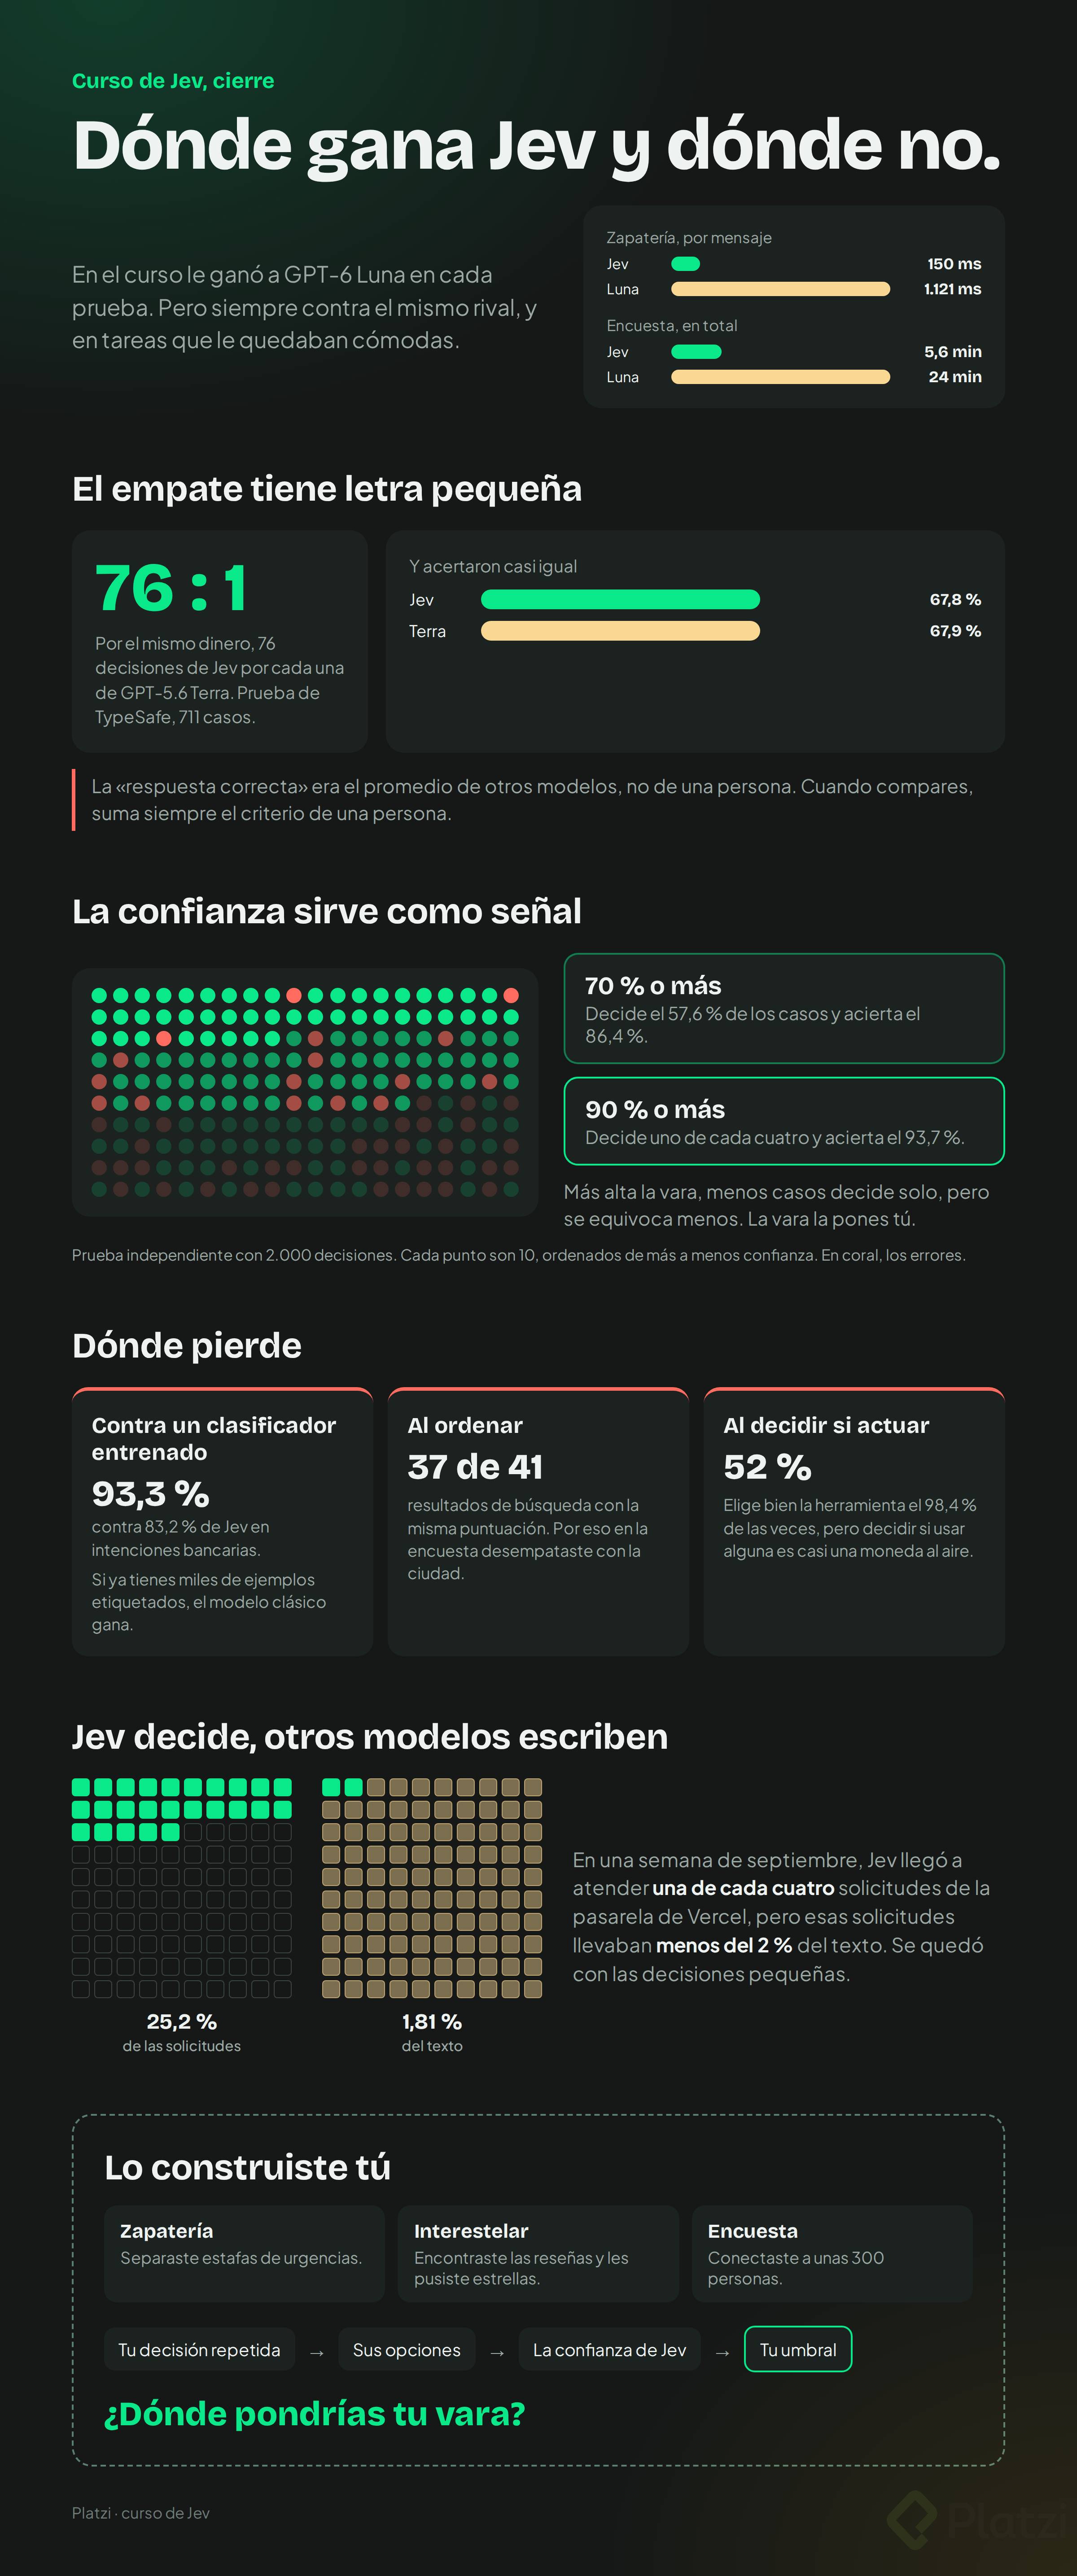
Durante el curso, Jev fue más rápido en todo. Con los 100 mensajes de la zapatería tardó 150 milisegundos por mensaje, mientras que Luna pasó de un segundo. Con la encuesta terminó en menos de seis minutos lo que a Luna le tomó 24 [00:06].
TypeSafe publicó una prueba con 711 casos. Por el mismo dinero compraste 76 decisiones de Jev por cada una de GPT 5.6 Terra, y ambas acertaron casi igual: 67.8 % contra 67.9 % [00:32]. Suena a victoria total, hasta que miras qué contaba como respuesta correcta.
Aquí viene lo interesante: la respuesta correcta no la escribió una persona. Era el promedio de lo que contestaban otros modelos. Jev solo empató en estar de acuerdo con otras máquinas, no con un humano.
¿Por qué un benchmark de IA puede engañar? Porque si la respuesta correcta es el promedio de otros modelos, solo mides acuerdo entre máquinas, no acierto real. Por eso siempre debes sumar el criterio de una persona al comparar.
¿Sirve el porcentaje de confianza de Jev como señal?
Ya sabes que ese porcentaje no es la probabilidad de acertar. Pero una prueba independiente con 2,000 decisiones muestra que sí funciona como señal de confianza [01:12].
- Cuando Jev dio 70 % o más, decidió un poco más de la mitad de los casos y acertó el 86 %.
- Cuando dio 90 % o más, decidió uno de cada cuatro casos y acertó el 93.7 %.
La lógica es clara: mientras más alta pongas la vara, menos casos decide solo, pero se equivoca menos. Y esa vara la pones tú.
Vuelve a la zapatería. Si cada mensaje urgente que se te escapa es un cliente que se va, ¿dejarías a Jev actuar solo desde 70 o desde 90? Esa decisión depende de cuánto te duele el error.
¿Desde qué nivel de confianza dejo que la IA actúe sola? Depende del costo del error. Con umbral de 70 % acierta el 86 % y cubre más casos; con 90 % acierta el 93.7 % pero decide menos. Tú eliges el balance.
¿En qué tareas Jev pierde contra otros modelos?
Hay rivales a los que Jev no les gana, y reconocerlos te ahorra trabajo. El primero es el clasificador entrenado, el modelo de machine learning clásico que costaba tanto construir [02:05].
Si ya tienes miles de ejemplos etiquetados, ese modelo clásico todavía gana. En intenciones bancarias, uno pequeño sacó 93.3 % frente al 83.2 % de Jev.
Jev también tropieza en tres situaciones concretas:
- Ordenar en vez de elegir: al ordenar 41 resultados de búsqueda, le dio la misma puntuación a 37. Por eso en la encuesta usaste la ciudad como criterio para desempatar.
- Decidir si actuar: en agentes elige la herramienta correcta el 98.4 % de las veces, pero cuando la duda es si usar alguna herramienta, acierta el 52 %, casi una moneda al aire.
- Competir contra datos etiquetados abundantes, donde el modelo entrenado sigue arriba.
La clave está en distinguir entre elegir una opción de una lista y tener que ordenar o decidir si intervenir. En lo primero Jev brilla; en lo segundo, no tanto.
¿Cómo usan las empresas un clasificador que no escribe?
Las empresas ya entendieron dónde encaja esta herramienta. En una semana de septiembre, Jev llegó a atender una de cada cuatro solicitudes de la pasarela de Vercel [03:10].
Pero esas solicitudes llevaban menos del 2 % del texto. Jev se quedó con las decisiones pequeñas, y la escritura larga siguió en otros modelos. Esa es la división natural: el clasificador decide, el modelo generativo escribe.
Este curso empezó con una pregunta rara: ¿para qué querrías una inteligencia artificial que no habla? Ya tienes la respuesta y la construiste tú.
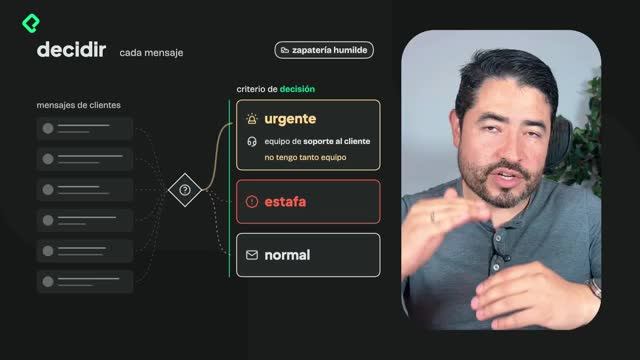
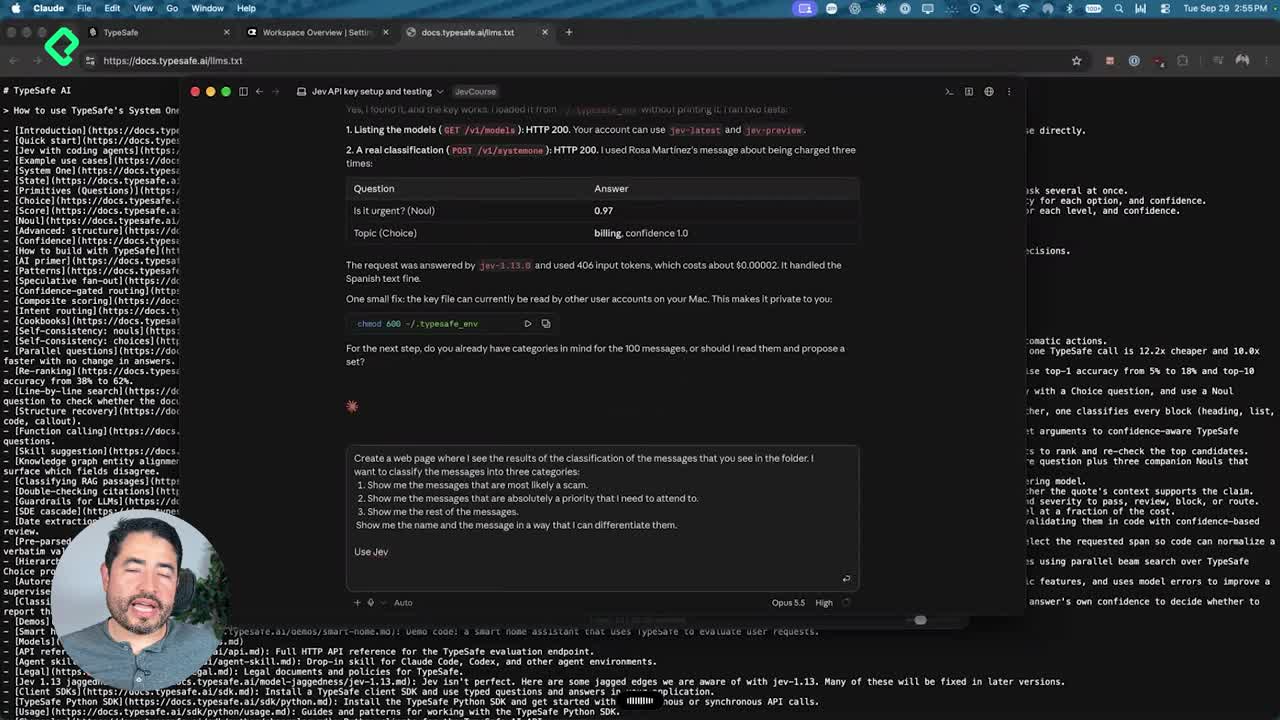
- Separaste estafas de urgencias en los mensajes de una zapatería.
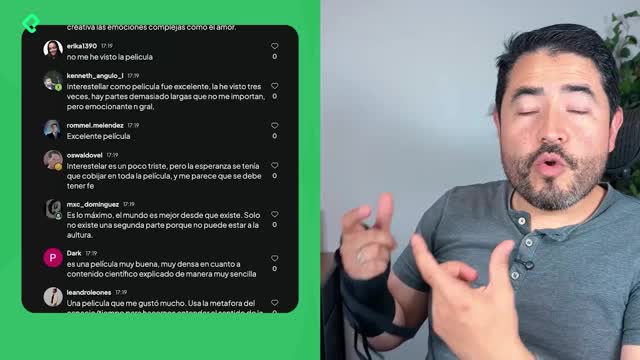
- Encontraste las reseñas de Interestelar en un chat en vivo y les pusiste estrellas.
- Conectaste a unas 300 personas de una encuesta.
Lo lograste describiendo en palabras lo que querías, con tu llave bien guardada y comparando siempre contra otro modelo. Ahora también sabes cuándo no usarlo: cuando hay que ordenar, cuando la duda es si actuar, o cuando ya tienes miles de ejemplos para entrenar un clasificador clásico.
Lo que queda es tu decisión repetida, la que anotaste en la primera clase. Escríbele sus opciones a Jev, mírale el número y decide tú desde dónde actúa solo. ¿Dónde pondrías tu vara? Cuéntalo en los comentarios.