
Las window functions no son exclusivas de SQL Server; son parte del estándar SQL (SQL:2003 en adelante), y muchos motores modernos las soportan, como:
- SQL Server ✅
- PostgreSQL ✅
- Oracle ✅
- MySQL (desde la 8.0) ✅
- MariaDB (desde 10.2) ✅
Resolver problemas analíticos complejos en SQL sin recurrir a múltiples subconsultas anidadas o CTEs encadenadas es posible gracias a las window functions. Estas funciones permiten calcular rankings, comparar periodos, obtener acumulados y porcentajes, todo dentro de una sola consulta. Dominarlas marca la diferencia entre escribir SQL operacional y SQL verdaderamente analítico.
¿Qué son las window functions y por qué reemplazan subconsultas complejas?
Una window function opera sobre un conjunto de filas relacionadas con la fila actual, pero sin colapsar el resultado como lo hace GROUP BY [0:25]. La clave está en la cláusula OVER(), que define la ventana de cálculo.
Dentro de OVER() se combinan dos elementos fundamentales:
GROUP BY pero conservando todas las filas.Esto significa que puedes asignar un ranking a cada pedido por cliente sin perder el detalle de cada fila [1:07]. Por ejemplo, al ejecutar ROW_NUMBER() OVER(PARTITION BY cliente ORDER BY fecha_pedido), cada fila recibe un número secuencial dentro de su grupo, sin que las filas se colapsen.
¿Cómo se construye un ranking por producto con OVER?
El proceso es directo: primero se crea una partición con PARTITION BY, se ordena con ORDER BY y se aplica la función de ranking [1:25]. En el ejemplo de la clase, se generan dos rankings distintos en la misma consulta: uno por número de pedido y otro por producto, ambos usando OVER(PARTITION BY ... ORDER BY ... DESC). Lo que antes requería cuatro subconsultas o varias CTEs, se resuelve con dos líneas de window functions [2:30].
Un detalle importante al trabajar en SQL Server: hay que verificar que la base de datos activa sea la correcta. Si el selector indica Master en lugar de la base deseada, la consulta fallará [2:00].
¿Cómo obtener el top tres de categorías con más pedidos?
Combinando una CTE (Common Table Expression) con una window function, el resultado es limpio y eficiente [2:50]. Se define un WITH que contiene la consulta con RANK() OVER(PARTITION BY ...), y luego se filtra con un simple SELECT donde el ranking sea menor o igual a tres. Dos pasos en lugar de múltiples subconsultas anidadas.
¿Para qué sirven las funciones LAG y LEAD en análisis temporal?
LAG accede al valor de la fila anterior y LEAD al de la fila siguiente dentro de la partición [3:30]. Si pensamos en una hoja de cálculo, LAG trae el dato de la celda de arriba y LEAD el de la celda de abajo. Su uso principal es calcular variaciones entre periodos.
El ejemplo práctico calcula el crecimiento mes a mes por país [3:55]:
LAG(ventas) OVER(PARTITION BY pais ORDER BY año, mes) se recuperan las ventas del mes anterior.Cuando no existen datos del periodo anterior, el resultado muestra NULL, lo cual es correcto y esperado [4:40].
¿Cómo calcular acumulados y porcentajes con SUM OVER?
La función SUM() OVER() permite manejar totales acumulados y globales en una misma consulta [5:15]. El ejemplo construye una tabla de frecuencia acumulada por país:
SUM(total) OVER() sin partición, que devuelve el total general.SUM(total) OVER(ORDER BY total DESC) que va sumando progresivamente.CAST para calcular la proporción acumulada [5:50].El resultado es una tabla de frecuencia acumulada que muestra cuánto representa cada país respecto al total y en qué posición del ranking se encuentra.
¿Cuál es el desafío práctico con LAG y RANK?
El reto propuesto tiene dos partes:
ROW_NUMBER o RANK para identificar los cinco mejores meses de ventas de Argentina con su posición en el ranking histórico.Comparte tu script y resultado para poner en práctica estas funciones que transforman la forma de analizar datos con SQL.
Resolver problemas analíticos complejos en SQL sin recurrir a múltiples subconsultas anidadas o CTEs encadenadas es posible gracias a las window functions. Estas funciones permiten calcular rankings, comparar periodos, obtener acumulados y porcentajes, todo dentro de una sola consulta. Dominarlas marca la diferencia entre escribir SQL operacional y SQL verdaderamente analítico.
Una window function opera sobre un conjunto de filas relacionadas con la fila actual, pero sin colapsar el resultado como lo hace GROUP BY [0:25]. La clave está en la cláusula OVER(), que define la ventana de cálculo.
Dentro de OVER() se combinan dos elementos fundamentales:
GROUP BY pero conservando todas las filas.Esto significa que puedes asignar un ranking a cada pedido por cliente sin perder el detalle de cada fila [1:07]. Por ejemplo, al ejecutar ROW_NUMBER() OVER(PARTITION BY cliente ORDER BY fecha_pedido), cada fila recibe un número secuencial dentro de su grupo, sin que las filas se colapsen.
El proceso es directo: primero se crea una partición con PARTITION BY, se ordena con ORDER BY y se aplica la función de ranking [1:25]. En el ejemplo de la clase, se generan dos rankings distintos en la misma consulta: uno por número de pedido y otro por producto, ambos usando OVER(PARTITION BY ... ORDER BY ... DESC). Lo que antes requería cuatro subconsultas o varias CTEs, se resuelve con dos líneas de window functions [2:30].
Un detalle importante al trabajar en SQL Server: hay que verificar que la base de datos activa sea la correcta. Si el selector indica Master en lugar de la base deseada, la consulta fallará [2:00].
Combinando una CTE (Common Table Expression) con una window function, el resultado es limpio y eficiente [2:50]. Se define un WITH que contiene la consulta con RANK() OVER(PARTITION BY ...), y luego se filtra con un simple SELECT donde el ranking sea menor o igual a tres. Dos pasos en lugar de múltiples subconsultas anidadas.
LAG accede al valor de la fila anterior y LEAD al de la fila siguiente dentro de la partición [3:30]. Si pensamos en una hoja de cálculo, LAG trae el dato de la celda de arriba y LEAD el de la celda de abajo. Su uso principal es calcular variaciones entre periodos.
El ejemplo práctico calcula el crecimiento mes a mes por país [3:55]:
LAG(ventas) OVER(PARTITION BY pais ORDER BY año, mes) se recuperan las ventas del mes anterior.Cuando no existen datos del periodo anterior, el resultado muestra NULL, lo cual es correcto y esperado [4:40].
La función SUM() OVER() permite manejar totales acumulados y globales en una misma consulta [5:15]. El ejemplo construye una tabla de frecuencia acumulada por país:
SUM(total) OVER() sin partición, que devuelve el total general.SUM(total) OVER(ORDER BY total DESC) que va sumando progresivamente.CAST para calcular la proporción acumulada [5:50].El resultado es una tabla de frecuencia acumulada que muestra cuánto representa cada país respecto al total y en qué posición del ranking se encuentra.
El reto propuesto tiene dos partes:
ROW_NUMBER o RANK para identificar los cinco mejores meses de ventas de Argentina con su posición en el ranking histórico.Comparte tu script y resultado para poner en práctica estas funciones que transforman la forma de analizar datos con SQL.
Las window functions no son exclusivas de SQL Server; son parte del estándar SQL (SQL:2003 en adelante), y muchos motores modernos las soportan, como:
Hola, si alguno quedo con la curiosidad al igual que yo de por que se repiten los numeros en el ranking con ROW_NUMBER es debido a que al agrupar por nombres hay varias personas llamadas igual es decir hay mas de una Agustina y mas de un Antonio, si quieren visualizar mejor el ranking pueden incluir el clienteID en el query.

Comparto resultados de usando windows function
Consulta de crecimiento mensual
WITH VentasMensuales AS (
    SELECT
        MONTH(p.FechaPedido) AS Mes,
        SUM(p.Total) AS VentasMes
    FROM Pedidos p
    INNER JOIN Clientes c
        ON p.ClienteID = c.ClienteID
    INNER JOIN Paises pa
        ON c.PaisID = pa.PaisID
    WHERE pa.NombrePais = 'Argentina'
      AND YEAR(p.FechaPedido) = 2024
    GROUP BY MONTH(p.FechaPedido)
)

SELECT
    Mes,
    VentasMes,

    LAG(VentasMes) OVER (ORDER BY Mes) AS VentasMesAnterior,
    VentasMes -
    LAG(VentasMes) OVER (ORDER BY Mes) AS DiferenciaAbsoluta,

    ROUND(
        (
            (VentasMes -
             LAG(VentasMes) OVER (ORDER BY Mes))
             * 100.0
        )
        /
        NULLIF(
            LAG(VentasMes) OVER (ORDER BY Mes),
            0
        ),
        2
    ) AS PorcentajeCrecimiento

FROM VentasMensuales
ORDER BY Mes;

Y top 5 mejores ventas en 2024 en Argentina
WITH VentasMensuales AS (
    SELECT
        MONTH(p.FechaPedido) AS Mes,
        SUM(p.Total) AS VentasMes
    FROM Pedidos p
    INNER JOIN Clientes c
        ON p.ClienteID = c.ClienteID
    INNER JOIN Paises pa
        ON c.PaisID = pa.PaisID
    WHERE pa.NombrePais = 'Argentina'
      AND YEAR(p.FechaPedido) = 2024
    GROUP BY MONTH(p.FechaPedido)
)

SELECT TOP 5
    ROW_NUMBER() OVER (
        ORDER BY VentasMes DESC
    ) AS Ranking,

    Mes,
    VentasMes

FROM VentasMensuales
ORDER BY VentasMes DESC;

WITH VentasxMes AS (
SELECT ps.NombrePais AS Pais, MONTH(p.FechaPedido) AS Mes,
		SUM ( p.Total) AS TotalVendido,
		LAG(SUM ( p.Total)) OVER ( PARTITION BY ps.NombrePais ORDER BY MONTH(p.FechaPedido)) AS MesAnterior,
		SUM (p.Total) -
		LAG(SUM ( p.Total)) OVER ( PARTITION BY ps.NombrePais ORDER BY MONTH(p.FechaPedido)) AS DiferenciaAbsoluta,
		CAST(
			(SUM (p.Total) -
			LAG(SUM ( p.Total)) OVER ( PARTITION BY ps.NombrePais ORDER BY MONTH(p.FechaPedido))) * 100.0 /
			NULLIF (LAG(SUM ( p.Total)) OVER ( PARTITION BY ps.NombrePais ORDER BY MONTH(p.FechaPedido)),
					0) AS DECIMAL(10,2)) AS CrecimientoPorcentual

FROM Pedidos p
JOIN Sucursales s ON s.SucursalID = p.SucursalID
JOIN Paises ps ON ps.PaisID = s.PaisID
WHERE ps.CodigoPais = 'AR'
	  AND p.FechaPedido >= '2024-01-01'
      AND p.FechaPedido <  '2025-01-01'
GROUP BY Ps.NombrePais, MONTH(p.FechaPedido)
),
Ranking AS(
SELECT Mes, TotalVendido, MesAnterior, DiferenciaAbsoluta, CrecimientoPorcentual,
	   ROW_NUMBER() OVER (ORDER BY TotalVendido DESC) AS Posicion
FROM VentasxMes
)
SELECT Mes, TotalVendido, MesAnterior, DiferenciaAbsoluta, CrecimientoPorcentual, Posicion
FROM Ranking
ORDER BY Mes;
GO
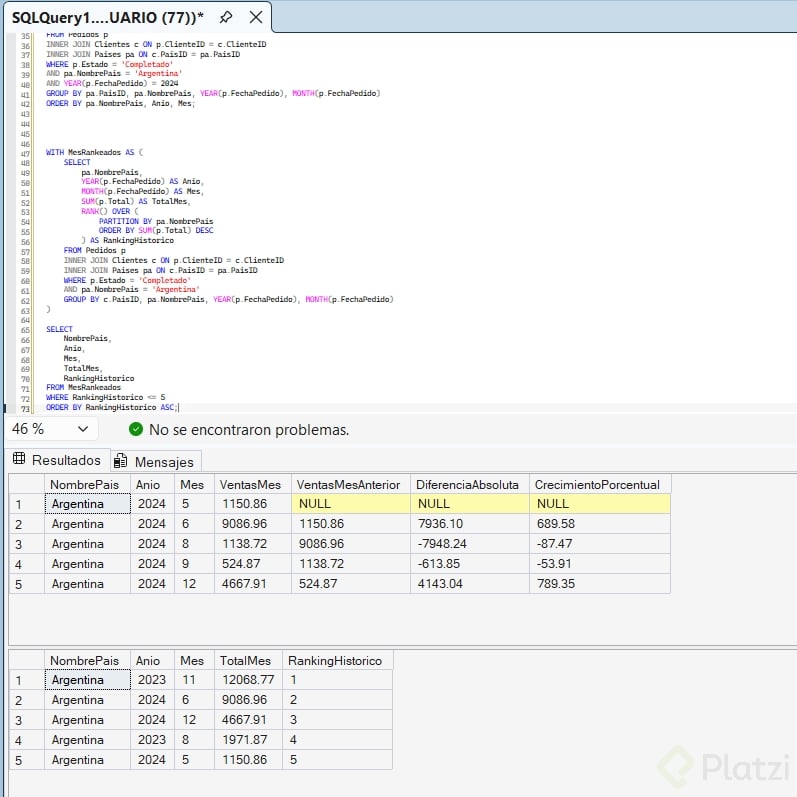
Reto: Calcula el crecimiento de ventas mes a mes para Argentina durante 2024 usando
LAG. Me guie del ejemplo de clase sin embargo cuando hay un mes vacio en la mitad no lo toma sino toma el dato del ultimo mes que registro ventas.
USE TiendaLatam;
GO


SELECT
    pa.NombrePais,
    YEAR(p.FechaPedido) AS Anio,
    MONTH(p.FechaPedido) AS Mes,
    SUM(p.Total) AS VentasMes,

    LAG(SUM(p.Total)) OVER (
        PARTITION BY pa.PaisID
        ORDER BY YEAR(p.FechaPedido), MONTH(p.FechaPedido)
    ) AS VentasMesAnterior,

    SUM(p.Total) -
    LAG(SUM(p.Total)) OVER (
        PARTITION BY pa.PaisID
        ORDER BY YEAR(p.FechaPedido), MONTH(p.FechaPedido)
    ) AS DiferenciaAbsoluta,

    CAST(
        (SUM(p.Total) -
        LAG(SUM(p.Total)) OVER (
            PARTITION BY pa.PaisID
            ORDER BY YEAR(p.FechaPedido), MONTH(p.FechaPedido)
        )) * 100.0 /

        NULLIF(
            LAG(SUM(p.Total)) OVER (
                PARTITION BY pa.PaisID
                ORDER BY YEAR(p.FechaPedido), MONTH(p.FechaPedido)
            ),
        0)

    AS DECIMAL(5,2)) AS CrecimientoPorcentual

FROM Pedidos p
INNER JOIN Clientes c ON p.ClienteID = c.ClienteID
INNER JOIN Paises pa ON c.PaisID = pa.PaisID
WHERE p.Estado = 'Completado'
AND pa.NombrePais = 'Argentina'
AND YEAR(p.FechaPedido) = 2024
GROUP BY pa.PaisID, pa.NombrePais, YEAR(p.FechaPedido), MONTH(p.FechaPedido)
ORDER BY pa.NombrePais, Anio, Mes;
2da parte ROW_NUMBER para identificar los cinco mejores meses de ventas de Argentina con su posición en el ranking histórico.
WITH MesRankeados AS (
    SELECT
        pa.NombrePais,
        YEAR(p.FechaPedido) AS Anio,
        MONTH(p.FechaPedido) AS Mes,
        SUM(p.Total) AS TotalMes,
        RANK() OVER (
            PARTITION BY pa.NombrePais
            ORDER BY SUM(p.Total) DESC
        ) AS RankingHistorico
    FROM Pedidos p
    INNER JOIN Clientes c ON p.ClienteID = c.ClienteID
    INNER JOIN Paises pa ON c.PaisID = pa.PaisID
    WHERE p.Estado = 'Completado'
    AND pa.NombrePais = 'Argentina'
    GROUP BY c.PaisID, pa.NombrePais, YEAR(p.FechaPedido), MONTH(p.FechaPedido)
)

SELECT
    NombrePais,
    Anio,
    Mes,
    TotalMes,
    RankingHistorico
FROM MesRankeados
WHERE RankingHistorico <= 5
ORDER BY RankingHistorico ASC;

Dejo por aqui un apunte de otro lado para complementar:
Son aternativa a las funciones agregadas, no agrupa el resultado (ver columna verde en el ejemplo de abajo)


Gente hola buenas noches, tardes o días. Cuando puedan pongan todo lo que hemos hecho para exportarlo en Sql, con todo lo que hemos aprendido