
Entrenamiento y evaluación de modelos de machine learning
Contenido del curso


Modelo Predictivo


Tipos de Aprendizaje
Herramientas para IA


Ciclo de Vida ML


Ética en IA


Entrenamiento y evaluación de modelos de machine learning
Entrenamiento y evaluación de modelos de machine learning
Contenido del curso
Frank Stephano Alayza Herrera

Braulio Méndez Agra
Luis Rebollo

Emiliano Van den Heuvel

José Leonardo Cuello Rugeles
Carlos Andres Prieto Garavito
Brenda Iliana Gallegos López
MARIA TERESA PANIAGUA RIVERA

Nicolas Zuleta
Erick Bryan Angulo Quintero

Creo que el dataset utilizado aquí es el incorrecto ( ) cuyo problema es que todos los hombres mueren y todas las mujeres sobreviven. Por eso da una score de 1.0 en todo incluso para una regresión de 3 iteraciones...
FYI: Usando el dataset directo de me funciono correctamente.

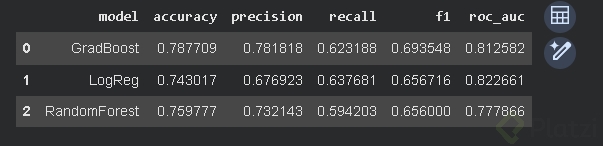
Un modelo que acierta al 100% suele ser una señal de alerta: probablemente está memorizando los datos en lugar de aprender patrones, lo que llamamos overfitting. La perfección en el entrenamiento es, irónicamente, el enemigo de la capacidad de generalización.
¿Cómo se comporta ese mismo modelo cuando le presentas datos nuevos que nunca ha visto antes?

Tengo problemas con arrastrar el archivo.
Gracias
Me gustaría saber como podemos confirmar si en este ejemplo hay riesgo de Overfitting (Sobreajuste) para los dos modelos que obtuvieron resultados de 1 para todas sus métricas. ¿Que conceptos y técnicas podríamos emplear?
