
Regresión y clasificación en machine learning
Contenido del curso


Modelo Predictivo


Tipos de Aprendizaje
Herramientas para IA


Ciclo de Vida ML


Ética en IA


Regresión y clasificación en machine learning
Regresión y clasificación en machine learning
Contenido del curso
Frank Stephano Alayza Herrera
Andrés Felipe Pinzón Cabrera
Federico Martinez

Jose Martin Rangel Espinoza

Oscar Alejandro Mercado Lamas
MARIA TERESA PANIAGUA RIVERA
Jhon Freddy Tavera Blandon
Santos Antonio Fraustro Solis
Santos Antonio Fraustro Solis
Dario Mendoza

Frank geniales tus apuntes en tu clase, me están siendo demasiado útiles !
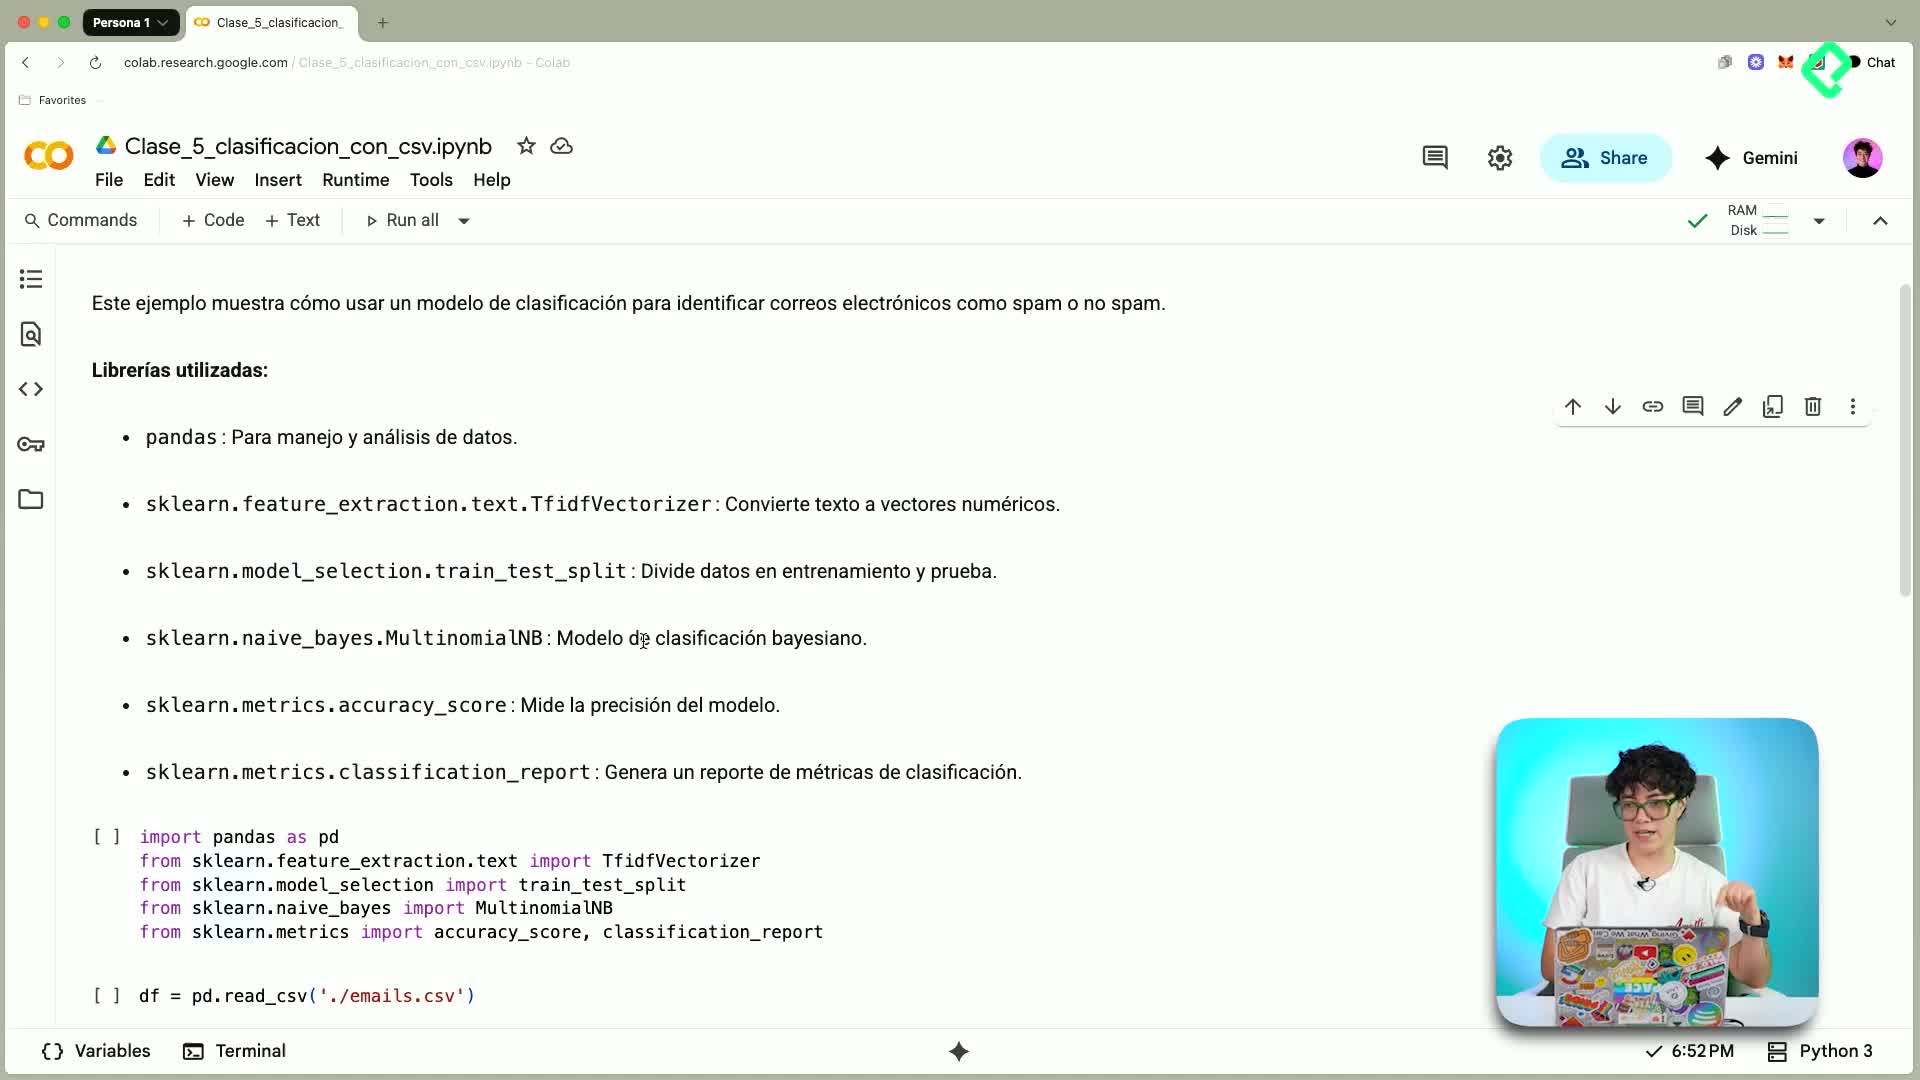
El aprendizaje supervisado en machine learning utiliza datos etiquetados para enseñar a un modelo a hacer predicciones. Se divide en dos categorías: regresión, que predice valores numéricos (como precios), y clasificación, que categoriza datos (como spam o no spam). Su eficacia depende de la calidad de los datos de entrada, ya que "garbage in, garbage out". Los algoritmos varían según el tipo de problema, utilizando regresión lineal, árboles de decisión, entre otros. La ética y el monitoreo constante son cruciales para evitar sesgos y errores en los modelos.

RegreCión ---> Regresión
Gracias

El Pionero de la Inteligencia Artificial General AGI y la Superinteligencia Validando sus Proyectos
Validando Proyecto LLM Superavanzado de Razonamiento Interno en el Perceptrón de Capas Ocultas
El aprendizaje supervisado es un tipo de machine learning que utiliza ejemplos ya etiquetados para entrenar modelos. Funciona como un maestro que guía al modelo al proporcionarle datos de entrada y las respuestas correctas. Este enfoque se divide en dos tipos de problemas: regresión, donde se predice un número (como el precio de una casa), y clasificación, donde se predice una categoría (como si un correo es spam o no). Es ampliamente utilizado en diversas industrias, desde finanzas hasta medicina, para hacer predicciones basadas en patrones en los datos.