








Creo que en esta clase hay un error en la linea 7, deberia de ser:
inicio = caracteristicaAposicion[s[fin]] + 1
De esta manera evitamos el error
Resolver el problema de Longest Substring Without Repeating Characters con Python te enseña a dominar la técnica de sliding window combinada con un hash map. Es un ejercicio clave si te preparas para entrevistas técnicas y quieres entender cómo optimizar búsquedas en cadenas a complejidad lineal.
¿Cómo se inicializan los apuntadores en sliding window?
La solución arranca declarando un apuntador inicio en cero, que marca dónde empieza el substring válido [0:31]. El segundo apuntador, el fin, no se declara como variable suelta: se integra directamente en el for que recorre el string usando enumerate, porque su único trabajo es avanzar de uno en uno.
Esta decisión hace el código más limpio. El inicio sí necesita vivir afuera porque cambia de forma condicional, mientras que fin siempre suma uno en cada iteración.
¿Qué es un sliding window en algoritmos? Es una técnica donde dos apuntadores delimitan un rango dentro de una secuencia. Ese rango se expande o contrae según las condiciones del problema, evitando recorrer la estructura múltiples veces.
¿Para qué sirve el hash map de caracteres a posición?
Se crea un diccionario llamado caracteres_a_posicion que guarda la última posición vista de cada carácter [1:30]. Si el string es a, b, c, a, cuando el recorrido llegue al índice 3, la entrada de la a se actualiza de 0 a 3.
Este mapa permite saltar el inicio directamente a la posición siguiente del duplicado, sin perder los caracteres intermedios que sí formaban un substring válido. Si solo se rompió por una letra, no tiene sentido reiniciar desde cero.
También se declara la variable mayor_longitud en cero, que va guardando el récord del substring más largo encontrado hasta el momento.
¿Cómo se mueve el apuntador inicio cuando hay un duplicado?
Dentro del ciclo se revisa el carácter actual en fin. Si ese carácter ya existe como llave en el mapa, hay un duplicado potencial y el inicio debe saltar a la posición guardada más uno.
Pero hay una trampa importante. El mapa nunca se vacía, así que puede contener llaves de substrings antiguos que ya quedaron fuera de la ventana actual. Por eso la condición real es:
inicio actual.Si la posición del duplicado es anterior al inicio, se trata de basura de un substring viejo y se ignora. Esto evita retroceder el inicio por error.
¿Cómo se actualiza la longitud máxima en cada iteración?
Después de manejar el duplicado, se actualiza el mapa con la posición actual del carácter. Luego se calcula la longitud del substring vigente con la fórmula fin - inicio + 1, que cuenta los elementos entre los dos apuntadores incluyendo el actual [5:30].
Se compara con mayor_longitud usando max() y se conserva el valor más alto. Al terminar el for, se retorna mayor_longitud.
¿Cuál es la complejidad temporal y espacial del algoritmo?
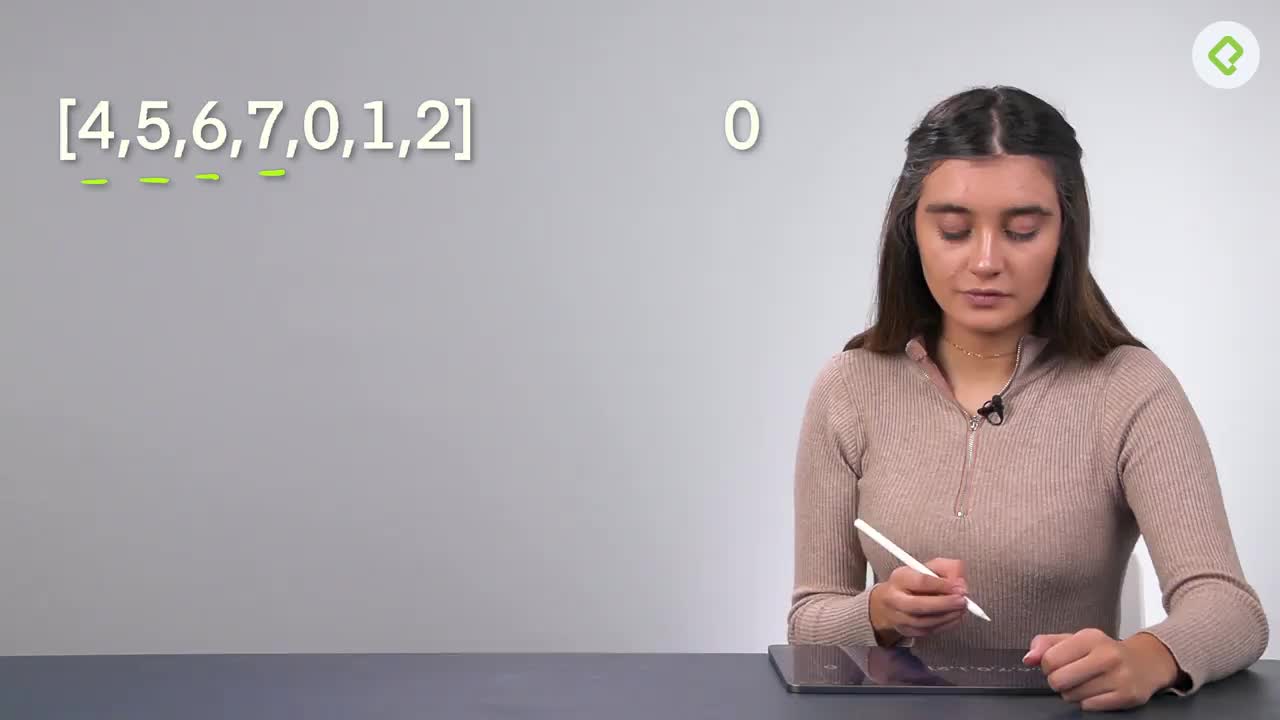
Probando con el string a, b, c, d, a, e, f con un carácter extra, el algoritmo retorna 6, que corresponde al substring más largo sin repeticiones. La traza paso a paso confirma que la lógica funciona desde la primera iteración.
¿Cuál es la complejidad de Longest Substring Without Repeating Characters? Temporal es O(n), porque recorres el string una sola vez. Espacial es O(n) si asumes alfabeto ilimitado, o O(1) si trabajas con un alfabeto fijo como las 26 letras del inglés.
La diferencia espacial depende de cómo definas el problema. Si el enunciado limita el alfabeto a un valor constante, el mapa nunca crece más allá de ese tamaño y se considera espacio constante. Si aceptas cualquier carácter Unicode, el mapa puede crecer proporcional al input.
¿Qué habilidades practicas con este ejercicio?
fin - inicio + 1 [5:30].Si te animas, comparte en los comentarios qué lenguaje elegiste tú para implementarlo y cómo manejaste la condición del duplicado fuera de la ventana.

Resolver el problema de Longest Substring Without Repeating Characters con Python te enseña a dominar la técnica de sliding window combinada con un hash map. Es un ejercicio clave si te preparas para entrevistas técnicas y quieres entender cómo optimizar búsquedas en cadenas a complejidad lineal.
La solución arranca declarando un apuntador inicio en cero, que marca dónde empieza el substring válido [0:31]. El segundo apuntador, el fin, no se declara como variable suelta: se integra directamente en el for que recorre el string usando enumerate, porque su único trabajo es avanzar de uno en uno.
Esta decisión hace el código más limpio. El inicio sí necesita vivir afuera porque cambia de forma condicional, mientras que fin siempre suma uno en cada iteración.
¿Qué es un sliding window en algoritmos? Es una técnica donde dos apuntadores delimitan un rango dentro de una secuencia. Ese rango se expande o contrae según las condiciones del problema, evitando recorrer la estructura múltiples veces.
Se crea un diccionario llamado caracteres_a_posicion que guarda la última posición vista de cada carácter [1:30]. Si el string es a, b, c, a, cuando el recorrido llegue al índice 3, la entrada de la a se actualiza de 0 a 3.
Este mapa permite saltar el inicio directamente a la posición siguiente del duplicado, sin perder los caracteres intermedios que sí formaban un substring válido. Si solo se rompió por una letra, no tiene sentido reiniciar desde cero.
También se declara la variable mayor_longitud en cero, que va guardando el récord del substring más largo encontrado hasta el momento.
Dentro del ciclo se revisa el carácter actual en fin. Si ese carácter ya existe como llave en el mapa, hay un duplicado potencial y el inicio debe saltar a la posición guardada más uno.
Pero hay una trampa importante. El mapa nunca se vacía, así que puede contener llaves de substrings antiguos que ya quedaron fuera de la ventana actual. Por eso la condición real es:
inicio actual.Si la posición del duplicado es anterior al inicio, se trata de basura de un substring viejo y se ignora. Esto evita retroceder el inicio por error.
Después de manejar el duplicado, se actualiza el mapa con la posición actual del carácter. Luego se calcula la longitud del substring vigente con la fórmula fin - inicio + 1, que cuenta los elementos entre los dos apuntadores incluyendo el actual [5:30].
Se compara con mayor_longitud usando max() y se conserva el valor más alto. Al terminar el for, se retorna mayor_longitud.
Probando con el string a, b, c, d, a, e, f con un carácter extra, el algoritmo retorna 6, que corresponde al substring más largo sin repeticiones. La traza paso a paso confirma que la lógica funciona desde la primera iteración.
¿Cuál es la complejidad de Longest Substring Without Repeating Characters? Temporal es O(n), porque recorres el string una sola vez. Espacial es O(n) si asumes alfabeto ilimitado, o O(1) si trabajas con un alfabeto fijo como las 26 letras del inglés.
La diferencia espacial depende de cómo definas el problema. Si el enunciado limita el alfabeto a un valor constante, el mapa nunca crece más allá de ese tamaño y se considera espacio constante. Si aceptas cualquier carácter Unicode, el mapa puede crecer proporcional al input.
fin - inicio + 1 [5:30].Si te animas, comparte en los comentarios qué lenguaje elegiste tú para implementarlo y cómo manejaste la condición del duplicado fuera de la ventana.
Creo que en esta clase hay un error en la linea 7, deberia de ser:
inicio = caracteristicaAposicion[s[fin]] + 1
De esta manera evitamos el error
Se me hace compleja la implementación y probablemente tenga bugs, ya que aunque se hizo una prueba de escritorio, esta se debió haber hecho para más de un ejercicio, ya que siempre puede haber edge cases que a primera vista no son muy fáciles de vislumbrar. . Aquí les dejo mi implementación (en python), me parece que es un poco más fácil de entender y fue testeado con varios edge cases, por lo que es un poco más resistente a algunos escenarios inusuales.
def get_longest_substring(s: str):
	size = len(s)
	if (size == 0):
		raise ValueError()

	p1 = 0
	p2 = 1
	longest_length = 1

	while p2 < size:
		substring = s[p1:p2]
		p2_value = s[p2]

		if p2_value in substring:
			longest_length = max(longest_length, len(substring))
			repeated_char_index = substring.index(p2_value) + 1
			p1 += repeated_char_index

		p2 += 1

	return longest_length
Que buena expicacion
Estaría bueno que al momento de explicar como va funcionando el código (que lo hace manual porque en algunas entrevistas así te lo piden) estaría más padre que usara la herramienta de debug de VS Code para ver como van cambiando los valores de las variables
Comparto la solución de la profe reparando el bug (gracias copilot) no es inicio = s[fin] + 1 sino inicio = caracteresAposicion[s[fin]] + 1 también me había pasado este error 😅 como que se confunde uno con quien itera, pero de seguro si lo hubiera ejecutado se hubiera dado cuenta.

linea 7 esta mal no? hace la prueba del algoritmo pero no en el caso en que importa que es cuando se encuentra con un repetido y se daria cuenta que esta mal
No entendí porque concateno el carácter en s[fin] + 1, para luego asignarlo al iterador inicio.
inicio = s[fin] + 1
Adjunto mi solución
    public static int LongestSubStringWithoutRepeat(string text)
    {
        var hash = new HashSet<char>();
        int count = 0;
        int max = 0;
        int p = 0;

        while (text.Length > p)
        {
            if (!hash.Contains(text[p]))
            {
                hash.Add(text[p]);
                count++;
                p++;
            }
            else
            {
                if (count > max) max = count;
                hash.Clear();
                count = 0;
            }
        }
        if (count > max) max = count;
        return max;
    }
Mi solución en Javascript: const getLongestSubstringWithoutRepeatingCharacters = (completeString) => { const stringSize = completeString.length; let leftPointer = 0, rightPointer = 0; let substringMap = new Map(); let longestSubstring = 0; while (leftPointer < (stringSize - 1)) { const letterPosition = substringMap.get(completeString[rightPointer]); const substringLength = substringMap.size; if (letterPosition) { if (substringLength > longestSubstring) longestSubstring = substringLength; substringMap.clear(); leftPointer++; rightPointer = leftPointer; continue; } substringMap.set(completeString[rightPointer], rightPointer); rightPointer++; if (rightPointer > stringSize - 1) { if (substringLength > longestSubstring) longestSubstring = substringLength; break; } } return longestSubstring;} console.log(getLongestSubstringWithoutRepeatingCharacters('abcdefe')); //6console.log(getLongestSubstringWithoutRepeatingCharacters('abcabcbb')); //3console.log(getLongestSubstringWithoutRepeatingCharacters('abcdefdhijklmnopmoj')); //12
const getLongestSubstringWithoutRepeatingCharacters = (completeString) => {
    const stringSize = completeString.length;

    let leftPointer = 0, rightPointer = 0;
    let substringMap = new Map();
    let longestSubstring = 0;

    while (leftPointer < (stringSize - 1)) {
        const letterPosition  = substringMap.get(completeString[rightPointer]);
        const substringLength = substringMap.size;

        if (letterPosition) {
            if (substringLength > longestSubstring) longestSubstring = substringLength;
            substringMap.clear();
            leftPointer++;
            rightPointer = leftPointer;
            continue;
        }

        substringMap.set(completeString[rightPointer], rightPointer);
        rightPointer++;

        if (rightPointer > stringSize - 1) {
            if (substringLength > longestSubstring) longestSubstring = substringLength;
            break;
        }
    }

    return longestSubstring;
}

console.log(getLongestSubstringWithoutRepeatingCharacters('abcdefe')); //6
console.log(getLongestSubstringWithoutRepeatingCharacters('abcabcbb')); //3
console.log(getLongestSubstringWithoutRepeatingCharacters('abcdefdhijklmnopmoj')); //12
Mi codigo en Java mostrando el total de caracteres sin repetir, y la cadena mas larga.public class LongestSubstringWithoutRepeatingCharacters { public static void main(String[] args) { String s = "abcabcfbb"; int k = s.length(); System.out.println(longestSubstringWithOnlySet(s, k)); }
private static int longestSubstringWithOnlySet(String s, int k) { Set<Character> set = new HashSet<>(); int right, result = 0; char[] arr = s.toCharArray();
StringBuilder stringBuilder = new StringBuilder(); for (right = 0; right < k; right++) { if(!(set.add(arr[right]))){ for (int i = 0; i < set.size()-1; i++) { String str = set.toString(); stringBuilder = new StringBuilder(str); } if(set.size()>result){ result = set.size(); } set.clear(); right--; } } System.out.println("The longest substring is: " + stringBuilder); return result; } }
public class LongestSubstringWithoutRepeatingCharacters {
    public static void main(String[] args) {
        String s = "abcabcfbb";
        int k = s.length();
        System.out.println(longestSubstringWithOnlySet(s, k));
    }

    private static int longestSubstringWithOnlySet(String s, int k) {
        Set<Character> set = new HashSet<>();
        int right, result = 0;
        char[] arr = s.toCharArray();

        StringBuilder stringBuilder = new StringBuilder();
        for (right = 0; right < k; right++) {
            if(!(set.add(arr[right]))){
                for (int i = 0; i < set.size()-1; i++) {
                    String str = set.toString();
                    stringBuilder = new StringBuilder(str);
                }
                if(set.size()>result){
                    result = set.size();
                }
                set.clear();
                right--;
            }
        }
        System.out.println("The longest substring is: " + stringBuilder);
        return result;
    }
}

Juan David Gaviria Agudelo
Luis Rodolfo Altuve Cáceres
Nicolas Alpargatero
Irving Juárez
Julio Serratos
Irving Juárez
Reinaldo Mendoza

Luis Antonio Ibarra Salgado
Nicolas Alpargatero

Fabian Bohorquez Heredia
Victor Alfredo Matzar Say
Nicolas Alpargatero
Luis Sandoval
Carlos Hernandez

Nicolas Lopez

Luis Alberto Ramírez Botero

Marcos Mesias

Ashley Andres Alejo Guilarte

Ivo Zayas
Emilio Sala
Martín Gutiérrez Hernández
Victor Alfredo Matzar Say

Alvaro Diego Pérez Vázquez
Christopher Andrés Guano Valencia
Ricardo Betancourt
Creo que en esta clase hay un error en la linea 7, deberia de ser:
inicio = caracteristicaAposicion[s[fin]] + 1
De esta manera evitamos el error
creo que seria equivalente a:
inicio = fin + 1
probe con algunos casos y me dio Ok
con el inicio = fin + 1 no toma no es suficiente, s = 'jdkafnlcdsalkxcmpoiuytfccv' -->14. cuando deberia ser 15
Se me hace compleja la implementación y probablemente tenga bugs, ya que aunque se hizo una prueba de escritorio, esta se debió haber hecho para más de un ejercicio, ya que siempre puede haber edge cases que a primera vista no son muy fáciles de vislumbrar. . Aquí les dejo mi implementación (en python), me parece que es un poco más fácil de entender y fue testeado con varios edge cases, por lo que es un poco más resistente a algunos escenarios inusuales.
def get_longest_substring(s: str): size = len(s) if (size == 0): raise ValueError() p1 = 0 p2 = 1 longest_length = 1 while p2 < size: substring = s[p1:p2] p2_value = s[p2] if p2_value in substring: longest_length = max(longest_length, len(substring)) repeated_char_index = substring.index(p2_value) + 1 p1 += repeated_char_index p2 += 1 return longest_length
De hecho la solucion de la profesora me parece bastabte elegante, pero creo que es cuestion de gustos
El código es elegante, pero no habla por si mismo. Probablemente tengas que pasar un rato tratando de entender que hace cada parte del código. Esto pasa porque algún string no tiene un nombre adecuado o porque simplemente no tiene nombre. Eso ayuda bastante a que alguien más (o tu yo del futuro) entienda la implementación
Que buena expicacion
Estaría bueno que al momento de explicar como va funcionando el código (que lo hace manual porque en algunas entrevistas así te lo piden) estaría más padre que usara la herramienta de debug de VS Code para ver como van cambiando los valores de las variables
Comparto la solución de la profe reparando el bug (gracias copilot) no es inicio = s[fin] + 1 sino inicio = caracteresAposicion[s[fin]] + 1 también me había pasado este error 😅 como que se confunde uno con quien itera, pero de seguro si lo hubiera ejecutado se hubiera dado cuenta.
linea 7 esta mal no? hace la prueba del algoritmo pero no en el caso en que importa que es cuando se encuentra con un repetido y se daria cuenta que esta mal
No entendí porque concateno el carácter en s[fin] + 1, para luego asignarlo al iterador inicio.
inicio = s[fin] + 1
Por si alguien mas lee esto. Creo que fue solo error de elegir el string, también me paso, pero la solución al bug es esta:
inicio = caracteresAposicion[s[fin]] + 1
Adjunto mi solución
public static int LongestSubStringWithoutRepeat(string text) { var hash = new HashSet<char>(); int count = 0; int max = 0; int p = 0; while (text.Length > p) { if (!hash.Contains(text[p])) { hash.Add(text[p]); count++; p++; } else { if (count > max) max = count; hash.Clear(); count = 0; } } if (count > max) max = count; return max; }
Mi solución en Javascript: const getLongestSubstringWithoutRepeatingCharacters = (completeString) => { const stringSize = completeString.length; let leftPointer = 0, rightPointer = 0; let substringMap = new Map(); let longestSubstring = 0; while (leftPointer < (stringSize - 1)) { const letterPosition = substringMap.get(completeString[rightPointer]); const substringLength = substringMap.size; if (letterPosition) { if (substringLength > longestSubstring) longestSubstring = substringLength; substringMap.clear(); leftPointer++; rightPointer = leftPointer; continue; } substringMap.set(completeString[rightPointer], rightPointer); rightPointer++; if (rightPointer > stringSize - 1) { if (substringLength > longestSubstring) longestSubstring = substringLength; break; } } return longestSubstring;} console.log(getLongestSubstringWithoutRepeatingCharacters('abcdefe')); //6console.log(getLongestSubstringWithoutRepeatingCharacters('abcabcbb')); //3console.log(getLongestSubstringWithoutRepeatingCharacters('abcdefdhijklmnopmoj')); //12
const getLongestSubstringWithoutRepeatingCharacters = (completeString) => { const stringSize = completeString.length; let leftPointer = 0, rightPointer = 0; let substringMap = new Map(); let longestSubstring = 0; while (leftPointer < (stringSize - 1)) { const letterPosition = substringMap.get(completeString[rightPointer]); const substringLength = substringMap.size; if (letterPosition) { if (substringLength > longestSubstring) longestSubstring = substringLength; substringMap.clear(); leftPointer++; rightPointer = leftPointer; continue; } substringMap.set(completeString[rightPointer], rightPointer); rightPointer++; if (rightPointer > stringSize - 1) { if (substringLength > longestSubstring) longestSubstring = substringLength; break; } } return longestSubstring; } console.log(getLongestSubstringWithoutRepeatingCharacters('abcdefe')); //6 console.log(getLongestSubstringWithoutRepeatingCharacters('abcabcbb')); //3 console.log(getLongestSubstringWithoutRepeatingCharacters('abcdefdhijklmnopmoj')); //12
Mi codigo en Java mostrando el total de caracteres sin repetir, y la cadena mas larga.public class LongestSubstringWithoutRepeatingCharacters { public static void main(String[] args) { String s = "abcabcfbb"; int k = s.length(); System.out.println(longestSubstringWithOnlySet(s, k)); }
private static int longestSubstringWithOnlySet(String s, int k) { Set<Character> set = new HashSet<>(); int right, result = 0; char[] arr = s.toCharArray();
StringBuilder stringBuilder = new StringBuilder(); for (right = 0; right < k; right++) { if(!(set.add(arr[right]))){ for (int i = 0; i < set.size()-1; i++) { String str = set.toString(); stringBuilder = new StringBuilder(str); } if(set.size()>result){ result = set.size(); } set.clear(); right--; } } System.out.println("The longest substring is: " + stringBuilder); return result; } }
public class LongestSubstringWithoutRepeatingCharacters { public static void main(String[] args) { String s = "abcabcfbb"; int k = s.length(); System.out.println(longestSubstringWithOnlySet(s, k)); } private static int longestSubstringWithOnlySet(String s, int k) { Set<Character> set = new HashSet<>(); int right, result = 0; char[] arr = s.toCharArray(); StringBuilder stringBuilder = new StringBuilder(); for (right = 0; right < k; right++) { if(!(set.add(arr[right]))){ for (int i = 0; i < set.size()-1; i++) { String str = set.toString(); stringBuilder = new StringBuilder(str); } if(set.size()>result){ result = set.size(); } set.clear(); right--; } } System.out.println("The longest substring is: " + stringBuilder); return result; } }
Les comparto una breve esplicaccion paso a paso:
caracteresAposicion = {} s = "abcaibe" inicio = 0 mayorLongitud = 0 for fin in range(len(s)): if s[fin] in caracteresAposicion and inicio <= caracteresAposicion[s[fin]]: print("Estamos en la condicion y se encontro: ", s[fin], " como letra repetida") print("Ahora esa letra: ", s[fin]," que tiene como valor en el diccionaro", caracteresAposicion[s[fin]], "va a tomar el valor de: ", fin) print("Y el valor de inicio es de ", caracteresAposicion[s[fin]]) print("Valores que se encuentran en el diccionario al validar la condicion", caracteresAposicion) inicio = caracteresAposicion[s[fin]] + 1 print("Este es el valor de Inicio al sumarle 1: ", inicio) caracteresAposicion[s[fin]] = fin print("Valores que se guardan en el diccionario antes y despues de pasar la condicion:", caracteresAposicion) mayorLongitud = max(mayorLongitud, fin - inicio + 1) print("la cadena con mayor longitud es de: ", mayorLongitud)
Mejore el código. El codigo es brillante, espero algún dia tener la capacidad de hacer codigos a ese nivel. Pero el codigo no es perfecto, ya que usa la función "in" y "in" hace una busqueda, osea una iteracion, si una entrada tiene miles de caracteres, el codigo se volveria muy lento y la complejidad seria O(n**). Pero yo mejore el codigo, en vez de usar "in" yo hice uso de "get()" donde su tiempo es casi O(1), pero es mucho mejor que usar "in".

Mi codigo en Java:

yo utilizo p1 para la posicion inicial y p2 el que se va moviendo.
mientras que p2 sea menor al tamaño de la cadena se seguira iterando hasta evaluar la cadena completa. se pueden apreciar las letras en la linea 20 y la cadena en la linea 21, a medida que se forma la nueva cadena se incrementa el tamaño sin incrementar el valor maximo, hasta que se ve que a la 3era iteracion (Cuando la cadena es abc) se mantiene en 3 el valor longestLent, probe agregando mas letras (d,e,f,g) despues de las primeras 3 posisicon es y funciona.
comparto mi solución con JS:
function longestSubstring(s){ let p1 = 0 p2 = p1 + 1 subString = s[p1] largestLength = 0 while(p2 < s.length) { if(subString.includes(s[p2])){ p1 = p2 p2 = p1 + 1 subString = s[p1] } else { subString = subString + s[p2] p2++ if(subString.length > largestLength){ largestLength = subString.length } } } return largestLength }
Posible solucion en python Creo que se podría mejorar si la ultima comparacion es igual a la anterior, entonces el p1 se podria actualizar a p2
def longest_substring(str): maxLength = 0 if len(str) <= 1: return len(str) #recorremos con p1 p1 = 0 while (p1 < len(str)-1): #p2 será el siguiente p2 = p1 + 1 currentDict = {} #añadimos el primer elemento currentDict[str[p1]] = 1 while p2 < len(str) and currentDict.get(str[p2]) == None: currentDict[str[p2]] = 1 p2 += 1 #print(currentDict) if p2 - p1 > maxLength: maxLength = p2 - p1 p1 = p1 +1 return maxLength
No etendia como funcionaba, pero despues de hacer varias pruebas de escritorio entendi que es lo que pensaba la maestra. Aqui esta el código en Rust !codigo en Rust
Mi solución :)
def lengthOfLongestSubstring(s): uniqueLetters = set() highestLen = 0 pointer1 = 0 pointer2 = 0 while pointer2 < len(s): if s[pointer2] in uniqueLetters: highestLen = len(uniqueLetters) if highestLen < len(uniqueLetters) else highestLen if s[pointer1] == s[pointer2]: pointer1+=1 pointer2+=1 else: uniqueLetters.remove(s[pointer1]) pointer1+=1 else: uniqueLetters.add(s[pointer2]) pointer2+=1 return highestLen
My solution with java
class Solution { public int lengthOfLongestSubstring(String s) { HashSet<Character> hash = new HashSet(); //elegimos estructura con chars únicos int biggestLength = 0; int pointerL = 0, pointerR = 0; //2 pointers (patrón ventana deslizante) while(pointerR < s.length()){ if( !hash.contains(s.charAt(pointerR)) ){//Si no existe, el char lo agrega al hash, el último pointer de la ventana lo incrementamos y actualizamos el valor max al momento hash.add(s.charAt(pointerR)); pointerR++; biggestLength = Math.max(hash.size(),biggestLength); }else{// si existe, eliminamos el char repetido e incrementamos el primer pointer de la ventana hash.remove(s.charAt(pointerL)); pointerL++; } } return biggestLength;//será la longitud mas grande registrada } }
👨💻 Solución en JavaScript / TypeScript
Utilicé un Set en lugar de un Map / diccionario. . Longest Substring Without Repeating Characters - 3 Leetcode
Mi solucion en JS
function lengthOfLongestSubstring(letras) { let maxSize = 0 ; let p1 = 0; let map = new Map(); for(let p2 = 0; p2 < letras.length; p2++ ) { const actualindex = map.get(letras[p2]) if(actualindex == undefined || actualindex < p1) { map.set(letras[p2], p2) const newMaxSize = p2 - p1 +1; if(newMaxSize > maxSize){ maxSize = newMaxSize; } } else { p1 = actualindex + 1 map.set(letras[p2],p2) } } return maxSize; }