


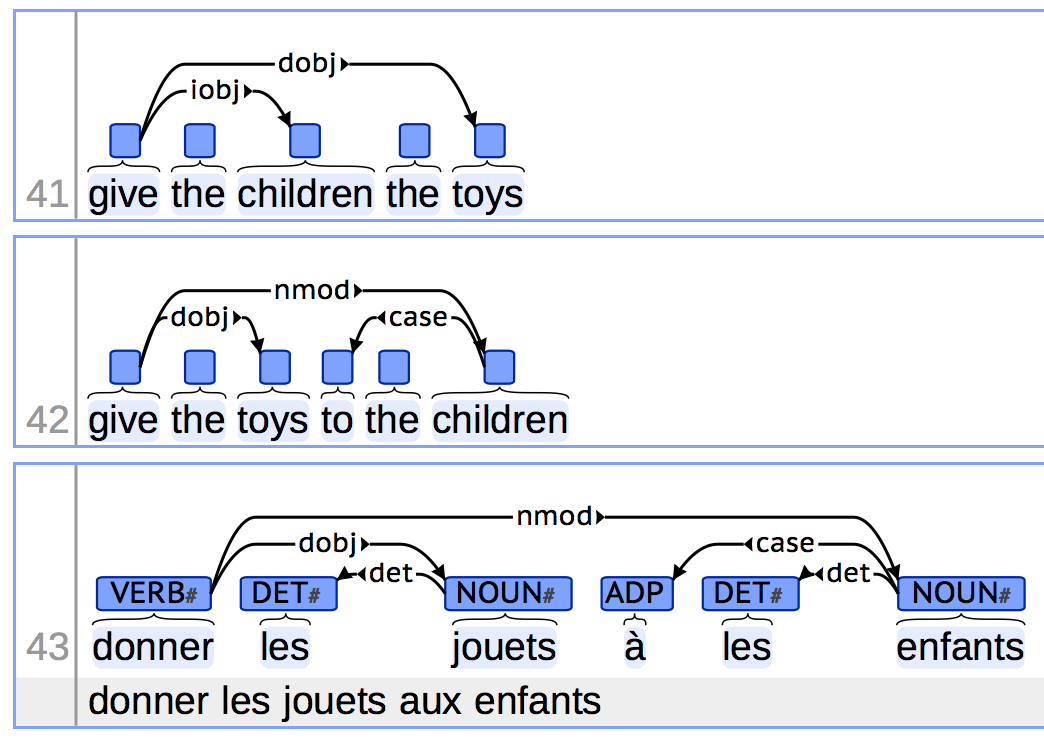
una forma más visual de ver el corpus Conllu
Transformar las fórmulas matemáticas de un modelo marcoviano latente en código funcional es uno de los pasos más satisfactorios en el aprendizaje de procesamiento del lenguaje natural. Aquí se recorre, paso a paso, cómo preparar el entorno en Google Colab, cargar un corpus real en español y extraer la estructura de datos necesaria para calcular probabilidades de transición y probabilidades de emisión.
¿Cómo preparar el entorno y cargar el corpus Áncora?
El punto de partida es un notebook de Google Colab que ya viene dividido en secciones: importación de datos, cálculo de conteos, cálculo de probabilidades y almacenamiento de parámetros del modelo [0:23]. Antes de ejecutar cualquier celda, es fundamental conectar el kernel de Python pulsando el botón de conexión en la esquina superior.
El conjunto de datos utilizado es el Corpus Áncora, un corpus en español alojado en GitHub [1:10]. Para descargarlo basta con ejecutar un git clone del repositorio. Una vez clonado, los archivos aparecen en el sistema de archivos de Colab, donde se pueden inspeccionar visualmente.
Los archivos del corpus están en formato CoNLL-U, un estándar muy extendido en tareas de procesamiento del lenguaje natural [1:22]. Python ofrece la librería conllu para manejar este formato de manera sencilla:
python pip install conllu
Además, el corpus emplea la convención UPOS (Universal Part-of-Speech), un sistema universal de etiquetas de categorías gramaticales [1:42]. El enlace al listado alfabético de estas categorías permite consultar qué representa cada etiqueta.
¿Cómo leer y explorar los datos en formato CoNLL-U?
Una vez instalada la librería, se importa la función parse_incr [2:38], que lee un archivo CoNLL-U de forma incremental y devuelve una lista de listas de tokens. El flujo básico es:
python from conllu import parse_incr
word_list = [] with open("spanish_ancora/es_ancora-ud-dev.conllu", "r", encoding="utf-8") as data_file: for token_list in parse_incr(data_file): print(token_list.serialize())
parse_incr genera cada frase tokenizada del corpus..serialize() muestra los datos de forma legible [3:30].Al ejecutar la celda, el corpus imprime frases completas. Por ejemplo: "Y piezas como mi confianza han sido fáciles de grabar, mientras que sentir me costó más" [4:00]. Para cada palabra se asigna no solo la categoría gramatical, sino también metadata adicional útil para otros análisis.
¿Qué estructura tiene un token individual?
Al seleccionar un elemento específico de token_list, se obtiene un objeto con varios atributos [4:30]:
form: la palabra tal como aparece en el texto.upos: la categoría gramatical universal (sustantivo, adjetivo, verbo, etc.).Por ejemplo, la palabra "cierto" queda etiquetada como ADJ (adjetivo) [4:52].
¿Cómo vincular cada palabra con su etiqueta gramatical?
Para preparar los conteos del modelo, se concatena la palabra con su categoría usando una barra vertical como separador [5:12]:
python token.form + "|" + token.upos
Esto produce strings como cierto|ADJ, que recuerdan la notación de una probabilidad condicional: la probabilidad de observar la palabra "cierto" dado que la categoría es "adjetivo". Esta representación es la base para calcular las probabilidades de emisión, es decir, la probabilidad de que una categoría gramatical genere una palabra concreta.
¿Cuáles son los siguientes pasos del entrenamiento?
Con los datos cargados y la estructura de tokens comprendida, el siguiente paso consiste en realizar conteos sistemáticos sobre el corpus [5:52]:
Estos conteos se transforman luego en probabilidades aplicando la regla de Bayes, tal como se explicó en la parte teórica. Finalmente, los parámetros resultantes se almacenan para que el modelo pueda etiquetar texto nuevo.
Si ya tienes tu notebook abierto y los datos cargados, comparte en los comentarios qué tamaño tiene tu corpus y cuántas categorías gramaticales distintas encuentras.
Curso de Algoritmos de Clasificación de Texto
Clase 7 / 26
Curso de Algoritmos de Clasificación de Texto
Clase 7 / 26
Transformar las fórmulas matemáticas de un modelo marcoviano latente en código funcional es uno de los pasos más satisfactorios en el aprendizaje de procesamiento del lenguaje natural. Aquí se recorre, paso a paso, cómo preparar el entorno en Google Colab, cargar un corpus real en español y extraer la estructura de datos necesaria para calcular probabilidades de transición y probabilidades de emisión.
El punto de partida es un notebook de Google Colab que ya viene dividido en secciones: importación de datos, cálculo de conteos, cálculo de probabilidades y almacenamiento de parámetros del modelo [0:23]. Antes de ejecutar cualquier celda, es fundamental conectar el kernel de Python pulsando el botón de conexión en la esquina superior.
El conjunto de datos utilizado es el Corpus Áncora, un corpus en español alojado en GitHub [1:10]. Para descargarlo basta con ejecutar un git clone del repositorio. Una vez clonado, los archivos aparecen en el sistema de archivos de Colab, donde se pueden inspeccionar visualmente.
Los archivos del corpus están en formato CoNLL-U, un estándar muy extendido en tareas de procesamiento del lenguaje natural [1:22]. Python ofrece la librería conllu para manejar este formato de manera sencilla:
python pip install conllu
Además, el corpus emplea la convención UPOS (Universal Part-of-Speech), un sistema universal de etiquetas de categorías gramaticales [1:42]. El enlace al listado alfabético de estas categorías permite consultar qué representa cada etiqueta.
Una vez instalada la librería, se importa la función parse_incr [2:38], que lee un archivo CoNLL-U de forma incremental y devuelve una lista de listas de tokens. El flujo básico es:
python from conllu import parse_incr
word_list = [] with open("spanish_ancora/es_ancora-ud-dev.conllu", "r", encoding="utf-8") as data_file: for token_list in parse_incr(data_file): print(token_list.serialize())
parse_incr genera cada frase tokenizada del corpus..serialize() muestra los datos de forma legible [3:30].Al ejecutar la celda, el corpus imprime frases completas. Por ejemplo: "Y piezas como mi confianza han sido fáciles de grabar, mientras que sentir me costó más" [4:00]. Para cada palabra se asigna no solo la categoría gramatical, sino también metadata adicional útil para otros análisis.
Al seleccionar un elemento específico de token_list, se obtiene un objeto con varios atributos [4:30]:
form: la palabra tal como aparece en el texto.upos: la categoría gramatical universal (sustantivo, adjetivo, verbo, etc.).Por ejemplo, la palabra "cierto" queda etiquetada como ADJ (adjetivo) [4:52].
Para preparar los conteos del modelo, se concatena la palabra con su categoría usando una barra vertical como separador [5:12]:
python token.form + "|" + token.upos
Esto produce strings como cierto|ADJ, que recuerdan la notación de una probabilidad condicional: la probabilidad de observar la palabra "cierto" dado que la categoría es "adjetivo". Esta representación es la base para calcular las probabilidades de emisión, es decir, la probabilidad de que una categoría gramatical genere una palabra concreta.
Con los datos cargados y la estructura de tokens comprendida, el siguiente paso consiste en realizar conteos sistemáticos sobre el corpus [5:52]:
Estos conteos se transforman luego en probabilidades aplicando la regla de Bayes, tal como se explicó en la parte teórica. Finalmente, los parámetros resultantes se almacenan para que el modelo pueda etiquetar texto nuevo.
Si ya tienes tu notebook abierto y los datos cargados, comparte en los comentarios qué tamaño tiene tu corpus y cuántas categorías gramaticales distintas encuentras.
Genial! Muy bueno ese Corpus para entrenar un buen modelo :smiley:
Excelente, que buena clase
Un modelo marcoviano latente (Hidden Markov Model) es una herramienta que representa relaciones secuenciales entre elementos. En procesamiento del lenguaje natural (PLN), sirve para analizar cómo se conectan las palabras y sus categorías gramaticales dentro de un texto.
Aprenderás a construir un modelo marcoviano latente en Python, usando Google Colab, pasando por:
1️⃣ Importar datos
2️⃣ Preparar el corpus
3️⃣ Calcular probabilidades
4️⃣ Entrenar y optimizar el modelo
🔹 Acceso a Google Colab
🔹 Kernel de Python activo
🔹 Corpus
🔹 Enlace del repositorio de GitHub
🔹 Instalar la librería Conllu
📦 Comando de instalación:
pip install conllu
Ejecuta en una celda de Colab:
!pip install conllu
!git clone <url-del-repositorio-ancora>
Pasos clave:
📜 Código ejemplo:
from conllu import parse_incr
WordList = []
with open("Spanish_Ancora/es_ancora-ud-dev.conllu", "r", encoding="utf-8") as data_file:
for token_list in parse_incr(data_file):
print(token_list.serialize())
🔎 Qué obtienes: Listas de tokens → cada una con la palabra, su categoría gramatical y metadatos adicionales.
Para explorar un token específico:
token = token_list[1]
print(f"{token['form']} | {token['upostag']}")
📘 Ejemplo de salida: habló | VERB
🧠 Esto muestra:
🧷 1. Conteo: palabras y ocurrencias condicionales
🧷 2. Probabilidades de transición: de una etiqueta a otra
🧷 3. Probabilidades de emisión: de una etiqueta a una palabra
🎯 Estas probabilidades permiten que el modelo aprenda patrones del lenguaje y prediga secuencias con coherencia.
El entrenamiento de un Modelo Oculto de Markov (HMM) involucra varias fases fundamentales que permiten ajustar los parámetros del modelo para que este sea capaz de describir un sistema oculto de manera precisa. En términos generales, el entrenamiento implica encontrar la mejor representación de los estados ocultos y las probabilidades de transición entre ellos, dadas las observaciones visibles.
El corpus AnCora viene en formato CoNLL-U y la librería conllu lo lee con una sola función, con la palabra y su etiqueta UPOS en cada token. Los formatos y convenciones estándar permiten reutilizar corpus ya etiquetados; ¿existe algo equivalente para el español de Colombia que sirva a quien analiza textos de política pública?
Algun articulo que hable sobre el modelo markoviano?
No encuentro el enlace al notebook. Me lo podrían pasar, por favor
Que buena clase, excelente!!!
Muy buena clase!