
Lucía Víctor Soto
super bien
La clave para mejorar la extracción de datos con Claude no está en el modelo, sino en el prompt que escribes. Si le pides "saca los datos" sin reglas claras, obtienes un deseo, no una instrucción. Este contenido es para quienes construyen extractores automáticos de facturas y documentos y quieren resultados confiables.
Cuando le dices a Claude que extraiga información sin especificar qué campos quieres, qué hacer con lo que falta y cómo actuar cuando el documento no es claro, terminas con datos inconsistentes. Una factura no siempre trae el IVA desglosado, ni la fecha en el mismo lugar, ni un solo total. Tu prompt tiene que saber qué hacer con todo eso antes de toparse con ello.
Por qué un mal resultado casi nunca es culpa del modelo
La mayoría de la gente cree que un mal resultado de extracción es culpa del modelo, y casi nunca lo es. Claude hace exactamente lo que le pides. El problema aparece cuando "sacar los datos" es una petición vaga en lugar de un conjunto de reglas concretas.
Lo que cambia todo es darle tres cosas claras:
Con estas tres definiciones, dejas de esperar que Claude adivine y empiezas a controlar el resultado.
¿Por qué falla la extracción de datos con IA? Casi siempre falla por un prompt sin reglas, no por el modelo. Si no defines los campos exactos y qué hacer con datos faltantes, el modelo adivina y rompe la consistencia.
Qué reglas debo agregar al prompt para obtener un JSON limpio
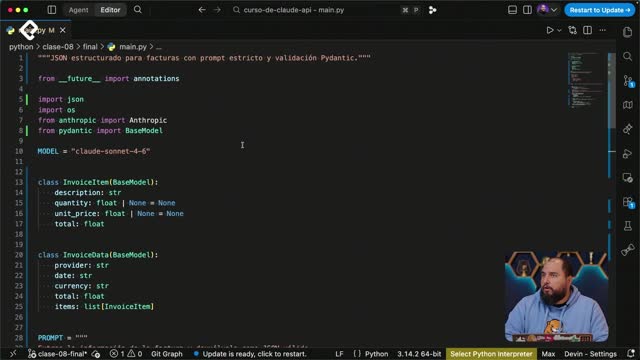
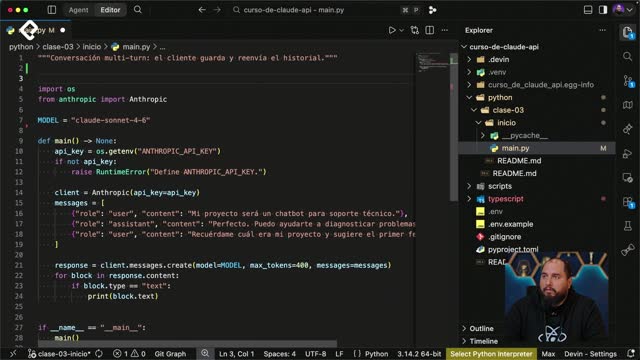
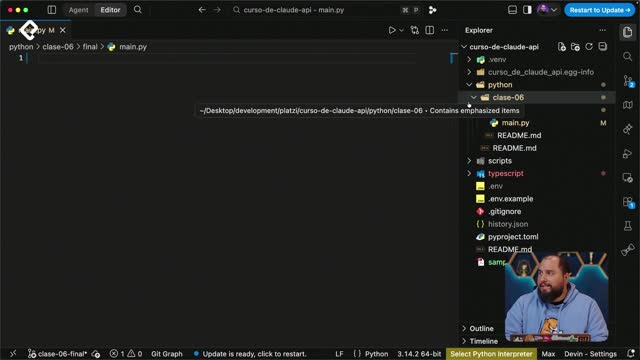
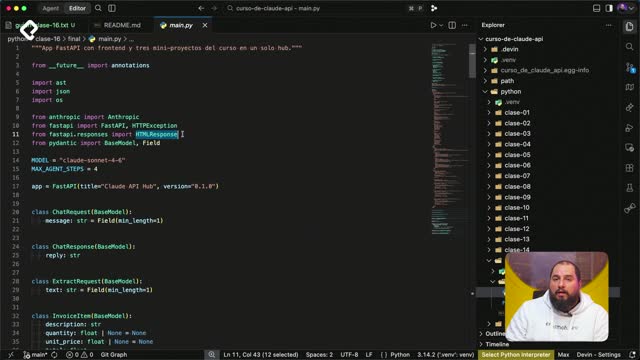
Partiendo del archivo de la clase anterior, ya obteníamos un JSON, pero necesitábamos que el prompt fuera más específico [00:42]. Al inicio del prompt se agregan dos líneas de normalización que evitan errores de formato comunes.
Las instrucciones de normalización que se añadieron son:
Después, al final del prompt se agregaron tres reglas para manejar lo que falta o no se entiende [01:20]. Estas reglas son las que evitan que el archivo se rompa al validar datos.
¿Qué debo hacer cuando un campo de la factura está vacío? Usa null o un string que diga "sin" seguido del nombre del campo, en lugar de adivinar. Así evitas valores en blanco que rompen la validación.
Cómo manejo la moneda y los impuestos separados
Las reglas para casos ambiguos quedaron así de concretas:
Con esto, cualquier valor que no exista o no se pueda leer queda controlado y no deja el archivo en blanco.
Cómo evito que Claude confunda un nombre propio con el proveedor
Aquí viene lo interesante. Al probar el código, se eliminó el nombre del proveedor del invoice text y la factura decía solo "factura emitida" con fecha y hora [02:35]. El resultado asumió que Juan Pérez era el proveedor, cuando en realidad Juan Pérez era la persona que atendió.
Al quitar también esa referencia y dejar solo "Cesde Chapinero", el código respetó la regla y marcó "sin provider", porque el campo se llama provider [03:20]. Toda la información adicional se mantuvo intacta.
Para resolver la confusión del nombre, se agregó una regla adicional: no todos los nombres propios en el contenido son un proveedor. El prompt debe verificar si es un proveedor real y, si no está seguro, respetar la regla anterior de usar null o el string con el nombre del campo [03:55]. Incluso con la frase "Atendido por Juan Pérez en la sede Chapinero", el modelo ya no lo confunde con el proveedor.
Qué pasa cuando el documento tiene muy poca información
Se probó un invoice text aún más simple, sin proveedor, sin cantidad y sin precio unitario, solo con "factura emitida", fecha, servicio y total [04:30]. El resultado respetó todas las reglas:
El modelo prefiere responder null antes que adivinar, respetando la configuración que le diste.
En qué se diferencia un extractor de datos de un chatbot
Un chatbot lo usas tú mirando la pantalla y leyendo cada respuesta. El extractor de datos trabaja distinto: nadie lo mira. Le entra un PDF, entiende y procesa los datos, y devuelve un JSON con lo necesario [05:10].
Esa información puede ir directo a una base de datos o a una hoja de cálculo sin que un humano la revise en el medio. Por eso las reglas del prompt son tan importantes: son la única garantía de calidad en un proceso automático.
El reto que se propone es claro: ya tienes el JSON al final de cada consulta, ahora haz que esos valores se agreguen directamente a una hoja de cálculo de Google Drive. Si te suena complejo, apóyate en Claude para crear el software. ¿Qué otro uso le darías a este extractor? Cuéntame en los comentarios cómo te fue con el reto.
📚 CLASE: Prompt engineering para extracción de datos (Curso de Claude API)
━━━━━━━━━━━━━━━━━━
🎯 IDEA PRINCIPAL
Diseñar reglas de prompt sólidas e inquebrantables para extraer información precisa de textos desestructurados sin inventar datos, omitir campos críticos ni generar texto de relleno.
━━━━━━━━━━━━━━━━━━
⚡ RESUMEN ULTRA RÁPIDO
🟢 Delimita explícitamente el texto de entrada usando etiquetas XML como ... para separar las instrucciones de los datos.
🔵 Define reglas claras para casos nulos o ambiguos especificando qué valor devolver cuando la información no exista (ej. null o "N/A").
🟡 Muestra ejemplos de entrada y salida mediante la técnica de few-shot prompting dentro del prompt para alinear el formato de respuesta.
🔴 Permitir que el modelo asuma o deduzca datos faltantes sin reglas explícitas genera alucinaciones en el dataset extraído.
🟢 Ordena las instrucciones principales al final del prompt o dentro del rol de sistema para maximizar la atención del modelo.
━━━━━━━━━━━━━━━━━
🔑 LO IMPORTANTE
🔵 Las etiquetas XML (, , ``) previenen inyecciones de prompt y ayudan a Claude a jerarquizar la información.
🔴 Omitir la definición estricta del manejo de errores provoca que el modelo agregue explicaciones como "No encontré el campo X" en lugar de mantener la estructura solicitada.
🟡 El patrón few-shot reduce drásticamente el margen de error en tareas de extracción complejas con campos condicionales.
━━━━━━━━━━━━━━━━━━
🧩 MODELO MENTAL
Texto Delimitado (XML) + Reglas de Campos Nulos + Ejemplos (Few-Shot) → Extracción Determinista
━━━━━━━━━━━━━━━━━━
🚀 ACCIONES PARA HOY
🟢 Envuelve la variable del texto a procesar entre etiquetas XML {texto} en tu template de prompt.
🟢 Agrega la instrucción explicita: "Si un campo no está presente en el texto, asigna el valor null. NO asumas ni inventes ningún dato."
🟢 Incluye al menos 1 o 2 ejemplos completos en el prompt usando la estructura .......
━━━━━━━━━━━━━━━━━━
🟣 VENTAJA PROFESIONAL
En pipelines de procesamiento masivo de información, un pequeño porcentaje de fallos en extracción destruye la integridad de la base de datos de destino.
🟣 Hack de optimización: Utiliza un System Prompt dedicado que restrinja el comportamiento del modelo a un analizador estricto de texto, y pasa la guía de extracción en un formato estructurado como YAML dentro del mensaje, reduciendo la ambigüedad lingüística frente al lenguaje natural común.
━━━━━━━━━━━━━━━━━━
📝 CIERRE
Un principiante redacta prompts en texto plano esperando que el modelo deduzca la intención; un profesional estructura el prompt con delimitadores XML, ejemplos few-shot y reglas explícitas para datos faltantes. Convierte tus prompts de extracción en pipelines deterministas hoy mismo.
Lucía Víctor Soto
super bien