E l rudio
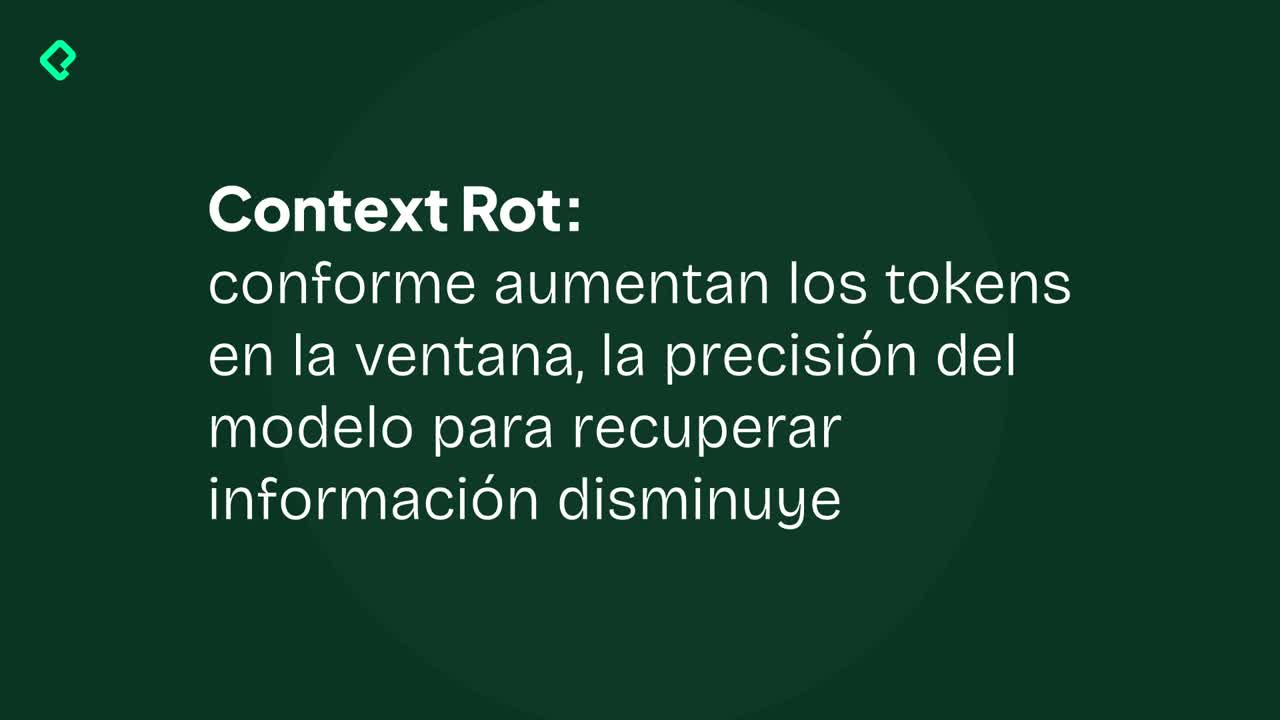
El ruido es trampa porque el modelo finge que lee todo, pero su precisión se desploma del 95% al 60% solo por meterle texto de más.
A ver cómo queda esto claro.
Los límites de contexto en herramientas de IA son ese costo invisible que nadie te explica hasta que te quedas sin cuota un jueves a las 4 de la tarde. Aquí aprenderás a diferenciar el mundo del chat del mundo de la API, cómo se consumen tus tokens y cómo calcular tu propio presupuesto de contexto. Es una lección clave si trabajas a diario con modelos como Claude y no quieres quedarte sin herramienta cuando más la necesitas.
Hay un mito que conviene desmentir de una vez: como pagas suscripción, crees que el contexto sale gratis. No sale gratis, sale caro, solo que a veces lo pagas en otra moneda. Y si no entiendes eso, un día te quedas sin acceso justo cuando lo necesitas.
Qué diferencia hay entre el chat y la API
Existen dos mundos que tendemos a mezclar y funcionan con lógicas completamente distintas [00:36].
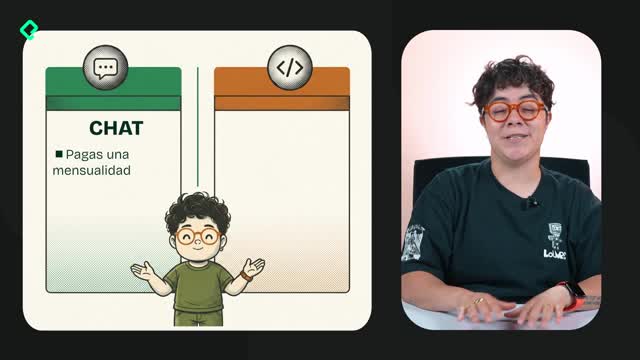
En el chat no pagas por token, pagas una mensualidad. Pero esa mensualidad tiene reglas internas:
Cuando se te acaba, el sistema te manda a esperar y no hay forma de pagar más en ese momento [01:20]. Así que la corrección no llega abriendo la cartera, llega con paciencia.
¿Por qué se me acaba tan rápido la cuota del chat? Porque las conversaciones larguísimas, los archivos pesados, los proyectos con bases de conocimiento enormes y las sesiones donde el modelo usa herramientas sin parar queman tu cuota mucho más rápido.
El mundo dos es la API, donde sí pagas por uso: por token de entrada y token de salida [01:44]. Aquí también viven los parámetros que se afinan de verdad, como el caché, el retrieval y la latencia. Es el terreno de quien construye productos.
Cuánto cuestan realmente los tokens en la API
Al momento de grabar esta lección, los precios de referencia para Claude Opus 5 sirven para dimensionar cada ajuste que hagas [02:12]. Recuerda que puedes consultar valores actualizados en el enlace de la caja de recursos.
Con estos números entiendes por qué pasar cierto umbral de tokens de entrada suele activar tarifas más altas [02:36]. Si le pides al modelo que pegue el documento completo, no solo baja la calidad, también te sale más caro. Dos golpes en una sola decisión.
¿Qué es un token de entrada frente a uno de salida? El token de entrada es lo que tú le mandas al modelo y el de salida es lo que el modelo te responde. En la API pagas por ambos por separado, y el de salida cuesta más.
Cuáles son los costos que no aparecen en la factura
Aquí viene lo interesante: hay tres costos que duelen y que nunca llegan en un correo de facturación [02:56].
Ninguno de estos tres te llega en una factura, pero los tres te están costando en tiempo, calidad y dinero.
Dónde reviso mis límites de uso
Para revisar todo lo anterior, ve a la parte inferior izquierda y da clic en uso [03:44]. Ahí aparecen tus estadísticas reales.
En el ejemplo, la sesión iba en 3%, el límite semanal en 15% con restablecimiento el viernes a las 12, y de la API se había gastado 4.56, apenas el 23% del presupuesto [04:20]. Un detalle importante: aunque le metas más dinero a los créditos, no lo puedes ocupar hasta la fecha de restablecimiento [04:52].
Cómo calculo mi presupuesto de contexto
Ese es el reto para los próximos tres días. La idea es sencilla y medible [05:04].
La corrección más efectiva suele ser la más simple: cierra el chat y empieza uno nuevo. Suena tonto, pero funciona.
Y si trabajas con la API, da un paso más: revisa si tu system prompt tiene algo que cambie en cada petición [05:40]. Ahí se te está yendo el caché por completo, y con él, tu dinero.
¿Ya identificaste a qué hora sueles quedarte sin cuota y quién es el culpable? Cuéntame en los comentarios cuál fue tu corrección más efectiva.
Los límites de contexto en herramientas de IA son ese costo invisible que nadie te explica hasta que te quedas sin cuota un jueves a las 4 de la tarde. Aquí aprenderás a diferenciar el mundo del chat del mundo de la API, cómo se consumen tus tokens y cómo calcular tu propio presupuesto de contexto. Es una lección clave si trabajas a diario con modelos como Claude y no quieres quedarte sin herramienta cuando más la necesitas.
Hay un mito que conviene desmentir de una vez: como pagas suscripción, crees que el contexto sale gratis. No sale gratis, sale caro, solo que a veces lo pagas en otra moneda. Y si no entiendes eso, un día te quedas sin acceso justo cuando lo necesitas.
Existen dos mundos que tendemos a mezclar y funcionan con lógicas completamente distintas [00:36].
En el chat no pagas por token, pagas una mensualidad. Pero esa mensualidad tiene reglas internas:
Cuando se te acaba, el sistema te manda a esperar y no hay forma de pagar más en ese momento [01:20]. Así que la corrección no llega abriendo la cartera, llega con paciencia.
¿Por qué se me acaba tan rápido la cuota del chat? Porque las conversaciones larguísimas, los archivos pesados, los proyectos con bases de conocimiento enormes y las sesiones donde el modelo usa herramientas sin parar queman tu cuota mucho más rápido.
El mundo dos es la API, donde sí pagas por uso: por token de entrada y token de salida [01:44]. Aquí también viven los parámetros que se afinan de verdad, como el caché, el retrieval y la latencia. Es el terreno de quien construye productos.
Al momento de grabar esta lección, los precios de referencia para Claude Opus 5 sirven para dimensionar cada ajuste que hagas [02:12]. Recuerda que puedes consultar valores actualizados en el enlace de la caja de recursos.
Con estos números entiendes por qué pasar cierto umbral de tokens de entrada suele activar tarifas más altas [02:36]. Si le pides al modelo que pegue el documento completo, no solo baja la calidad, también te sale más caro. Dos golpes en una sola decisión.
¿Qué es un token de entrada frente a uno de salida? El token de entrada es lo que tú le mandas al modelo y el de salida es lo que el modelo te responde. En la API pagas por ambos por separado, y el de salida cuesta más.
Aquí viene lo interesante: hay tres costos que duelen y que nunca llegan en un correo de facturación [02:56].
Ninguno de estos tres te llega en una factura, pero los tres te están costando en tiempo, calidad y dinero.
Para revisar todo lo anterior, ve a la parte inferior izquierda y da clic en uso [03:44]. Ahí aparecen tus estadísticas reales.
En el ejemplo, la sesión iba en 3%, el límite semanal en 15% con restablecimiento el viernes a las 12, y de la API se había gastado 4.56, apenas el 23% del presupuesto [04:20]. Un detalle importante: aunque le metas más dinero a los créditos, no lo puedes ocupar hasta la fecha de restablecimiento [04:52].
Ese es el reto para los próximos tres días. La idea es sencilla y medible [05:04].
La corrección más efectiva suele ser la más simple: cierra el chat y empieza uno nuevo. Suena tonto, pero funciona.
Y si trabajas con la API, da un paso más: revisa si tu system prompt tiene algo que cambie en cada petición [05:40]. Ahí se te está yendo el caché por completo, y con él, tu dinero.
¿Ya identificaste a qué hora sueles quedarte sin cuota y quién es el culpable? Cuéntame en los comentarios cuál fue tu corrección más efectiva.
E l rudio
El ruido es trampa porque el modelo finge que lee todo, pero su precisión se desploma del 95% al 60% solo por meterle texto de más.
A ver cómo queda esto claro.
Excelente la clase nos ayuda bastante a reforzar nuestros conocimientos.
Se supone que el curso es de Context Engineering, pero parece que esta todo enfocado en claude
Si tengo una session que me puede tomar dias, puedo entonces tener un archivo de memoria , en este caso seria el memory.md?
Y alli decirle que guarde lo mas relevante y una especie de checklist de lo que termine y lo que no, y luego decirle a mi IA de preferencia(CLaudio por ejemplo), que vaya y lo busque al dia siguiente, asi podria cerrar la session y no estarla dejando abierta tantos dias?
En https://models.dev encuentran precios actualizados de todos los modelos según el provider.
Una mensualidad fija pone en cero el precio de cada mensaje adicional, y con precio marginal cero se consume sin mirar, como en una casa sin medidor de agua que paga lo mismo gaste lo que gaste. Por eso los acueductos insisten en la micromedición: el contador no cambia la tarifa, pero vuelve visible el consumo. De ahí que el reto de la clase sea una lectura de medidor, es decir, anotar a qué hora se agotó la cuota y qué se estaba haciendo. Además, el panel de «Uso» ya es ese contador: conviene leerlo cuando marca 15 % y no el jueves a las 4:00 p. m.
- En el chat se paga con una mensualidad sujeta a una ventana rodante de horas y un tope semanal; cuando se agota, no hay forma de pagar más hasta que se restablezca.
- En la API se paga por token de entrada y de salida por separado, siendo el de salida más costoso, con precios de referencia que conviene consultar actualizados.
- Existen tres costos ocultos que no aparecen en ninguna factura: mayor latencia, pérdida de precisión (ruido) y peor desempeño por exceso de herramientas (confusión).
- Dentro de la aplicación se puede revisar el uso real: sesión actual, límites semanales por modelo y créditos disponibles de la API.
- La corrección más simple y efectiva para no quedarse sin cuota suele ser cerrar una conversación larga y abrir una nueva.
Los tokens representan el espacio que utiliza un modelo de IA para procesar tanto lo que recibe como lo que genera. Entender cómo se consumen ayuda a evitar conversaciones lentas, pérdida de contexto y agotamiento prematuro de los límites de uso.
La primera distinción necesaria es entre chat y API. En el chat normalmente se trabaja mediante una suscripción con límites de uso definidos por el producto. En la API, en cambio, el consumo se calcula directamente a partir de los tokens de entrada y salida, por lo que cada decisión sobre cuánto contexto enviar tiene un impacto más visible en el costo.
Pero el problema no es solamente económico. Un contexto excesivamente grande puede generar tres efectos adicionales: mayor latencia, más ruido y mayor posibilidad de confusión. Cargar documentos completos, mantener conversaciones demasiado extensas o disponer de muchas herramientas que rara vez se utilizan puede reducir la eficiencia del modelo.
Por ello, conviene pensar en un presupuesto de contexto. Algunas prácticas útiles son iniciar una nueva conversación cuando el historial ya no aporta valor, evitar pegar archivos completos si solo se necesita una sección, recuperar información únicamente cuando haga falta y mantener estables las partes reutilizables del contexto para aprovechar mecanismos como el caché.
La idea principal es sencilla: más contexto no significa necesariamente mejores respuestas. Administrar correctamente los tokens implica seleccionar qué información merece permanecer disponible y eliminar aquello que solo consume espacio sin modificar la decisión del modelo.
Una buena pregunta de autoevaluación sería: ¿qué parte de mis conversaciones, documentos o instrucciones está consumiendo contexto sin mejorar realmente la respuesta de la IA?