





Ian Cristian Ariel Yané
A alguien mas le aparece este error?:
- AttributeError: 'DataFrame' object has no attribute 'complete'
# Rellena los datos faltantes que le indiquemos ( implicit_to_explicit_df # janitor .complete( "name", "time" ) )

# limitar los datos que quieres mostrar ( implicit_to_explicit_df .complete( # formato diccionario con as variables y valores a mostrar {'name': ['lynn', 'zelda']}, {'time': ['morning', 'afternoon']}, sort=True # ordena los valores de manera que primero muestra los pasados y luego el resto ) )

( implicit_to_explicit_df .complete( 'name', 'time', fill_value= np.nan # puedes asignar el valor que desees. Por defecto asigna nan ) )

( implicit_to_explicit_df .complete( 'name', 'time', fill_value=0, explicit=False ) )

La librería de Janitor es una librería de Python que proporciona un conjunto de funciones útiles para limpiar y preparar datos en Pandas. Esta biblioteca está diseñada para ayudar en la preparación de datos para el análisis, lo que puede ahorrar tiempo y reducir errores. Algunas de las funciones más utilizadas de Janitor en Pandas incluyen.
clean_names(): esta función se utiliza para limpiar y estandarizar los nombres de las columnas en un DataFrame. Elimina espacios, caracteres especiales y convierte los nombres de las columnas a minúsculas.
remove_empty() y remove_na(): estas funciones se utilizan para eliminar filas y columnas que contengan valores faltantes o nulos.
coalesce(): esta función se utiliza para reemplazar los valores nulos o faltantes en una columna con otro valor especificado.
expand_column(): esta función se utiliza para dividir una columna en múltiples columnas utilizando un separador específico.
get_dupes(): esta función se utiliza para identificar filas duplicadas en un DataFrame.
- **groupby_summarize():** esta función se utiliza para agrupar los datos en un DataFrame y calcular estadísticas resumidas, como la media, la suma o la desviación estándar.
- **pivot_longer() y pivot_wider():** estas funciones se utilizan para transformar un DataFrame de formato ancho a formato largo o viceversa.
En resumen, la librería de Janitor es una herramienta útil para preparar y limpiar datos en Pandas. Sus funciones son útiles para estandarizar nombres de columnas, eliminar filas y columnas con valores faltantes, identificar filas duplicadas y realizar transformaciones de formato en los datos.
Ian Cristian Ariel Yané
A alguien mas le aparece este error?:

Jeinfferson Bernal G
Muy interesante la clase y la libreria janitor
Mauricio Escobar
Mauricio Escobar
Ok, va el resultado otra vez:


Nixon Rolando García Ramírez
Bueno, no se si lo que voy a comentar es de conocimiento general, pero yo estoy usando pycharm y para instalarlo realize el siguiente codigo en conda:
conda install pyjanitor -c conda-forge
Y con pip (ambientes virtuales ) es con:
pip3 install pyjanitor
Siendo mi error que escribir janitor como si ese fuera el nombre del paquete porque cuando uno lo importa lo importa como:
import janitor
Luis Miguel Rodríguez
¿Cómo expongo filas faltantes en Pandas?
La forma más efectiva es utilizar el método reindex() o crear un rango completo de valores base (como pd.date_range para fechas) y hacer un merge con tu DataFrame original. Esto generará las filas que faltaban y asignará automáticamente valores nulos a las columnas correspondientes. También puedes usar asfreq() si trabajas directamente con índices de series temporales.

Mario Alexander Vargas Celis
Pablo Alejandro Figueroa
genial!
Nestor Colmenarez
🙋♂️Si tienes problemas importando alguna de las librerias, te recomiendo leer este aporte hecho en una clase anterior:
Julián Cárdenas
Limitar el rellenado de valores faltantes implícitos
( implicit_to_explicit_df .complete( {"name": ["lynn", "zelda"]}, {"time": ["morning", "afternoon"]}, sort = True ) )
( implicit_to_explicit_df .complete( "name", "time", fill_value= "nan" ) )
( implicit_to_explicit_df .complete( "name", "time", fill_value= 99, explicit=False ) )
En mi caso para hacerlo más interesante, quise rellenar los nulos en función de los patrones observados en el dataframe:

#df_pivoted = df_botw_explicit.pivot(index='name', columns='time', values='power').reset_index() def fill_power(row): if pd.notna(row['morning']): if pd.isna(row['afternoon']): row['afternoon'] = row['morning'] - 40 if pd.isna(row['night']): row['night'] = row['afternoon'] - 40 if pd.notna(row['afternoon']): if pd.isna(row['morning']): row['morning'] = row['afternoon'] + 40 if pd.isna(row['night']): row['night'] = row['afternoon'] - 40 if pd.notna(row['night']): if pd.isna(row['afternoon']): row['afternoon'] = row['night'] + 40 if pd.isna(row['morning']): row['morning'] = row['afternoon'] + 40 return row df_fill = df_pivoted.apply(fill_power, axis= 1) df_complete = df_fill.melt(id_vars= ['name'], value_vars= ['morning', 'afternoon', 'night'], var_name= 'time', value_name= 'power') df_complete = df_complete.sort_values(by= ['name', 'time']).reset_index(drop= True) ```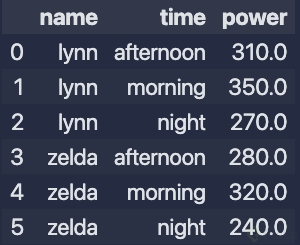
**Exponer filas faltantes implícitas en explícitas** se refiere a identificar y hacer explícitas las filas que, aunque no tengan valores NaN visibles, están incompletas o contienen información que representa datos faltantes de forma implícita. Este tipo de situación ocurre cuando ciertos valores tienen un significado especial que indica una ausencia de datos, o cuando una combinación de valores sugiere que faltan datos.
### Proceso para exponer filas faltantes implícitas en explícitas:
1. **Identificación de filas faltantes implícitas:**
Las filas que contienen valores implícitos faltantes suelen tener valores como 0, -1, o cadenas vacías (''). Estas filas pueden necesitar ser convertidas en explícitas.
2. **Uso de mask() o apply() para detectar condiciones implícitas:**
Si sabes qué condiciones representan datos faltantes, puedes usar estas funciones para transformar los datos y hacer los valores explícitos (NaN).
3. **Crear nuevas filas o marcar datos incompletos con NaN:**
Utilizando mask(), apply(), o replace() para convertir esas filas implícitas en explícitas, reemplazando valores o filas enteras con NaN.
### Ejemplo práctico:
Supongamos que tienes un DataFrame donde los valores faltantes están representados de forma implícita, como valores 0 o -1 en la columna de precios o productos vacíos.
import pandas as pd import numpy as np \# Ejemplo de DataFrame con valores faltantes implícitos data = {'Producto': \['A', 'B', 'C', 'D', 'E'],   'Cantidad': \[10, 0, 5, -1, 8],   'Precio': \[100, 0, -1, 150, 0]} df = pd.DataFrame(data) print("DataFrame original:") print(df) \# Definir condiciones implícitas para filas faltantes \# Suponemos que 'Cantidad' o 'Precio' con 0 o -1 representan valores faltantes df\_masked = df.mask((df\['Cantidad'] <= 0) | (df\['Precio'] <= 0)) print("\nDataFrame con filas faltantes explícitas:") print(df\_masked)
### Salida esperada:
DataFrame original:   Producto Cantidad Precio 0 A 10 100 1 B 0 0 2 C 5 -1 3 D -1 150 4 E 8 0 DataFrame con filas faltantes explícitas:   Producto Cantidad Precio 0 A 10.0 100.0 1 B NaN NaN 2 C 5.0 NaN 3 D NaN 150.0 4 E 8.0 NaN
### Explicación:
1. **Identificación de valores implícitos:** Hemos definido que los valores 0 o -1 en las columnas Cantidad y Precio son faltantes de forma implícita.
2. **Uso de mask():** La función mask() aplica la condición y reemplaza los valores que cumplen con NaN.
3. **Exposición explícita:** Ahora, los valores que estaban implícitamente faltantes (como 0 o -1) se muestran como NaN, haciendo evidente qué datos están faltando.
### Resumen de técnicas para identificar y exponer filas faltantes implícitas:
- **mask()**: Para identificar y reemplazar valores que cumplen con una condición específica.
- **apply()**: Para aplicar una función personalizada fila por fila para determinar si una fila es faltante de forma implícita.
- **replace()**: Para reemplazar valores específicos en el DataFrame.
- **isnull() y notnull()**: Para comprobar si los datos contienen valores explícitamente faltantes.
Este proceso facilita el análisis posterior y asegura que las técnicas para manejar datos faltantes se apliquen correctamente.