





Alfonso Andres Zapata Guzman
Fernando Jesús Núñez Valdez
Marco Antonio Candia Ortega
Codigo de la grafica de dos variables con valores faltantes
( riskfactors_df .select_dtypes( exclude='category' # excluye las variables categoricas ) .pipe( lambda df: df[df.columns[df.isna().any()]] #seleccionar solo columnas que tengan valores faltantes ) .missing.bind_shadow_matrix(true_string = True, false_string = False) .apply( lambda column: column if '_NA' in column.name else column_fill_with_dummies(column, proportion_below=0.05, jitter=0.075) ) .assign( nullity = lambda df: df.weight_lbs_NA | df.height_inch_NA ) .pipe( lambda df: ( sns.scatterplot( data = df, x='weight_lbs', y= 'height_inch', hue='nullity' ) ) ) )

Alfonso Andres Zapata Guzman
Fernando Jesús Núñez Valdez
Marco Antonio Candia Ortega

Jhampyer Daniel Hernández Naguas
No entendi nada jajaja

Jonatan David Acevedo Lopez

Roy Q
Marco Antonio Candia Ortega
Mercedes Jue
Vengo siguiendo la ruta de data science y las últimas dos clases me fulminaron, el código es demasiado complejo y no lo explica bien :(
Diego Cesar Lerma Torres

Mario Alexander Vargas Celis
Para crear un **scatterplot** (gráfico de dispersión) que visualice los valores faltantes en un conjunto de datos, puedes aprovechar la capacidad de **Seaborn** o **Matplotlib** para resaltar los puntos con valores faltantes. Puedes usar diferentes colores o símbolos para mostrar si los puntos tienen valores faltantes o no.
Aquí tienes un ejemplo usando Seaborn para crear un gráfico de dispersión que destaque los valores faltantes:
### Ejemplo de Scatterplot con Valores Faltantes
import pandas as pd import seaborn as sns import matplotlib.pyplot as plt \# Crear un DataFrame de ejemplo con algunos valores faltantes data = {'Variable1': \[1, 2, None, 4, 5, 6, None, 8, 9, 10],   'Variable2': \[5, None, 7, 8, 9, 10, None, 12, 13, 14]} df = pd.DataFrame(data) \# Crear una nueva columna que indique si hay valores faltantes en alguna de las variables df\['missing'] = df.isnull().any(axis=1) \# Visualización con un scatterplot, donde los puntos faltantes se destacan por el color plt.figure(figsize=(8, 6)) sns.scatterplot(x='Variable1', y='Variable2', hue='missing', style='missing', data=df, palette='coolwarm', s=100) plt.title('Scatterplot con Valores Faltantes Destacados') plt.xlabel('Variable 1') plt.ylabel('Variable 2') plt.show()
### Explicación:
- **hue='missing'**: Colorea los puntos basados en si tienen valores faltantes o no.
- **style='missing'**: Cambia el estilo del marcador para diferenciar visualmente los valores faltantes (puedes usar formas diferentes para los puntos que tienen valores faltantes).
- **palette='coolwarm'**: Proporciona una paleta de colores para diferenciar claramente los puntos que tienen o no valores faltantes.
- **s=100**: Ajusta el tamaño de los puntos para que sean más visibles.
### Variaciones:
Si quieres agregar etiquetas adicionales o cambiar el estilo del gráfico, puedes usar las opciones de **Seaborn** y **Matplotlib** para personalizar colores, tamaños de puntos o títulos.
Este scatterplot te ayudará a visualizar cómo los valores faltantes afectan la relación entre dos variables.
Emmanuel Guerra Sánchez
Cuando hablamos de valores faltantes nos importa que en algún momento logremos preservar su estructura y sus relaciones

Antonio Demarco Bonino
Le agregué dos líneas negras para marcar los ejes:
( riskfactors_df .select_dtypes( exclude="category" ) .pipe( lambda df: df[df.columns[df.isna().any()]] ) .missing.bind_shadow_matrix(true_string = True, false_string = False) .apply( lambda column: column if "_NA" in column.name else column_fill_with_dummies(column, proportion_below=0.05, jitter=0.075) ) .assign( nullity = lambda df: df.weight_lbs_NA | df.height_inch_NA ) .pipe(lambda df: (sns.scatterplot(data = df, x='weight_lbs', y= 'height_inch', hue='nullity'))) ) plt.axhline(0, color='black', linewidth=1) plt.axvline(0, color='black', linewidth=1) plt.show() ```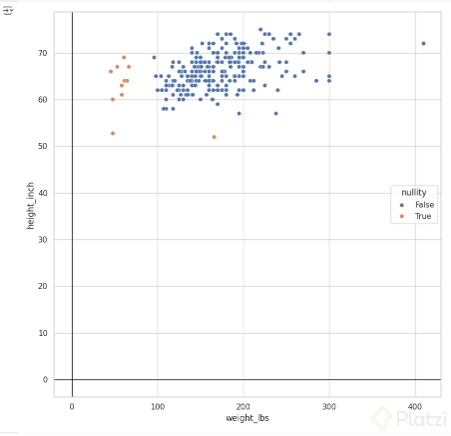

Pável Hernández Reza
Añadida la extensión. Pueden ver el código directamente en el repositorio:

Pablo Alejandro Figueroa
genial..!

José Pablo Cabrera Romo
Mi codigo del reto:
def missing_values_for_2variables_scatterplot( df: pd.DataFrame, x: str, y: str ): scatterplot = ( df .select_dtypes( exclude="category" ) .pipe( lambda df: df[df.columns[df.isna().any()]] ) .missing .bind_shadow_matrix(true_string = True, false_string = False) .apply( lambda column : column if "_NA" in column.name else column_fill_with_dummies(column, proportion_below=0.05, jitter= 0.075) ) .assign( Nullity = lambda df: df[f"{x}_NA"] | df[f"{y}_NA"] ) .pipe( lambda df: sns.scatterplot( data = df, x = x, y = y, hue = "Nullity" ) ) ) return scatterplot missing_values_for_2variables_scatterplot(riskfactors_df, x = "weight_lbs", y = "height_inch")

Nelson Mauricio Bravo Caballero
Esta es mi funcion en pandas-missing-extension.ipynb:
def missing_fill_with_dumies_scatterplot( self, col1, col2, proportion_below:0.05, jitter:0.050, seed: int=42): ( self._pd_obj.select_dtypes( exclude="category" ) .pipe( lambda df: df[df.columns[df.isna().any()]] ) .missing.bind_shadow_matrix(true_string = True, false_string = False) .apply( lambda column: column if "_NA" in column.name else column_fill_with_dumies(column, proportion_below, jitter, seed) ) .assign( nullity = lambda df: df.weight_lbs_NA | df.height_inch_NA ) .pipe( lambda df:( sns.scatterplot( data= df, x=col1, y=col2, hue="nullity" ) ) ) )
Julián Cárdenas
plt.figure(figsize=(10, 10)) ( riskfactors_df .select_dtypes( exclude="category" ) .pipe( lambda df: df[df.columns[df.isna().any()]] ) .missing.bind_shadow_matrix(true_string=True, false_string=False) .apply( lambda column: column if "_NA" in column.name else column_fill_with_dummies(column, proportion_below=0.05, jitter=0.075) ) .assign( nullity=lambda df: df.weight_lbs_NA | df.height_inch_NA ) .pipe( lambda df: ( sns.scatterplot( data=df, x="weight_lbs", y="height_inch", hue="nullity" ) ) ) )

Bryan David Vasquez Paz
María José Medina

Mario Chavez

Bryan Carvajal
He logrado llevar crear el metodo en la clase missing y agregar la funcion column_fill_with_dummies en utils.py

( riskfactors_df .missing.missing_scatterplot_with_dummies( columns_NA1='weight_lbs_NA', columns_NA2='height_inch_NA', x='weight_lbs', y='height_inch' ) )
Colocar esto en el area del archivo para extender las funciones:
#metodo para obtener relleno de columna con dummies, para usar en funcion de scatterplot def column_fill_with_dummies( self, column: pd.Series, proportion_below: float=0.10, jitter: float=0.075, seed: int=42 ) -> pd.Series: column = column.copy(deep=True) # Extract values metadata. missing_mask = column.isna() number_missing_values = missing_mask.sum() column_range = column.max() - column.min() # Shift data column_shift = column.min() - column.min() * proportion_below # Create the "jitter" (noise) to be added around the points. np.random.seed(seed) column_jitter = (np.random.rand(number_missing_values) - 2) * column_range * jitter # Save new dummy data. column[missing_mask] = column_shift + column_jitter return column
Y la parte importante:
#metodo para visualizar valores NA y !NA desde una tabla a la que se relleno con dummies def missing_scatterplot_with_dummies( self, columns_NA1, columns_NA2, x, y ): return ( self._obj .select_dtypes( exclude="category" ) .pipe( lambda df: df[df.columns[df.isna().any()]] ) .missing.bind_shadow_matrix(true_string=True, false_string=False) .apply( lambda column: column if "_NA" in column.name else self.column_fill_with_dummies(column, proportion_below=0.05, jitter=0.075) ) .assign( nullity=lambda df: df[columns_NA1] | df[columns_NA2] ) .pipe( lambda df: ( sns.scatterplot( data=df, x=x, y=y, hue="nullity" ) ) ) )
Solo le realice una pequeña reducción a la función, ahora ya simplemente toma las 2 variables y no todo el dataset para realizar lo del bind shadow matrix (y ni hacer la exclusion de las categoricas, aunque seria bueno crear un try, except para solo aceptar las numericas), y tambien ya solamente recibe 2 parametros (var1, var2).
def missing_scatter_nullity_plot(self, var1: str, var2: str): """Plot a scatterplot with 2 numeric variables""" return ( # Just taking the 2 variables and not the whole dataset self._obj[[var1, var2]].missing.bind_shadow_matrix(true_string = True, false_string = False) # Filling with dummies .apply( lambda column: (column if "_NA" in column.name else self.column_fill_with_dummies(column)) # Asign nullity ).assign( nullity = lambda df: df[var1+"_NA"] | df[var2+"_NA"] ) # Graphing .pipe( lambda df: sns.scatterplot( data = df, x = var1, y = var2, hue = 'nullity' ) ) )
No estoy muy seguro, pero creo que cuando en la parte del código que pones
self.column_fill_with_dummies
Me parece que estás usando la función que creamos en el archivo "live-exploration-missing-values" y no el que extiende a pandas del archivo "pandas-missing-extension". En el que cree llamé al método mediante el siguiente código
self._obj.missing.column_fill_with_dummies
Que es como vi que Jesús llamaba a los métodos de la clase.
Pasar el código realizado durante la clase a las funciones del archivo "pandas-missing-extension.ipynb".
Codigo de pandas-missing-extension.ipynb
def column_fill_with_dummies( column:pd.Series, proportion_below: float=0.10, jitter: float=0.07, seed: int=42 ) -> pd.Series: column = column.copy(deep= True) #Extract values metada missing_maks = column.isna() number_missing_values = missing_maks.sum() column_range = column.max() - column.min() #Shift data columns_shift = column.min() - column.min() * proportion_below #Create the "jitter" (noise) to be added around the point np.random.seed(seed) column_jitter = (np.random.rand(number_missing_values) - 2) * column_range * jitter #Save new dummy data column[missing_maks] = columns_shift + column_jitter return column def variable_null_values(self, var1, var2): ( self._obj.select_dtypes( exclude='category' ) .pipe( lambda df: df[df.columns[df.isna().any()]] ) .missing.bind_shadow_matrix(true_string=True, false_string=False) .apply( lambda column: column if "_NA" in column.name else column_fill_with_dummies(column, proportion_below=0.05, jitter=0.075) ) .assign( nullity = lambda df: df[var1+'_NA'] | df[var2+'_NA'] ) .pipe( lambda df: ( sns.scatterplot( data = df, x=var1, y=var2, hue='nullity' ) ) ) )
Ejecutar código en nuestro notebook de trabajo llamando a la función
riskfactors_df.missing.variable_null_values('weight_lbs', 'height_inch')
Hola Jonathan, buen aporte de tu parte.
Solo hay un pequeño detalle y es que se te escapó el self como parámetro de la funcion column_fill_with_dummies porque se supone que estás definiendo un metodo dentro de la clase MissingMethods y no una funciión global. Y para llamarlo en la siguiente función variable_null_values debería llamarse usando el self también, como self.column_fill_with_dummies(column, proportion_below=0.05, jitter=0.075)
Al final el código en pandas-missing-extension.ipynb quedaría como:
def column_fill_with_dummies( self, column: pd.Series, proportion_below: float=0.10, jitter: float=0.07, seed: int=42 ) -> pd.Series: column = column.copy(deep= True) #Extract values metada missing_maks = column.isna() number_missing_values = missing_maks.sum() column_range = column.max() - column.min() #Shift data columns_shift = column.min() - column.min() * proportion_below #Create the "jitter" (noise) to be added around the point np.random.seed(seed) column_jitter = (np.random.rand(number_missing_values) - 2) * column_range * jitter #Save new dummy data column[missing_maks] = columns_shift + column_jitter return column def variable_null_values(self, var1, var2): return ( self._obj.select_dtypes( exclude='category' ) .pipe( lambda df: df[df.columns[df.isna().any()]] ) .missing.bind_shadow_matrix(true_string=True, false_string=False) .apply( lambda column: column if "_NA" in column.name else self.column_fill_with_dummies(column, proportion_below=0.05, jitter=0.075) ) .assign( nullity = lambda df: df[var1+'_NA'] | df[var2+'_NA'] ) .pipe( lambda df: ( sns.scatterplot( data = df, x=var1, y=var2, hue='nullity' ) ) ) )
Para llamarlo desde exploration-missing-values.ipynb sería con:
# Gráfica usando la función ( riskfactors_df .missing.variable_null_values( var1 = 'weight_lbs', var2 = 'height_inch' ) ) # Borrar los logs de la gráfica plt.show()
Para el reto mi código que utilice en el archivo "live-exploration-missing-values.ipynb" fue el siguiente:
( riskfactors_df .missing .scatterplot_valores_faltantes( columna_1="weight_lbs", columna_2="height_inch" ) )
Resultado:

Y el código que agregué al archivo "pandas-missing-extension.ipynb" fue el siguiente:
def column_fill_with_dummies( self, column: pd.Series, proportion_below: float=0.10, jitter: float=0.075, seed: int=42 ) -> pd.Series: column = column.copy(deep=True) # Extract values metadata. missing_mask = column.isna() number_missing_values = missing_mask.sum() column_range = column.max() - column.min() # Shift data column_shift = column.min() - column.min() * proportion_below # Create the "jitter" (noise) to be added around the points. np.random.seed(seed) column_jitter = (np.random.rand(number_missing_values) - 2) * column_range * jitter # Save new dummy data. column[missing_mask] = column_shift + column_jitter return column def scatterplot_valores_faltantes(self, columna_1: str, columna_2: str) -> pd.DataFrame: columna_NA_1 = columna_1 + "_NA" columna_NA_2 = columna_2 + "_NA" plt.figure(figsize=(10, 10)) ( self._obj .select_dtypes(exclude="category") .pipe(lambda df: df[df.columns[df.isna().any()]]) .missing.bind_shadow_matrix(true_string=True, false_string=False) .apply( lambda column: column if "_NA" in column.name else self._obj.missing.column_fill_with_dummies(column, proportion_below=0.05, jitter=0.075) ) .assign(nullity=lambda df: df[columna_NA_1] | df[columna_NA_2]) .pipe( lambda df: ( sns.scatterplot( data=df, x=df[columna_1], y=df[columna_2], hue="nullity" ) ) ) )
Les comparto mi solución al reto:
A la función column_fill_with_dummies() no podemos ponerla a la misma altura que el resto de las funciones de nuestro archivo pandas-missing-extension, debido a que todas esas funciones están hechas para extender los dataframes de pandas y nuestra función column_fill_with_dummies trabaja con series.
Entonces haríamos una nueva implementación al final de nuestro archivo de pandas-missing-extension para que este extienda series:
Quedaría de la siguiente manera:
@pd.api.extensions.register_series_accessor("missing") class MissingSeriesMethods: def __init__(self, pandas_obj): self._obj = pandas_obj def column_fill_with_dummies( self, proportion_below: float = 0.10, jitter: float = 0.075, seed: int = 42 ) -> pd.Series: """Fills a column with missing values with dummies, to be used in a scatterplot""" # We're going to create a new series for the dummy data # Extract values metadata missing_mask = self._obj.isna() number_missing_values = missing_mask.sum() column_range = self._obj.max() - self._obj.min() # Shift data column_shift = self._obj.min() - self._obj.min() * proportion_below # Create the "jitter" (noise) to be added around the points np.random.seed(seed) column_jitter = (np.random.rand(number_missing_values) - 2) * column_range * jitter # Create new series for dummy data with the same index as the missing values in the original series dummy_data = pd.Series(column_shift + column_jitter, index=self._obj[missing_mask].index) # Return a series combining original and dummy data return self._obj.fillna(dummy_data)
Entonces, la función nullity_scatterplot podría quedar así:
def nullity_scatterplot( self, x:str, y:str, **kwargs ): """Recieves a DataFrame and 2 strings with the names of the columns to be used as x and y. Plots a nullity scatterplot""" return( self._obj.select_dtypes( exclude='category' ) .pipe( lambda df : df[df.columns[df.isna().any()]] ) .missing.bind_shadow_matrix(true_string=True, false_string=False) .apply( lambda column: column if "_NA" in column.name else column.missing.column_fill_with_dummies( proportion_below=0.05, jitter=0.075) ) .assign( nullity = lambda df:df[x+'_NA'] | df[y+'_NA'] ) .pipe( lambda df:( sns.scatterplot( data=df, x=x, y=y, hue='nullity' ) ) ) )
En mi caso tuve que reiniciar el Kernell para que procesara los cambios.
Volví a cargar mi archivo %run pandas-missing-extension.ipynb
Y finalmente quedó así implementado
( riskfactors_df .missing .nullity_scatterplot('weight_lbs', 'height_inch') )
Me encantó lo sencilla que queda la llamada
This is my way
# Made by Bryan: Column_fill_with_dummies and Scatterplot with missing data def column_fill_with_dummies( self, column: pd.Series, proportion_below: float=0.10, jitter: float=0.075, seed: int=42 ) -> pd.Series: column = column.copy(deep=True) missing_mask = column.isna() nuber_missing_values = missing_mask.sum() column_range = column.max() - column.min() column_shift = column.min() - column.min() * proportion_below np.random.seed(seed) column_jitter = (np.random.rand(nuber_missing_values) - 2) * column_range * jitter column[missing_mask] = column_shift + column_jitter return column def scatterplot_with_missing_data(self, variable_1: str, variable_2: str): ( self._obj.select_dtypes(exclude = "category") .pipe(lambda df : df[df.columns[df.isna().any()]]) .missing.bind_shadow_matrix(true_string = True, false_string = False) .apply( lambda column: column if "_NA" in column.name else self.column_fill_with_dummies(column, proportion_below=0.05, jitter=0.075) ) .assign( nullity = lambda df : df[f"{variable_1}_NA"] | df[f"{variable_2}_NA"] ) .pipe(lambda df: ( sns.scatterplot(data= df, x= variable_1, y= variable_2, hue="nullity") )) )
and you can use just the names of the columns
( riskfactors_df.missing.scatterplot_with_missing_data("weight_lbs", "height_inch") )
Mi solucion al reto: missing_bivariable_plot(variable_a: str, variable_b: str)
Solo añadi 2 funciones:
column_fill_with_dummies(): como era de esperarse solo era copiar y pegar.missing_bivariable_plot(): requería algunas modificaciones como hacer el jitter a las variables, crear la columna nullity y devolver el plot.Las añadi al final de exploration-missing-values.ipynb:
# ****** Primera funcion ******* def column_fill_with_dummies( column: pd.Series, proportion_below: float=0.10, jitter: float=0.075, seed: int=42 ) -> pd.Series: column = column.copy(deep=True) # Extract values metadata. missing_mask = column.isna() number_missing_values = missing_mask.sum() column_range = column.max() - column.min() # Shift data column_shift = column.min() - column.min() * proportion_below # Create the "jitter" (noise) to be added around the points. np.random.seed(seed) column_jitter = (np.random.rand(number_missing_values) - 2) * column_range * jitter # Save new dummy data. column[missing_mask] = column_shift + column_jitter return column # ****** Segunda funcion ******* def missing_bivariable_plot(self, variable_a: str, variable_b: str): df = self._obj.missing.bind_shadow_matrix(true_string=True, false_string=False) df[variable_a] = column_fill_with_dummies(self._obj[variable_a]) df[variable_b] = column_fill_with_dummies(self._obj[variable_b]) df['nullity'] = df[f"{variable_a}_NA"] | df[f"{variable_b}_NA"] return ( sns.scatterplot( data=df, x=variable_a, y=variable_b, hue="nullity" ) )
Yo lo hice asi
def scatter_dummies(self, columns: list[str]): """Recibes a list of two strings with the name of the columns that are going to be plotted""" if len(columns) != 2: raise ValueError('Function needs different columns') def column_fill_with_dummy(column: pd.Series, proportion_below: float = 0.10, jitter: float = 0.075, seed: int = 42) -> pd.Series: """ Takes a column and if it has a missing value fills it with a outsider value """ column = column.copy(deep= True) missing_mask = column.isna() number_missing_values = missing_mask.sum() column_range = column.max() - column.min() # The new dummy values will be under the minimum column_shift = column.min() - column.min() * proportion_below np.random.seed(seed) column_jitter = (np.random.rand(number_missing_values) - 2) * jitter * column_range column[missing_mask] = column_shift + column_jitter return column ( self._obj[columns] .missing.bind_shadow_matrix( true_string= True, false_string= False ) .apply( lambda column: column if '_NA' in column.name else column_fill_with_dummy(column) ) .assign( nullity = lambda df: df[columns[0] + '_NA'] | df[columns[1] + '_NA'] ) .pipe( lambda df: sns.scatterplot( data= df, x= columns[0], y= columns[1], hue= 'nullity' ) ) )