Cómo mantener contexto en conversaciones con OpenAI
Contenido del curso
Claude API
Gemini API y Despliegue con Vercel
Vercel AI SDK
ElevenLabs API
Cómo mantener contexto en conversaciones con OpenAI
Cómo mantener contexto en conversaciones con OpenAI
Contenido del curso
platzi team...no pongan el cuestionario de forma invasiva y obligatoria. hay empresas que no te permiten hacer cursos en horarios de trabajo y con ese mecanismo.. que es muy bueno.. debe tener ser opcional por un toggle button y una opción de hscerlis cuando sea posible. gracias
Gracias. Opino lo mismo.
Esto es importante porque por defecto los LLMs son stateless, ósea no tienen memoria y tienes que proveerlos de ella para mantener un hilo de conversación user/asssistant.
Gracias por el aporte Miguel, es clave esto de mantener el contexto.
Excelente,
En mi caso crearé un package en un monorepo para las diferentes pruebas, por ahora hice algo así:
import { openAiClient } from "./clients/index.js"; type LLMName = "openai"; type ClientOptions = { apiKey: string; }; export function createClient(provider: LLMName, options: ClientOptions) { if (!options.apiKey) { throw new Error("API key is required"); } switch (provider) { case "openai": return openAiClient(options.apiKey); default: throw new Error(`Unsupported LLM: ${provider}`); } }
import OpenAI from "openai" export const openAiClient = (apiKey: string): OpenAI => { return new OpenAI({ apiKey }); }
¿Por qué es mejor usar Bun aquí?
Bun simplifica enormemente el flujo de trabajo moderno en JavaScript porque actúa como un entorno "todo en uno". Mientras que en Node.js tradicionalmente necesitas instalar paquetes adicionales como dotenv o configurar banderas específicas en la terminal para que tu código lea las variables de entorno (como tu API Key), Bun las detecta y carga automáticamente desde el archivo .env o .env.local en cuanto ejecutas el script.
Esto elimina fricción al momento de programar. Además, Bun es significativamente más rápido al instalar dependencias y ejecutar el código gracias a su motor basado en JavaScriptCore (el mismo de Safari), a diferencia del motor V8 que usa Node.js. Si estás construyendo aplicaciones de inteligencia artificial donde iterarás constantemente haciendo peticiones a la API, esos segundos ahorrados en cada ejecución y la configuración automática de variables de entorno hacen que la experiencia de desarrollo sea mucho más fluida y menos propensa a errores de configuración.
¿Puedo usar esto para otros modelos?
Absolutamente. La arquitectura del cliente de OpenAI está diseñada para ser agnóstica respecto al modelo de lenguaje que elijas. En el objeto de configuración donde defines el model, puedes cambiar fácilmente el valor por cualquier otro modelo disponible en la plataforma, dependiendo de tus necesidades de velocidad, costo o capacidad de razonamiento.
Por ejemplo, si necesitas respuestas ultra rápidas y económicas para tareas sencillas, puedes cambiar el string a "gpt-3.5-turbo" o "gpt-4o-mini". Si requieres análisis profundo, lógica compleja o generación de código avanzado, puedes apuntar a "gpt-4o". Lo único que debes tener en cuenta es que algunos modelos más antiguos pueden usar endpoints diferentes (como Completions en lugar de Chat Completions), pero mientras uses los modelos modernos de la familia GPT, la estructura de tu código de conexión y el envío del prompt se mantendrán exactamente iguales. Solo cambias una línea de texto y obtienes un "cerebro" completamente distinto.
No es estrictamente necesario usar el endpoint de Chat Completions para mantener el contexto de una conversación. También se puede utilizar la Responses API. Para ello, basta con enviar en cada nueva solicitud el ID de la última respuesta generada. De esta forma, la API interpreta que deseas continuar con el contexto conversacional. En cada ejecución, debes capturar el ID de la respuesta anterior y enviarlo como parámetro en el siguiente request. (previous_response_id)
previous_response_id
Eso te obliga a hacer un paso adicional, capturar el ID y mandarlo al siguiente mensaje... por lógica esto será más lento. Por eso la recomendación, pero igual, esto pasa a ser preferencias del desarrollador, nada está escrito en piedra.
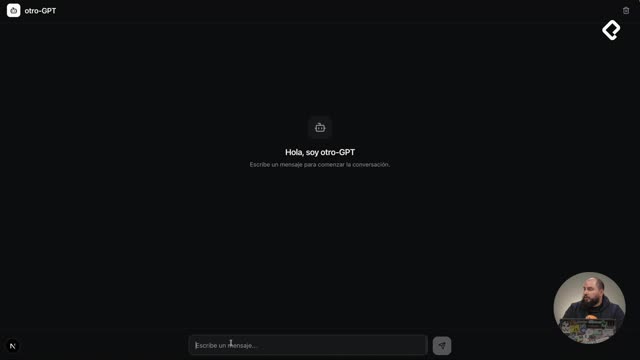
🧠 CHATBOTS CON CONTEXTO (OpenAI + Node.js)
🎯 IDEA CLAVE
• Un chatbot útil recuerda lo que se habló antes.
• Sin contexto → respuestas incoherentes ❌.
• Con contexto → conversación natural ✅.
⚠️ PROBLEMA PRINCIPAL
• El chatbot responde solo a la última pregunta. • Olvida mensajes anteriores. • La conversación pierde sentido.
👉 Conclusión: • Necesitamos memoria + flujo continuo.
⚡ STREAMING (RESPUESTA EN VIVO)
🔹 ¿Qué cambia? • Antes: respuesta completa al final ⏳. • Ahora: respuesta en tiempo real ⚡.
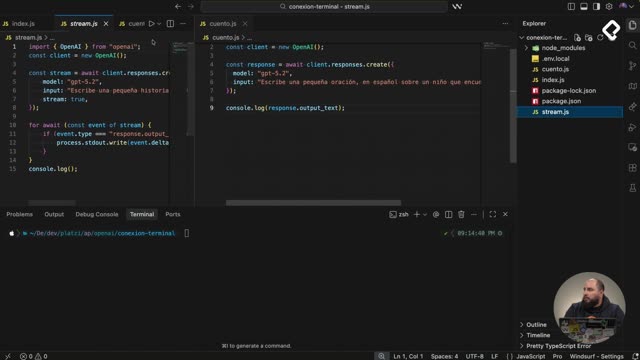
🔹 Activación: • stream: true
🔹 Funcionamiento: • La respuesta llega en partes → “delta”. • Cada fragmento se imprime al instante.
🔹 Ejemplo:
for await (const event of response) {
process.stdout.write(event.output_text.delta);
}
🎯 Resultado: • Texto aparece palabra por palabra. • Sensación tipo ChatGPT 💬.
🧩 ENDPOINT DE COMPLETIONS
🔹 ¿Para qué sirve? • Manejar conversaciones completas. • Mantener contexto entre mensajes.
🔹 Estructura: • Lista (array) de mensajes.
🔹 Cada mensaje tiene: • role → quién habla. • content → qué dice.
🔹 Ejemplo:
const messages = [
{ role: 'system', content: 'Eres un asistente muy útil y amable' },
{ role: 'user', content: '¿Cuál es la capital de Colombia?' }
];