Conectar OpenAI con Next.js paso a paso
Contenido del curso
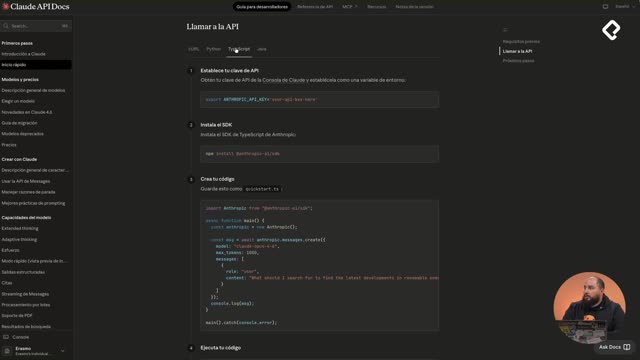
Claude API
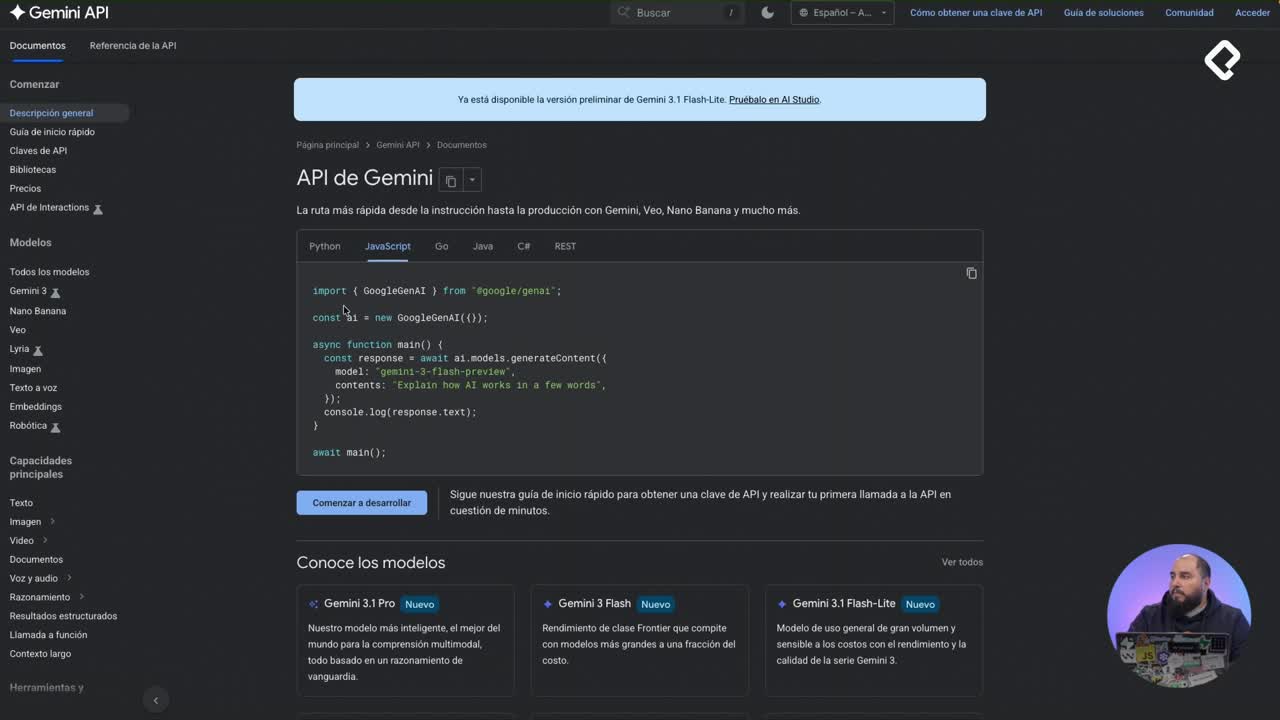
Gemini API y Despliegue con Vercel
Vercel AI SDK
ElevenLabs API
Conectar OpenAI con Next.js paso a paso
Conectar OpenAI con Next.js paso a paso
Contenido del curso

Alexander Volantines
Erasmo Hernández
Profesor
Jairo Mendoza

Paulo Vivar
Erasmo Hernández
Profesor
Eduardo Rodriguez Cisneros
Erasmo Hernández
Profesor
Jose Eduardo Tirado Verbel

Gabriel Obregón
Jose Eduardo Tirado Verbel
Hay una error en la clase y la pregunta, ya que se puede utilizar el endpoint Responses API para un chat con contexto. Para ello, basta con enviar en cada nueva solicitud el ID de la última respuesta generada. De esta forma, la API interpreta que deseas continuar con el contexto conversacional. En cada ejecución, debes capturar el ID de la respuesta anterior y enviarlo como parámetro en el siguiente request. (previous_response_id)
Sobre si Chat Completions tiene alguna ventaja para un chat con contexto: hoy, en general, no parece ser la opción más optimizada. La propia documentación dice que en Chat Completions el estado conversacional se maneja manualmente, mientras que en Responses puedes usar previous_response_id o conversation. Además, OpenAI recomienda Responses para proyectos nuevos y dice que los modelos de razonamiento tienen una experiencia mejor ahí.
Saludos.
Eso te obliga a hacer un paso adicional, capturar el ID y mandarlo al siguiente mensaje... por lógica esto será más lento. Por eso la recomendación, pero igual, esto pasa a ser preferencias del desarrollador, nada está escrito en piedra.
Hola bueno yo estoy creando un chatbot que lo integrare a una pagina web de renta de casas, la idea es que el bot pueda hablar e interactuar con la persona y si quiere alquilar o rentar una casa que le responda basado en la informacion de todas las casas y precios que hay, en este caso yo usé n8n que con el nodo de asistente y conectandole una memory simple actua pero igual quiero escuchar opciones, porque eventualmente tendré muchas mas casas y precios y ahora mismo solo responde basado en un texto plano pero y si quiero meterle una base de datos mas grande. Gracias!
Estoy desarrollando un chatbot con OpenAI y mi objetivo es que responda únicamente con información proveniente de documentos que tengo almacenados en mi base de datos (documentación interna, PDFs, etc.).
¿Para este caso es recomendable implementar RAG o existe alguna alternativa mejor para limitar las respuestas del modelo solo a la información de mis documentos?
Me gustaría saber qué arquitectura recomiendan para este tipo de escenarios.
Me suena a que RAG es tu mejor solución.
Estoy trabajando en un concierge para agendar citas veterinarias, pero aún no logro hacer que me lea las tablas y demás datos de la BD PostgreSQL
Debes ajustar tu System Prompt para que se hagan consultas SQL por debajo, pero eso seguramente te va a consumir más tokens. Me pasó en un proyecto, y tenía que hacer:
- Leer el input del usuario - Convertirlo a una sentencia SQL y ejecutarla - Recibir la respuesta en SQL - Cambiarla para mostrar solo el resultado en lenguaje natural o con algún componente custom
Cada parte de ese proceso llevaba costos asociados y cada consulta terminaba siendo muy cara.
¿Cuándo debo usar el rol de sistema?
Debes utilizar el rol system al inicio de la interacción para establecer las reglas del juego, la personalidad y los límites de tu asistente. Piensa en este mensaje como las instrucciones "detrás de escena" que el usuario final nunca ve, pero que dictan cómo se comportará la inteligencia artificial. Por ejemplo, puedes indicarle: "Eres un experto en finanzas que responde solo en formato de viñetas y con un tono sarcástico". Al definir esto en el primer objeto de tu array de mensajes, garantizas que todas las respuestas posteriores mantengan esa coherencia, sin importar lo que el usuario (user) pregunte. Es la herramienta más poderosa que tienes para evitar que el modelo alucine o se salga del personaje, asegurando que la experiencia se mantenga alineada con el propósito específico de tu aplicación.
🧠 OpenAI + Next.js
🎯 Crear una aplicación web con Next.js conectada a OpenAI.
🧠 Lograr que el asistente recuerde la conversación (mantener contexto).
🤖 Pasar de respuestas simples a un asistente inteligente.
🔄 FLUJO DE FUNCIONAMIENTO
1️⃣ 📥 Llega el mensaje desde la interfaz.
2️⃣ 🔍 Se identifica el último mensaje del usuario.
3️⃣ 🤖 Se envía al modelo de IA.
4️⃣ 📤 Se devuelve la respuesta como “asistente”.
🛠️ Incluye manejo de errores de conexión.
🔁 PROBLEMA: RESPONSES
❌ Limitaciones:
• 🚫 No guarda memoria.
• 🔄 Cada mensaje es independiente.
🧪 Ejemplo:
• ❓ “¿Capital de Colombia?” → Bogotá.
• ❓ “¿Color de su bandera?” → ❌ No entiende el contexto.
✅ SOLUCIÓN: COMPLETIONS
💡 Mejora clave:
• 🧠 Permite enviar todo el historial de mensajes.
• 🔗 Mantiene el contexto de la conversación.
🧪 Ejemplo corregido:
• ❓ “Capital de Colombia” → Bogotá, D.C.
• ❓ “Color de su bandera” → amarillo, azul y rojo.
✔️ No es necesario repetir el país.
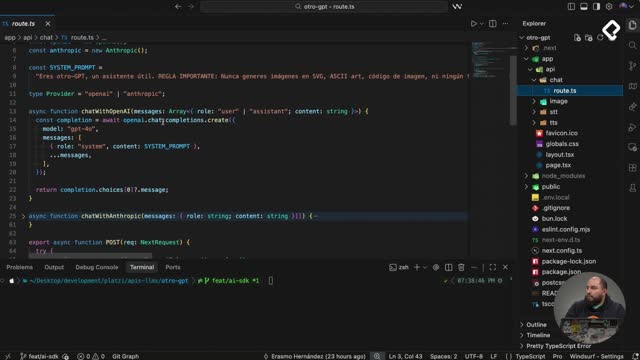
🧩 IMPLEMENTACIÓN
🔧 Cambios realizados:
• ⚙️ Uso de openai.chat.completions.create.
• 📚 Envío de todos los mensajes acumulados.
• 🤖 Se mantiene el mismo modelo.
• 📤 Respuesta con NextResponse.
¿Qué pasa si no uso chat completions?
Si intentas mantener una conversación utilizando endpoints más antiguos o básicos (como los de generación de texto simple), te enfrentarás a un problema de estructura. Esos modelos están diseñados para recibir un único bloque de texto (prompt) y devolver una continuación directa, lo que hace muy complejo y propenso a errores simular un diálogo de ida y vuelta. Al usar el endpoint de Completions (específicamente Chat Completions), accedes a una arquitectura optimizada nativamente para entender la dinámica de una conversación. Este endpoint está entrenado para procesar el formato de roles (system, user, assistant), lo que le permite diferenciar claramente quién dijo qué. Si omites esto, tendrías que inventar tu propio sistema de formateo de texto para separar los turnos de habla, lo cual consume más tokens, es menos preciso y rompe la fluidez del contexto.