



Axel Yaguana
Team PlatziK-Means performance
We can use elbow for optimal K method.
Juan R. Vergara M.
Thank you 👍

Miguel Acosta
Simple but excellent
Cuando trabajas con datos sin etiquetas, necesitas herramientas capaces de identificar patrones por sí solas. K-means es uno de los algoritmos más utilizados en unsupervised learning para descubrir agrupaciones naturales en los datos, y comprender su funcionamiento es esencial para cualquier persona que trabaje con machine learning.
¿Qué es k-means y cómo encuentra estructura en los datos?
El aprendizaje no supervisado (unsupervised learning) busca encontrar estructura en datos que no tienen una variable objetivo definida [0:08]. Imagina un scatterplot con dos features de entrada, x1 y x2: visualmente podrías intuir que existen tres grupos, pero necesitas un método formal para asignar cada punto a su grupo correspondiente. Ahí es donde entra k-means.
El algoritmo se basa en el concepto de centroide [0:40]. Un centroide es un punto en el espacio que actúa como el representante o líder de un cluster. Al inicio, estos centroides se colocan de forma aleatoria, aunque existen métodos no aleatorios para inicializarlos.
El proceso funciona así:
¿Cuál es el único parámetro principal de k-means?
El valor k, es decir, el número de grupos que defines antes de ejecutar el algoritmo [1:36]. Elegir distintos valores de k produce resultados muy diferentes. Con k igual a 2 podrías obtener un cluster superior y otro inferior; con k igual a 3 o 4, tanto la forma como la cantidad de puntos en cada grupo cambian significativamente.
¿Qué función de costo optimiza k-means?
La función de costo busca minimizar la distancia total entre cada punto y el centroide del cluster al que pertenece [2:14]. Para todos los datos que pertenecen a un grupo específico, se mide qué tan lejos están de su centroide representativo. El objetivo es que esa distancia sea lo más pequeña posible.
¿Cómo funciona la regla de actualización y cuándo se detiene el algoritmo?
La regla de actualización (update rule) sigue un ciclo claro [2:46]:
El algoritmo puede terminar de dos maneras:
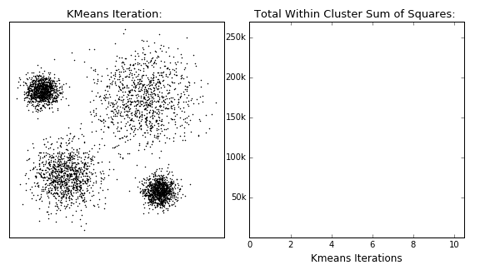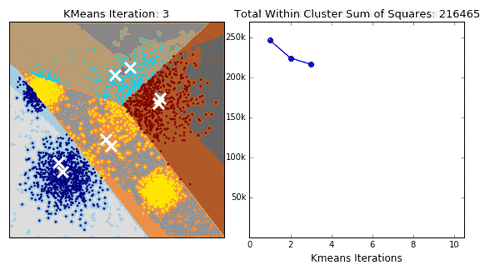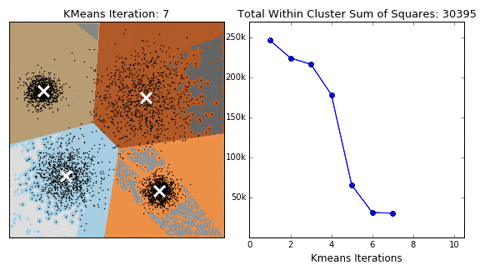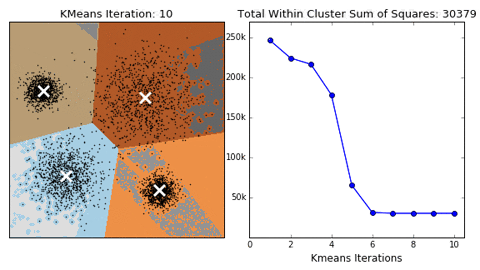
En las primeras iteraciones, los centroides se mueven considerablemente [3:36]. Conforme avanza el proceso, los movimientos se vuelven mínimos, lo cual indica convergencia. Es recomendable visualizar cada iteración con scatterplots para entender cómo evoluciona el modelo.
¿Cómo elegir el mejor valor de k para tu modelo?
Determinar un buen valor de k es fundamental y se puede abordar desde dos perspectivas [4:08].
Cuando solo tienes un modelo, puedes calcular dos métricas:
Sin embargo, un solo modelo generalmente no es suficiente. Para comparar múltiples valores de k, se utiliza el elbow plot [4:44]. Este gráfico muestra la inercia en función de k: a medida que aumentas el número de grupos, la inercia disminuye. El punto clave es identificar el codo o curva pronunciada en el gráfico, que indica el valor de k más apropiado. Esto requiere ejecutar varios modelos con valores pequeños y grandes de k.
Para practicar estos conceptos, se propone trabajar con el Iris Dataset [5:52], un conjunto de datos clásico en machine learning que utiliza características de flores como el ancho del pétalo y el sépalo para explorar agrupaciones y predicciones.
Si tienes dudas sobre cómo implementar k-means o elegir el valor de k adecuado, comparte tus preguntas en los comentarios.
Axel Yaguana
Team PlatziK-Means performance
We can use elbow for optimal K method.
Juan R. Vergara M.
Thank you 👍
Miguel Acosta
Simple but excellent
RESUMEN
Describe el enfoque de aprendizaje no supervisado llamado K-means, que busca encontrar una estructura en los datos mediante la asignación de puntos de datos a grupos específicos, conocidos como clusters. Para hacer esto, K-means utiliza centroides que representan cada cluster y se colocan inicialmente de manera aleatoria. El objetivo es actualizar la posición de los centroides encontrando la media de los puntos de datos que pertenecen a cada cluster, lo que permite actualizar la asignación de puntos de datos y los clusters. El parámetro más importante en K-means es el número de clusters, conocido como "K". Además, el texto menciona la función de coste que se busca optimizar durante la ejecución de K-means y la regla de actualización que se utiliza para actualizar los centroides. Por último, se describe un ejemplo visual que muestra cómo cambia la asignación de puntos de datos a clusters a lo largo de varias iteraciones.

Mauricio Combariza
Muy interesante, de esta forma puedo determinar una ruta optima para la entrega de muchos paquetes
Pedro Quiñonez Verdugo
Los centroides in k-means representan posiciones en el espacio que se supone que representan cada una de las features de entrada.
Julián Cárdenas
K-means itera y agrupa, dependiendo del tipo de conjuntos que quieras
Alberto Duque Villegas
Me parece una buena forma de comprender lo que hace cada algoritmo para que nuestro abordaje de los problemas, como científicos de datos, sea racional y explicable.
Tres ingredientes de un algoritmo:
Proceso de decisión: la forma en la que el modelo hace una predicción, generalmente mediante el uso de parámetros.
Función de coste: la forma en que la predicción del modelo se compara con el objetivo de salida o meta.
Regla de actualización: forma en la que el modelo actualiza y cambia sus parámetros para mejorar las predicciones.

Tomas Dale
Copienlo en Collab y pruebenlo k-means
from sklearn.cluster import KMeans import numpy as np from sklearn import datasets import pandas as pd
import matplotlib.pyplot as plt from sklearn import metrics
DATOS = datasets.load_wine()
DataTarget = DATOS.target
col_list = DATOS.feature_names DataToTrain = pd.DataFrame(DATOS.data, columns = col_list) print(col_list)
K_optimo = 0; Mejor = 0
for K in range(2,8):
# Variamos K model = KMeans(n_clusters= K, max_iter=1000) #Se entrena modelo model.fit(DataToTrain) y_labels = model.labels_ #Creamos prediccion y_kmeans = model.predict(DataToTrain) # Revisamos la precicion del modelo accuracy = metrics.adjusted_rand_score(DataTarget, y_kmeans) print(K,' ',accuracy) if accuracy > Mejor: K_optimo = K Mejor = accuracy
print('') print(f'Max accuracy: {round(Mejor,3)}% \nUsando K: {K_optimo} ')
K = K_optimo
model = KMeans(n_clusters= K, max_iter=1000) model.fit(DataToTrain)
y_labels = model.labels_
#Creamos prediccion y_means = model.predict(DataToTrain)
#GRAFIQUE 2 FEATURES PARA VER SI HAY RELACION
plt.scatter(DataToTrain['alcohol'], DataToTrain['hue'], c=y_means, s=30) plt.xlabel('Alcohol', fontsize = 10) plt.ylabel('Hue', fontsize = 10)

Sebastian Alejandro Gómez Ardila
This video makes a good exposition about k means
Julián Cárdenas
Thanks!
Tomas Dale
Un saludo desde El Salvador, os dejo un ejemplo de K-means
from sklearn.cluster import KMeans import numpy as np from sklearn import datasets import pandas as pd
import matplotlib.pyplot as plt from sklearn import metrics
DATOS = datasets.load_wine()
DataTarget = DATOS.target
col_list = DATOS.feature_names DataToTrain = pd.DataFrame(DATOS.data, columns = col_list) print(col_list)
K_optimo = 0; Mejor = 0
for K in range(2,8):
# Variamos K model = KMeans(n_clusters= K, max_iter=1000) #Se entrena modelo model.fit(DataToTrain) y_labels = model.labels_ #Creamos prediccion y_kmeans = model.predict(DataToTrain) # Revisamos la precicion del modelo accuracy = metrics.adjusted_rand_score(DataTarget, y_kmeans) print(K,' ',accuracy) if accuracy > Mejor: K_optimo = K Mejor = accuracy
print('') print(f'Max accuracy: {round(Mejor,3)}% \nUsando K: {K_optimo} ')
#SEGUNDA PARTE PREDICCION #==========================
K = K_optimo
model = KMeans(n_clusters= K, max_iter=1000) model.fit(DataToTrain)
y_labels = model.labels_
#Creamos prediccion y_means = model.predict(DataToTrain)
GRAFIQUE 2 FEATURES
#====================
plt.scatter(DataToTrain['alcohol'], DataToTrain['hue'], c=y_means, s=30) plt.xlabel('Alcohol', fontsize = 10) plt.ylabel('Hue', fontsize = 10)
Patricio Sánchez Fernández
Felicitaciones Tomas Dale, gran aporte...!
Stanley Melgar
Un hilo interesante a leer sobre el uso del Elbow Plot ~
Julián Cárdenas
BUEN HILOOO!

Claudia Alicia Bustamante
Hola a todos como validan el numero de k-means clusters que es optimo para un dataset? se hace en base a la distancia euclidiana?
Dionicio Perez
La elección correcta del parámetro k en el algoritmo k-means es un paso importante para obtener resultados significativos y útiles. Aquí te presento algunos métodos comunes para seleccionar el valor óptimo de k:
Método del codo (Elbow Method): Este método evalúa la varianza dentro de los grupos en función de k. Se ejecuta el algoritmo k-means para diferentes valores de k y se calcula la suma de las distancias al cuadrado de cada punto a su centroide más cercano (también conocida como la inercia). Luego, se traza un gráfico de la inercia en función de k y se busca el punto en el que la mejora en la inercia comienza a disminuir significativamente, formando una curva con forma de "codo". Ese punto se considera como el valor óptimo de k.
Método de la silueta (Silhouette Method): Este método evalúa la cohesión dentro de los grupos y la separación entre los grupos. Se calcula el coeficiente de silueta para cada punto, que es una medida de qué tan bien se encuentra un punto dentro de su grupo en comparación con los otros grupos. Luego, se calcula el promedio del coeficiente de silueta para todos los puntos y se repite el proceso para diferentes valores de k. El valor de k que maximice el coeficiente de silueta se considera como el valor óptimo.
Método de validación externa: En algunos casos, puedes tener información externa o etiquetas de clase para evaluar la calidad del agrupamiento. Puedes ejecutar el algoritmo k-means para diferentes valores de k y luego utilizar métricas de evaluación externa, como el índice de Rand ajustado (Adjusted Rand Index) o el índice de Jaccard ajustado (Adjusted Jaccard Index), para medir la similitud entre los grupos obtenidos y las etiquetas de clase reales. El valor de k que produzca el mejor ajuste con las etiquetas de clase se considera como el valor óptimo.
Es importante tener en cuenta que no existe un método definitivo para elegir el valor óptimo de k, y la elección puede depender del contexto y la naturaleza de los datos. También se recomienda realizar pruebas y análisis adicionales para validar y comprender los resultados obtenidos con diferentes valores de k.
Además de estos métodos, también se pueden utilizar enfoques más avanzados, como algoritmos de agrupamiento jerárquico, análisis de componentes principales (PCA) o técnicas de reducción de dimensionalidad, para ayudar en la selección de k.

Matías Collado
Pero para actualizar centroides usando el promedio de las distancias entre puntos y centroides del cluster, ¿como se mueve el centroide hacia una mejor ubicación?
Dionicio Perez
La explicación en un comentario sería muy larga, por lo cual te recomiendo el siguiente video: Una aproximación al k-means. Este video es para entender como funciona y en el que le sigue se explica el código en python.

Rodmy Suarez


Isaac Bryan Ascanoa Roncall
Estoy impresionado con el uso de K-means. Es un dato a tener en cuenta. Ademas, su desarrollo permite mejorar el aprendizaje de este.

Juan José Mamani Tarqui
I think this guy explain very easy about the topic.

Valentina Cobo Paz
He usado en diferentes ejercicios este data set y solamente conocía que eran diferentes especies de un mismo genero de plantas, acá esta la historia del origen de este dataset y para que fue pensando inicialmente. Es una buena practica entender de donde provienen nuestros datos. https://towardsdatascience.com/the-iris-dataset-a-little-bit-of-history-and-biology-fb4812f5a7b5

Jhon Freddy Tavera Blandon
Los algoritmos de aprendizaje no supervisado son un tipo de algoritmo de aprendizaje automático que se utiliza cuando no se dispone de etiquetas o valores en los datos de entrada. A diferencia de los algoritmos de aprendizaje supervisado que se utilizan para problemas de clasificación y regresión, los algoritmos de aprendizaje no supervisado se centran en encontrar patrones, estructuras ocultas o agrupaciones en los datos sin ninguna orientación previa.
Emmanuel Guerra Sánchez
Los algoritmos de clustering son utilizados para determinar si un artículo es sensaionalista o no (fake news)