Ventana de contexto en LLMs y sus límites
Contenido del curso
Ventana de contexto en LLMs y sus límites
Contenido del curso
Alfredo Olmedo
Kenneth Angulo L
Bryan Castano

Gabriel Obregón

Jefrey Roman Perez
Jefrey Roman Perez
Nicole Contreras
Mateo Montoya Henao

Douglas Alexander Hernández Carpio

Jesus David Posada Escobar
César David Ramírez Dimaté
Santiago García Rincón
Jefrey Roman Perez
Héctor Alonso Padilla Ramírez
Yuliana Mallorga
Pedro Jesus Hincapie Garcia
Daniel Alfredo García Serna
Charles Castillo Rosas

Gonzalo Senabre

Victor Alejandro Esquivel Valencia
Sabel Guadalupe Hernández de Hernández

Daniel Cardenas
Gonzalo Blasco

Henry Norberto Arias Salgado
Yimy Renzo Dávila Urteaga
Jefrey Roman Perez

Marcos Mesias
Alex Paguada
Yo lo que hago cuando tengo mucho prompt en la ventana de contexto, le pido que me haga un Resumen, asi que voy a otro Chat, copio y pego y desde ahi continuo
Buen consejo, voy a tenerlo presente la próxima vez que me ocurra algo similar. Gracias por la idea !
Hey, sii, Yo hago lo mismo. cuando Yo doy cuenta que mi LLM no comienza a dar output != Fact, Yo reconozco que se ha ido de largo con su ventana de Contexto, por tanto le pido que resuma las ideas principales de este chat o de l oque hemos hablado del main_subjet y me lo llevo a un n uevo chat, le digo , en base a esto, <p>pego el resumen del anterior chat</p> y comienzo con mis neuvas Intrucciones. asi se toma ventaja de un nuevo chat limpio.
📘LLM: Ventana de Contexto & Atención
🔹 1. Ventana de contexto
📖 Definición
👉 Todo lo que el modelo “ve” al responder:
🧩 Claves rápidas
⚠️ Cuando se desborda
🔹 2. Atención
🎯 Definición
👉 El mecanismo que da peso a partes del prompt para entender intención y significado.
✨ Cómo funciona
⚠️ Dificultades
🔹 3. Estrategias para optimizar
🛠️ Trucos prácticos
🔹 4. Habilidades que desarrollas
🧠 Practicando estas técnicas mejoras en:
🌟 IDEA CLAVE
➡️ Ventana organizada + Atención bien dirigida = Respuestas más fiables y consistentes.
Me dolió la cabeza.
La información era tan nueva para mí que, al principio, mi cerebro se saturó tratando de encontrar una forma de procesarla. Estuve confundido, estresado y sin entender del todo... hasta que hice lo necesario: vi un video, interactué con la IA y leí un texto con buenas analogías. Y entonces todo encajó.
Esta experiencia me recordó algo importante: el crecimiento siempre llega después de un dolor bien procesado. Si un concepto te parece difícil al inicio, no te detengas. Quédate, enfréntalo, pregúntate qué fue lo que te dolió exactamente y profundiza en ello.
Cuando finalmente lo entiendes por tu propio esfuerzo, la satisfacción es enorme. Y lo mejor: ya no eres la misma persona que empezó, creciste.
Me sentí inspirado, jajajá
y esto no solo se aplica a conocimiento, te mandaste un Tip de vida y crecimiento personal jajaja.
✨ Resumen Visual de la Clase: Ventana de contexto y modelo de atención en LLMs ✨
1. La Idea Central (El Core 💡): La ventana de contexto en LLMs determina cuánta información pueden procesar, afectando su rendimiento y capacidad de atención.
2. Puntos Clave (En viñetas 📌):
3. El Ejemplo o Dato Crucial 🚀: ChatGPT tiene una ventana de contexto de 128,000 tokens, lo que equivale aproximadamente a 300 páginas de un libro.
4. Conexión o Siguiente Paso 🔗: Este conocimiento es esencial para estructurar mejor los prompts y maximizar la efectividad de la IA en tareas profesionales, como la automatización y el análisis de datos.
OpenAI ofrece una herramienta oficial llamada Tokenizer 🔎
👉
Esta herramienta permite ver cómo un texto se divide en tokens y cuántos tokens consume un prompt, lo cual es muy útil para optimizar prompts y entender mejor cómo procesan la información los modelos de IA 🤖.
Gracias!
!Meme Personalizado - Vine buscando cobre y encontré oro - 26626819
Los modelos de IA, como los LLMs, priorizan la atención a los últimos párrafos de un prompt porque el modelo de atención asigna más importancia a la información más reciente. Esto se debe a que, al procesar el contexto, los últimos datos aportan una indicación clara sobre la dirección y el enfoque que debe tomar la respuesta. Por lo tanto, si se necesita mantener la relevancia de las instrucciones, es útil repetir o incluir información clave al final del chat para optimizar la respuesta del modelo.
Exacto, Santiago. Es fascinante ver cómo se parecen a nosotros: casi siempre recordamos mejor lo último que nos dijeron.
Por eso, aplicar ese "recordatorio final" es oro puro.
Yo a veces tengo mis instrucciones críticas guardadas en VS Code o notas rápidas para pegarlas justo al final del prompt y asegurarme de que la "atención" del modelo esté donde debe.

Para mantener el modelo enfocado es bueno mantener un rol por chat, repetir lo esencial al final del prompt y resaltar instrucciones importantes con recursos del idioma. Reiniciar el chat con la informacion esencial que se esta tratando (resumir) cuando se note que comienza a alucinar, y estandarizar formatos de salida.
En resumen:
📚 CLASE: Ventana de contexto y tokens en LLMs
━━━━━━━━━━━━━━━━━━
🎯 IDEA PRINCIPAL
El modelo no recuerda todo igual. Tiene un límite de lo que puede "ver" a la vez y prioriza lo más reciente. Cuando ese espacio se satura, aparecen olvidos, confusiones y alucinaciones, aunque tú hayas dado toda la información necesaria. Entender este mecanismo te permite gestionar tus conversaciones con IA de forma más inteligente y obtener resultados más confiables.
━━━━━━━━━━━━━━━━━━
⚡ RESUMEN ULTRA RÁPIDO
━━━━━━━━━━━━━━━━━━
🔑 LO VERDADERAMENTE IMPORTANTE
QUÉ ES LA VENTANA DE CONTEXTO:
CAPACIDADES ACTUALES:
LOS 3 ERRORES QUE APARECEN CUANDO EL CONTEXTO SE SATURA:
1️⃣ Olvido o alucinación de datos → el modelo deja fuera información que sí le diste o inventa datos que no existen en el documento
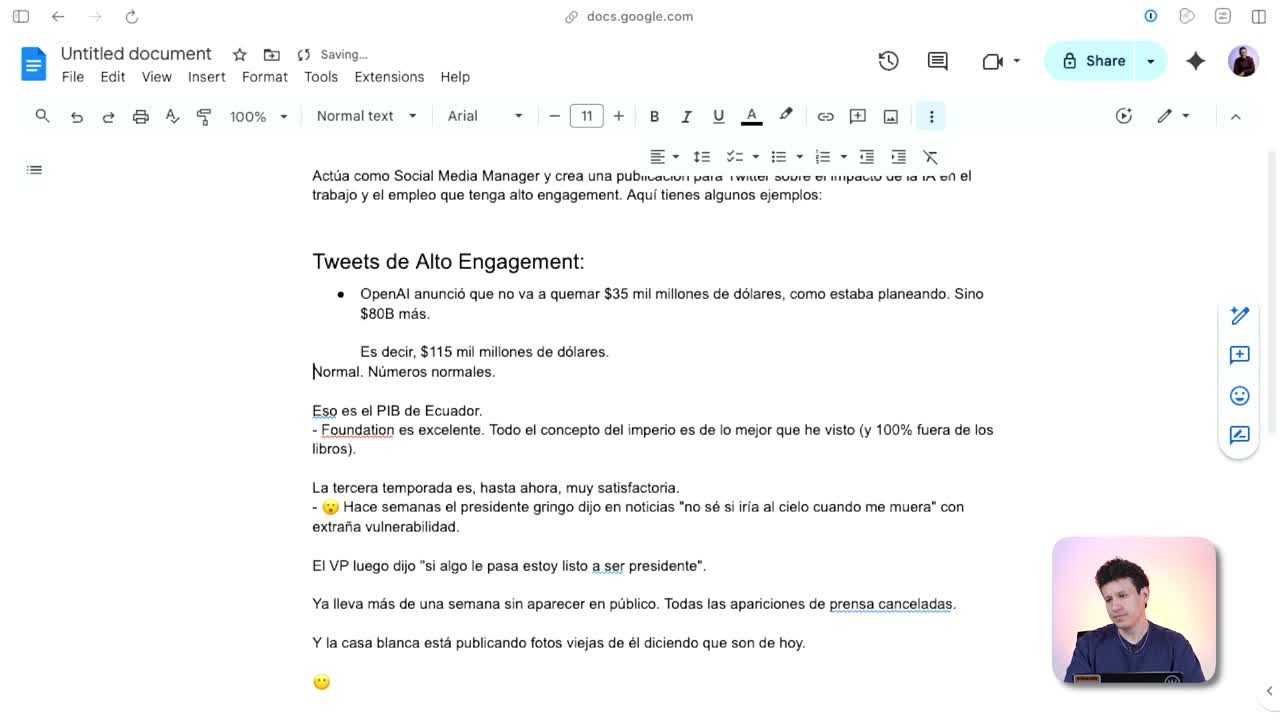
2️⃣ Confusión entre roles → si primero fue researcher y luego social media manager, puede mezclar ambos roles en la misma respuesta
3️⃣ Pérdida de instrucciones → le pediste resúmenes de 500 palabras concisos, pero de pronto vuelve a generar textos largos y genéricos
EL EFECTO "AGUJA EN UN PAJAR":
━━━━━━━━━━━━━━━━━━
🧠 CONCEPTOS QUE DEBO ENTENDER
━━━━━━━━━━━━━━━━━━
🧩 MODELO MENTAL
Contexto = escritorio físico Tokens = páginas que caben sobre él
Si metes 20 páginas en un espacio para 10 → pierdes visibilidad sobre lo importante
Solución: seleccionar qué páginas importan realmente → mantener el escritorio ordenado → reorganizarlo cuando detectes que algo se está perdiendo
Lo más reciente en el escritorio = lo que el modelo mira primero
━━━━━━━━━━━━━━━━━━
🚀 ACCIONES INMEDIATAS
━━━━━━━━━━━━━━━━━━
💼 APLICACIÓN PROFESIONAL
━━━━━━━━━━━━━━━━━━
🔥 HACKS Y RECOMENDACIONES REALES
━━━━━━━━━━━━━━━━━━
📝 REFLEXIÓN ESTRATÉGICA
La ventana de contexto no es un detalle técnico. Es la razón por la que dos personas con el mismo modelo obtienen resultados completamente distintos. Quien entiende sus límites no los combate: los gestiona. Curando el contexto, manteniendo un rol por chat y reforzando instrucciones al final, conviertes un modelo que "olvida" en uno que mantiene el foco. Esa disciplina es lo que separa usar la IA de verdad de solo abrirla y esperar resultados.
Ventana de Contexto y Atención en LLM
Mis notas 💚
Hay que recordarle al final del prompt , resumir de lo que se esta hablando, la otra opcion es empezar un nuevo chat pero antes pegar la conversacion previa
¿Qué pasa si subo demasiados documentos largos?
Si saturas el sistema con cientos de páginas de golpe, diluyes drásticamente la precisión de las respuestas. Aunque herramientas avanzadas puedan aceptar archivos gigantescos, procesar esa magnitud de datos degrada su eficiencia analítica.
Piensa en esto como pedirle a un humano que lea tres libros en una hora y luego te responda una pregunta específica sobre un personaje secundario. La inteligencia artificial intentará escanear todo, pero su mecanismo de atención se dispersará. Empezará a mezclar conceptos de diferentes páginas, inventará datos para llenar vacíos (alucinaciones) o simplemente ignorará secciones enteras. Para obtener resultados precisos y confiables, extrae solo los capítulos o párrafos estrictamente necesarios para tu tarea actual. Menos volumen de texto garantiza una mayor agudeza y exactitud en la respuesta final.
Para esto, en claude, más especificamente en las instrucciones de proyecto, le indico que debe ir contando los mensajes por chat que he compartido y debe considerar la complejidad de archivos y tareas que hay en cada uno, para que cuando se llegue a cierto "límite" donde el registre que puede empezar a alucinar, me aconseje hacer un resumen ejecutivo del chat, si heste ha tendio una linea logica de desarrollo y aprendizaje, para luego pasarlo a un nuevo chat con lecciones aprendidas.
Guía de estudio — Clase 8: Ventana de contexto y modelo de atención en LLMs
1) Núcleo de la clase (lo que tenés que entender sí o sí)
2) Ventana de contexto (concepto + implicancias)
Qué incluye
Tokens
Límites
Qué pasa cuando se desborda
3) Atención (cómo “mira” el modelo el contexto)
Causa típica de confusión
4) Técnicas prácticas para mantener foco y reducir errores (checklist)
Ordenar la mesa (curar contexto)
Señales de prioridad
Verificación activa
Higiene de conversación
5) Qué debería quedarte claro al terminar
6) Confusión típica (para evitarla)
7) Mini-ejercicio (2 minutos)
Tomá una tarea real tuya y reescribí el prompt con este patrón:
MUY BIEN IMPORTANTE INFORMACION SOBRE LAS VENTANAS DE CONTEXTO
Si se sobrepasa el límite de tokens en un modelo de lenguaje, ocurren varios problemas. El modelo puede olvidar información relevante, alucinar datos no relacionados o confundir las tareas que se le han asignado. Esto se debe a que, al exceder la ventana de contexto, el modelo no puede procesar correctamente toda la información, generando respuestas menos precisas y coherentes. Es esencial manejar la entrada de datos de manera efectiva para evitar estos problemas.
Tal cual, Dávila.
Ver al modelo alucinar genera muchísima desconfianza y frustración.
Aprendí a las malas que "más no siempre es mejor". Ahora prefiero curar bien mis archivos y subir solo los fragmentos esenciales, en lugar de saturar la ventana.
Es preferible pasar 5 minutos filtrando que 20 corrigiendo errores. 👌📉
Excelente clase, la mejor información de esta clase es, que los LLM no son perfectos, tienen sus limites y cometen errores.
Lo bello de todo esto es, que si algo no es perfecto, significa que hay oportunidades y no todo el mundo podrá dominar esta nueva herramienta y tener los resultados que se busca.
Los que dominen la herramienta, tendrán las oportunidades.
"pragmáticos" se refiere a que los resúmenes o textos deben ser útiles y enfocados en la acción, para que la IA no se ponga "poética" o divague, sino que entregue información concisa y relevante.