








Me puse a iterar con las funciones en un df y me encanto. Ideal para poder categorizar mejor tus datos.

Funciones de Resumen y Estadísticas en Pandas
Vamos a explorar algunas funciones de resumen y estadísticas que podemos utilizar con nuestro DataFrame.
Uso de describe() para obtener un resumen estadístico.
`# Resumen estadístico
summary = retail_data.describe()
print("Resumen estadístico:\\n", summary)`
Cálculo de la media y mediana.
Media:
mean_value = retail_data['Quantity'].mean()
print("Media de Quantity:", mean_value)
Mediana:
median_value = retail_data['Quantity'].median()
print("Mediana de Quantity:", median_value)
Suma y conteo de valores.
Suma:
total_sum = retail_data['Quantity'].sum()
print("Suma de Quantity:", total_sum)
Conteo de valores:
count_values = retail_data['Quantity'].count()
print("Conteo de Quantity:", count_values)
Desviación estándar y varianza.
Desviación estándar:
std_dev = retail_data['Quantity'].std()
print("Desviación estándar de Quantity:", std_dev)
Varianza
variance = retail_data['Quantity'].var()
print("Varianza de Quantity:", variance)
Mínimo, Máximo y Producto.
Mínimo:
min_value = retail_data['Quantity'].min()
print("Mínimo de Quantity:", min_value)
Máximo:
max_value = retail_data['Quantity'].max()
print("Máximo de Quantity:", max_value)
Producto:
prod_value = retail_data['Quantity'].prod()
print("Producto de Quantity:", prod_value)
Curso de Python para Ciencia de Datos
Clase 14 / 32
Curso de Python para Ciencia de Datos
Clase 14 / 32
Vamos a explorar algunas funciones de resumen y estadísticas que podemos utilizar con nuestro DataFrame.
describe() para obtener un resumen estadístico.`# Resumen estadístico
summary = retail_data.describe()
print("Resumen estadístico:\\n", summary)`
mean_value = retail_data['Quantity'].mean()
print("Media de Quantity:", mean_value)
median_value = retail_data['Quantity'].median()
print("Mediana de Quantity:", median_value)
total_sum = retail_data['Quantity'].sum()
print("Suma de Quantity:", total_sum)
count_values = retail_data['Quantity'].count()
print("Conteo de Quantity:", count_values)
std_dev = retail_data['Quantity'].std()
print("Desviación estándar de Quantity:", std_dev)
variance = retail_data['Quantity'].var()
print("Varianza de Quantity:", variance)
min_value = retail_data['Quantity'].min()
print("Mínimo de Quantity:", min_value)
max_value = retail_data['Quantity'].max()
print("Máximo de Quantity:", max_value)
prod_value = retail_data['Quantity'].prod()
print("Producto de Quantity:", prod_value)
Me puse a iterar con las funciones en un df y me encanto. Ideal para poder categorizar mejor tus datos.
Además de la función head() existen otras dos funciones similares:
Tanto head(), tail() y sample() son de gran utilidad a la hora de darle un primer vistazo a los datos, y así podemos darnos una idea de que podemos hacer posteriormente en nuestros análisis.
Les dejo un código que les puede servir cuando hagan Limpieza de datos y EDA:
A = pd.DataFrame({'Num': [4, None, 9, None, 77]})
B = pd.DataFrame({'Num': [44, None, 6, 22, None]})

null_A = A[A.Num.isna() == True].index
null_B = B[B.Num.isna() == True].index
null_A.intersection(null_B)
```Les servirá para cuando quieran saber cuantas filas o registros de valores nulos o faltantes de dos o más columnas comparten y así sacar un porcentaje que les ayude a entender mejor cómo están distribuidos esos datos nulos entre las columnas.
### Estructuras de Datos en Pandas y Funciones
Antonio Demarco Bonino
Germán García
Fidel Ortega Guzman
Paola Alapizco
Neicer Vásquez

Alejandro Gonzalez
Mario Alexander Vargas Celis
Alberto Duque Villegas
Roberto Arriaga

Bernardo Jimenez Sanchez
Esteban Diaz Diez

Gabriel Obregón
Jesús Alberto Romero Hernández
Jhon Alexander Mosquera Vanegas

José Arturo Melgar Martínez
Erick Leonardo Castañeda Gomez

Paul Andrés Andia Frias

Elias Echeverri
Cristian Alexander Vallejos De la rosa

Saul Antonio Cerén Gálvez
Saul Antonio Cerén Gálvez
Fernando Alvarado
Johann Camilo Soracá Zea

Pamela Natalie Reintsch Ortiz
Tino Ponce
Pandas proporciona dos estructuras de datos principales: **Series** y **DataFrame**, que permiten el análisis y manipulación de datos de una manera muy eficiente.
---
### 1. **Series**
Una **Series** es una estructura unidimensional similar a un array, lista o columna de una tabla. Cada elemento en una Series tiene una **etiqueta** o **índice**, lo que la convierte en una estructura de datos similar a un diccionario, con pares clave-valor.
#### Creación de una Serie:
import pandas as pd


\# Crear una Serie desde una lista

serie = pd.Series(\[10, 20, 30, 40])


\# Crear una Serie con índices personalizados

serie\_personalizada = pd.Series(\[100, 200, 300], index=\['a', 'b', 'c'])


print(serie)

print(serie\_personalizada)
**Funciones importantes en Series:**
- **.head()**: Devuelve los primeros elementos de la Serie.
- **.tail()**: Devuelve los últimos elementos de la Serie.
- **.sum()**: Suma de todos los elementos.
- **.mean()**: Media de los elementos.
- **.max(), .min()**: Máximo y mínimo valor de la Serie.
- **.describe()**: Proporciona un resumen estadístico.
- **.value_counts()**: Cuenta los valores únicos en la Serie.
---
### 2. **DataFrame**
Un **DataFrame** es una estructura de datos bidimensional con columnas etiquetadas, que puede contener datos de diferentes tipos (números, cadenas, booleanos). Es la estructura más utilizada en Pandas y se puede entender como una tabla de datos similar a una hoja de cálculo o una tabla SQL.
#### Creación de un DataFrame:
\# Crear un DataFrame desde un diccionario

data = {

    'Nombre': \['Ana', 'Luis', 'Carlos'],

    'Edad': \[23, 45, 36],

    'Ciudad': \['Madrid', 'Barcelona', 'Valencia']

}


df = pd.DataFrame(data)


print(df)
#### Funciones comunes en DataFrame:
- **.shape**: Muestra las dimensiones (filas, columnas) del DataFrame.
- **.info()**: Proporciona información sobre el DataFrame (tipo de datos, valores nulos, etc.).
- **.describe()**: Devuelve estadísticas descriptivas de las columnas numéricas.
- **.head(n)**: Muestra las primeras n filas del DataFrame.
- **.tail(n)**: Muestra las últimas n filas.
- **.columns**: Devuelve los nombres de las columnas.
- **.dtypes**: Devuelve los tipos de datos de las columnas.
#### Indexación en DataFrames:
Puedes acceder a columnas, filas o subconjuntos de datos mediante diferentes métodos.
- **Acceder a columnas**:
\# Acceder a una columna específica

df\['Nombre']


\# Acceder a varias columnas

df\[\['Nombre', 'Edad']]
- **Acceder a filas** (con .loc\[] o .iloc\[]):
\# Acceder a una fila por etiqueta (índice)

df.loc\[0]


\# Acceder a una fila por posición

df.iloc\[0]
---
### 3. **Funciones para Manipulación de Datos**
#### A) **Seleccionar Datos**
Puedes seleccionar datos de un DataFrame utilizando **condiciones**:
\# Filtrar filas donde la edad sea mayor que 30

df\_filtrado = df\[df\['Edad'] > 30]

print(df\_filtrado)
#### B) **Añadir, Modificar y Eliminar Columnas**
- **Añadir columnas**:
df\['Salario'] = \[3000, 4000, 5000] # Añadir una nueva columna
- **Modificar columnas**:
df\['Edad'] = df\['Edad'] + 5 # Incrementar la edad en 5 años
- **Eliminar columnas**:
df = df.drop(columns=\['Salario']) # Eliminar la columna 'Salario'
#### C) **Agrupación y Agregación de Datos**
- **groupby()**: Agrupa los datos según una columna y aplica funciones agregadas como sum, mean, count, etc.
df\_agrupado = df.groupby('Ciudad')\['Edad'].mean()

print(df\_agrupado)
#### D) **Operaciones de Fusión y Unión**
- **concat()**: Para unir DataFrames vertical u horizontalmente.
df1 = pd.DataFrame({'A': \[1, 2], 'B': \[3, 4]})

df2 = pd.DataFrame({'A': \[5, 6], 'B': \[7, 8]})


df\_concatenado = pd.concat(\[df1, df2], axis=0)  # Unión vertical
- **merge()**: Para combinar DataFrames sobre la base de columnas o índices comunes.
df\_left = pd.DataFrame({'key': \['A', 'B', 'C'], 'left\_value': \[1, 2, 3]})

df\_right = pd.DataFrame({'key': \['B', 'C', 'D'], 'right\_value': \[4, 5, 6]})


df\_merge = pd.merge(df\_left, df\_right, on='key', how='inner')  # Unión por 'key'

print(df\_merge)
#### E) **Manejo de Datos Faltantes**
- **isnull()**: Devuelve un DataFrame con valores True donde hay valores nulos.
- **dropna()**: Elimina filas o columnas con valores nulos.
- **fillna()**: Rellena los valores nulos con un valor específico.
df = pd.DataFrame({'A': \[1, None, 3], 'B': \[4, 5, None]})


\# Rellenar valores nulos

df\_relleno = df.fillna(0)


\# Eliminar filas con valores nulos

df\_sin\_na = df.dropna()
#### F) **Ordenar Datos**
- **sort_values()**: Ordena los datos por valores de una columna.
df\_ordenado = df.sort\_values(by='Edad', ascending=False)

print(df\_ordenado)
---
### 4. **Funciones Estadísticas en Pandas**
Pandas tiene una variedad de funciones estadísticas útiles para análisis de datos:
- **.sum()**: Suma de los valores.
- **.mean()**: Media de los valores.
- **.median()**: Mediana de los valores.
- **.std()**: Desviación estándar.
- **.corr()**: Correlación entre columnas.
- **.count()**: Número de valores no nulos.
\# Ejemplo de uso de funciones estadísticas

df\['Edad'].mean()   # Media de la columna 'Edad'

df\['Edad'].std()    # Desviación estándar

df.corr()           # Correlación entre las columnas numéricas
---
### Conclusión
Pandas es una herramienta muy poderosa para la manipulación y análisis de datos. Con sus estructuras de datos principales (Series y DataFrame) y una amplia gama de funciones y métodos, es posible realizar operaciones complejas de manera eficiente. Esencial para la ciencia de datos, análisis financiero, procesamiento de archivos grandes y más.
Encontré algunos pequeños errores en el notebook aportado como recurso en esta lección:
mean_value = daily_sales.mean()
print('La media es', mean_value)

median_value = daily_sales.median()
print('La mediana es', mean_value)

sum_value = daily_sales.sum()
print('La suma total es', mean_value)
El error consiste en que el argumento del print, en los tres casos, es mean_value.
El código correcto debería ser:
## Estadísticos básicos para series o columnas determinadas:

mean_value = daily_sales.mean() # Media
print('La media es', mean_value)

median_value = daily_sales.median() # Mediana
print('La mediana es', median_value)

sum_value = daily_sales.sum() # Suma
print('La suma total es', sum_value)
```## Estadísticos básicos para series o columnas determinadas:


mean\_value = daily\_sales.mean() # Media

print('La media es', mean\_value)


median\_value = daily\_sales.median() # Mediana

print('La mediana es', median\_value)


sum\_value = daily\_sales.sum() # Suma

print('La suma total es', sum\_value)
Hola Karli, ¿porque cuando calculas la media no especificas el nombre de la columna? y en este caso la media se calculó sobre la columna Quantity
1) Extracción de Nombres de Columnas: columns_names = retail_data.columns
print(columns_names)
Salida: Index(['InvoiceNo', 'StockCode', 'Description', 'Quantity', 'InvoiceDate',
'UnitPrice', 'CustomerID', 'Country'],
dtype='object')
2) Número de Filas y Columnas:num_rows, num_columns = retail_data.shape
print('Número de filas', num_rows)
print('Número de columnas', num_columns)
Salida: Número de filas 541909
Número de columnas 8
3) Acceso a la Columna (Quantity):daily_sales = retail_data['Quantity']
print(daily_sales)
print(daily_sales[2])
Estadísticas Resumidas:summary = retail_data.describe()
print(summary)
4) Media de Quantity: mean_value = daily_sales.mean()
print('La media es', mean_value)
2) Mediana de Quantity: median_value = daily_sales.median()
print('La mediana es', median_value)
6) Suma de Quantity: sum_value = daily_sales.sum()
print('La suma total es', sum_value)
7) Conteo de Valores No Nulos en Quantity: count_values = daily_sales.count()
print(count_values)
8) Operaciones en una Serie de Pandas: daily_sales = pd.Series([10, 20, None, 40, 50])
total_sum = daily_sales.sum()
Como es de saber, las funciones estadísticas (a excepción de describe( )) son solo aplicables a valores numéricos (Int o Float). Debido a que muchos DataFrames (incluido el de la clase) poseen columnas con datos tipo strigs, al aplicicar estas funciones directamente el IDE envia un error de tipo ValueError. Dos maneras de saber que columnas poseen solo valores numéricos es usar la función describe( ) o usar el método select_dtypes():
numeric_df = df.select_dtypes(include=['number'])
La rutina que sugiere la clase para empezar con cualquier DataFrame, primero una muestra de filas con head, luego la descripción estadística y después columna por columna, se puede reforzar con un truco de lógica: el conteo entrega el número de valores no nulos, y el número de filas se conoce por la dimensión del DataFrame. Si una columna cuenta menos valores que filas tiene el DataFrame, faltan datos. Es decir, dos consultas de exploración ya delatan un problema de calidad antes de calcular una sola media. Para un reporte, esa comprobación debería quedar escrita en el cuaderno como primer paso.
# Seleccionar ambas columnas usando doble corchete
daily_sales = retail_data[['Country', 'UnitPrice']]
print(daily_sales.head())  # Muestra las primeras filas

# Para acceder a la tercera fila (índice 2) de este sub-dataframe:
print("\nFila en el índice 2:")
print(daily_sales.iloc[2])

# Extraer la columna de precios unitarios
unit_prices = retail_data['UnitPrice']

# Calcular estadísticas
mean_price = unit_prices.mean()
median_price = unit_prices.median()
total_sum_price = unit_prices.sum()

# Mostrar resultados
print(f"Media de UnitPrice: {mean_price:.2f}")
print(f"Mediana de UnitPrice: {median_price:.2f}")
print(f"Suma total de UnitPrice: {total_sum_price:.2f}")
Me puse a iterar con las funciones en un df y me encanto. Ideal para poder categorizar mejor tus datos.
# Ejemplo de comentario data = { 'Nombre': ['Anna', 'Luis', 'Carlos', 'Maria'], 'Edad': [28, 34, 29, 42], 'Ciudad': ['Monterrey', 'Gdl', 'DF', 'Cancun'] } #print(data) df = pd.DataFrame(data) print('DataFrame:\n', df) def categorizar_edad(edad): if edad < 30: return 'Joven' else: return 'Viejo' df['Categoria'] = df['Edad'].apply(categorizar_edad) print('\nDataFrame con categoria de edad:\n', df)
muy bien
Además de la función head() existen otras dos funciones similares:
Tanto head(), tail() y sample() son de gran utilidad a la hora de darle un primer vistazo a los datos, y así podemos darnos una idea de que podemos hacer posteriormente en nuestros análisis.
Les dejo un código que les puede servir cuando hagan Limpieza de datos y EDA:
A = pd.DataFrame({'Num': [4, None, 9, None, 77]}) B = pd.DataFrame({'Num': [44, None, 6, 22, None]}) null_A = A[A.Num.isna() == True].index null_B = B[B.Num.isna() == True].index null_A.intersection(null_B) ```Les servirá para cuando quieran saber cuantas filas o registros de valores nulos o faltantes de dos o más columnas comparten y así sacar un porcentaje que les ayude a entender mejor cómo están distribuidos esos datos nulos entre las columnas.
yo halle este investigando como encontrara los lugares donde hay null en un df
data_null = df.isnull()
null_positions = data_null[data_null == True].stack().index.tolist()
print(f"Positions of null values:\n{null_positions}")
primero ubica todos los null en formato df, luego le aplica el método stack con su índex y luego hace un diccionario con todo aquello
### Estructuras de Datos en Pandas y Funciones
Pandas proporciona dos estructuras de datos principales: **Series** y **DataFrame**, que permiten el análisis y manipulación de datos de una manera muy eficiente.
---
### 1. **Series**
Una **Series** es una estructura unidimensional similar a un array, lista o columna de una tabla. Cada elemento en una Series tiene una **etiqueta** o **índice**, lo que la convierte en una estructura de datos similar a un diccionario, con pares clave-valor.
#### Creación de una Serie:
import pandas as pd \# Crear una Serie desde una lista serie = pd.Series(\[10, 20, 30, 40]) \# Crear una Serie con índices personalizados serie\_personalizada = pd.Series(\[100, 200, 300], index=\['a', 'b', 'c']) print(serie) print(serie\_personalizada)
**Funciones importantes en Series:**
- **.head()**: Devuelve los primeros elementos de la Serie.
- **.tail()**: Devuelve los últimos elementos de la Serie.
- **.sum()**: Suma de todos los elementos.
- **.mean()**: Media de los elementos.
- **.max(), .min()**: Máximo y mínimo valor de la Serie.
- **.describe()**: Proporciona un resumen estadístico.
- **.value_counts()**: Cuenta los valores únicos en la Serie.
---
### 2. **DataFrame**
Un **DataFrame** es una estructura de datos bidimensional con columnas etiquetadas, que puede contener datos de diferentes tipos (números, cadenas, booleanos). Es la estructura más utilizada en Pandas y se puede entender como una tabla de datos similar a una hoja de cálculo o una tabla SQL.
#### Creación de un DataFrame:
\# Crear un DataFrame desde un diccionario data = {   'Nombre': \['Ana', 'Luis', 'Carlos'],   'Edad': \[23, 45, 36],   'Ciudad': \['Madrid', 'Barcelona', 'Valencia'] } df = pd.DataFrame(data) print(df)
#### Funciones comunes en DataFrame:
- **.shape**: Muestra las dimensiones (filas, columnas) del DataFrame.
- **.info()**: Proporciona información sobre el DataFrame (tipo de datos, valores nulos, etc.).
- **.describe()**: Devuelve estadísticas descriptivas de las columnas numéricas.
- **.head(n)**: Muestra las primeras n filas del DataFrame.
- **.tail(n)**: Muestra las últimas n filas.
- **.columns**: Devuelve los nombres de las columnas.
- **.dtypes**: Devuelve los tipos de datos de las columnas.
#### Indexación en DataFrames:
Puedes acceder a columnas, filas o subconjuntos de datos mediante diferentes métodos.
- **Acceder a columnas**:
\# Acceder a una columna específica df\['Nombre'] \# Acceder a varias columnas df\[\['Nombre', 'Edad']]
- **Acceder a filas** (con .loc\[] o .iloc\[]):
\# Acceder a una fila por etiqueta (índice) df.loc\[0] \# Acceder a una fila por posición df.iloc\[0]
---
### 3. **Funciones para Manipulación de Datos**
#### A) **Seleccionar Datos**
Puedes seleccionar datos de un DataFrame utilizando **condiciones**:
\# Filtrar filas donde la edad sea mayor que 30 df\_filtrado = df\[df\['Edad'] > 30] print(df\_filtrado)
#### B) **Añadir, Modificar y Eliminar Columnas**
- **Añadir columnas**:
df\['Salario'] = \[3000, 4000, 5000] # Añadir una nueva columna
- **Modificar columnas**:
df\['Edad'] = df\['Edad'] + 5 # Incrementar la edad en 5 años
- **Eliminar columnas**:
df = df.drop(columns=\['Salario']) # Eliminar la columna 'Salario'
#### C) **Agrupación y Agregación de Datos**
- **groupby()**: Agrupa los datos según una columna y aplica funciones agregadas como sum, mean, count, etc.
df\_agrupado = df.groupby('Ciudad')\['Edad'].mean() print(df\_agrupado)
#### D) **Operaciones de Fusión y Unión**
- **concat()**: Para unir DataFrames vertical u horizontalmente.
df1 = pd.DataFrame({'A': \[1, 2], 'B': \[3, 4]}) df2 = pd.DataFrame({'A': \[5, 6], 'B': \[7, 8]}) df\_concatenado = pd.concat(\[df1, df2], axis=0) # Unión vertical
- **merge()**: Para combinar DataFrames sobre la base de columnas o índices comunes.
df\_left = pd.DataFrame({'key': \['A', 'B', 'C'], 'left\_value': \[1, 2, 3]}) df\_right = pd.DataFrame({'key': \['B', 'C', 'D'], 'right\_value': \[4, 5, 6]}) df\_merge = pd.merge(df\_left, df\_right, on='key', how='inner') # Unión por 'key' print(df\_merge)
#### E) **Manejo de Datos Faltantes**
- **isnull()**: Devuelve un DataFrame con valores True donde hay valores nulos.
- **dropna()**: Elimina filas o columnas con valores nulos.
- **fillna()**: Rellena los valores nulos con un valor específico.
df = pd.DataFrame({'A': \[1, None, 3], 'B': \[4, 5, None]}) \# Rellenar valores nulos df\_relleno = df.fillna(0) \# Eliminar filas con valores nulos df\_sin\_na = df.dropna()
#### F) **Ordenar Datos**
- **sort_values()**: Ordena los datos por valores de una columna.
df\_ordenado = df.sort\_values(by='Edad', ascending=False) print(df\_ordenado)
---
### 4. **Funciones Estadísticas en Pandas**
Pandas tiene una variedad de funciones estadísticas útiles para análisis de datos:
- **.sum()**: Suma de los valores.
- **.mean()**: Media de los valores.
- **.median()**: Mediana de los valores.
- **.std()**: Desviación estándar.
- **.corr()**: Correlación entre columnas.
- **.count()**: Número de valores no nulos.
\# Ejemplo de uso de funciones estadísticas df\['Edad'].mean() # Media de la columna 'Edad' df\['Edad'].std() # Desviación estándar df.corr() # Correlación entre las columnas numéricas
---
### Conclusión
Pandas es una herramienta muy poderosa para la manipulación y análisis de datos. Con sus estructuras de datos principales (Series y DataFrame) y una amplia gama de funciones y métodos, es posible realizar operaciones complejas de manera eficiente. Esencial para la ciencia de datos, análisis financiero, procesamiento de archivos grandes y más.
Encontré algunos pequeños errores en el notebook aportado como recurso en esta lección:
mean_value = daily_sales.mean() print('La media es', mean_value) median_value = daily_sales.median() print('La mediana es', mean_value) sum_value = daily_sales.sum() print('La suma total es', mean_value)
El error consiste en que el argumento del print, en los tres casos, es mean_value.
El código correcto debería ser:
## Estadísticos básicos para series o columnas determinadas: mean_value = daily_sales.mean() # Media print('La media es', mean_value) median_value = daily_sales.median() # Mediana print('La mediana es', median_value) sum_value = daily_sales.sum() # Suma print('La suma total es', sum_value) ```## Estadísticos básicos para series o columnas determinadas: mean\_value = daily\_sales.mean() # Media print('La media es', mean\_value) median\_value = daily\_sales.median() # Mediana print('La mediana es', median\_value) sum\_value = daily\_sales.sum() # Suma print('La suma total es', sum\_value)
Así es, el código compartido tiene pequeñitos errores, los que pueden versa más afectados por lo anterior son aquellos que tengan poca experiencia con estas herramientas; en mi caso, he leído y hecho ejercicios parecidos a estos, entonces detectar estos errores fue fácil para mí. Ojalá el Platzi Team remedie estos deslices, además en una clase anterior también hay otro despiste, en fin...
nadie es perfecto
Hola Karli, ¿porque cuando calculas la media no especificas el nombre de la columna? y en este caso la media se calculó sobre la columna Quantity
Hola Compañero, en este caso no se pone el nombre de la columna porque calculó la media sobre la variable llamada 'daily_sales' que ya contiene la información de la columna Quantity.
Operaciones y Descripciones
1) Extracción de Nombres de Columnas: columns_names = retail_data.columns
print(columns_names)
Salida: Index(['InvoiceNo', 'StockCode', 'Description', 'Quantity', 'InvoiceDate',
'UnitPrice', 'CustomerID', 'Country'],
dtype='object')
2) Número de Filas y Columnas:num_rows, num_columns = retail_data.shape
print('Número de filas', num_rows)
print('Número de columnas', num_columns)
Salida: Número de filas 541909
Número de columnas 8
3) Acceso a la Columna (Quantity):daily_sales = retail_data['Quantity']
print(daily_sales)
print(daily_sales[2])
Estadísticas Resumidas:summary = retail_data.describe()
print(summary)
4) Media de Quantity: mean_value = daily_sales.mean()
print('La media es', mean_value)
2) Mediana de Quantity: median_value = daily_sales.median()
print('La mediana es', median_value)
6) Suma de Quantity: sum_value = daily_sales.sum()
print('La suma total es', sum_value)
7) Conteo de Valores No Nulos en Quantity: count_values = daily_sales.count()
print(count_values)
8) Operaciones en una Serie de Pandas: daily_sales = pd.Series([10, 20, None, 40, 50])
total_sum = daily_sales.sum()
print("Suma de Quantity:", total_sum)
count_values = daily_sales.count()
print("Conteo de Quantity:", count_values)
9) Vista Previa del DataFrame:retail_data.head()
retail_data.head(8)
Aplicacion de funciones o métodos estadísticos (mean(), median(), var(), etc...) a DataFrames.
Como es de saber, las funciones estadísticas (a excepción de describe( )) son solo aplicables a valores numéricos (Int o Float). Debido a que muchos DataFrames (incluido el de la clase) poseen columnas con datos tipo strigs, al aplicicar estas funciones directamente el IDE envia un error de tipo ValueError. Dos maneras de saber que columnas poseen solo valores numéricos es usar la función describe( ) o usar el método select_dtypes():
numeric_df = df.select_dtypes(include=['number'])
La rutina que sugiere la clase para empezar con cualquier DataFrame, primero una muestra de filas con head, luego la descripción estadística y después columna por columna, se puede reforzar con un truco de lógica: el conteo entrega el número de valores no nulos, y el número de filas se conoce por la dimensión del DataFrame. Si una columna cuenta menos valores que filas tiene el DataFrame, faltan datos. Es decir, dos consultas de exploración ya delatan un problema de calidad antes de calcular una sola media. Para un reporte, esa comprobación debería quedar escrita en el cuaderno como primer paso.
# Seleccionar ambas columnas usando doble corchete daily_sales = retail_data[['Country', 'UnitPrice']] print(daily_sales.head()) # Muestra las primeras filas # Para acceder a la tercera fila (índice 2) de este sub-dataframe: print("\nFila en el índice 2:") print(daily_sales.iloc[2]) # Extraer la columna de precios unitarios unit_prices = retail_data['UnitPrice'] # Calcular estadísticas mean_price = unit_prices.mean() median_price = unit_prices.median() total_sum_price = unit_prices.sum() # Mostrar resultados print(f"Media de UnitPrice: {mean_price:.2f}") print(f"Mediana de UnitPrice: {median_price:.2f}") print(f"Suma total de UnitPrice: {total_sum_price:.2f}")
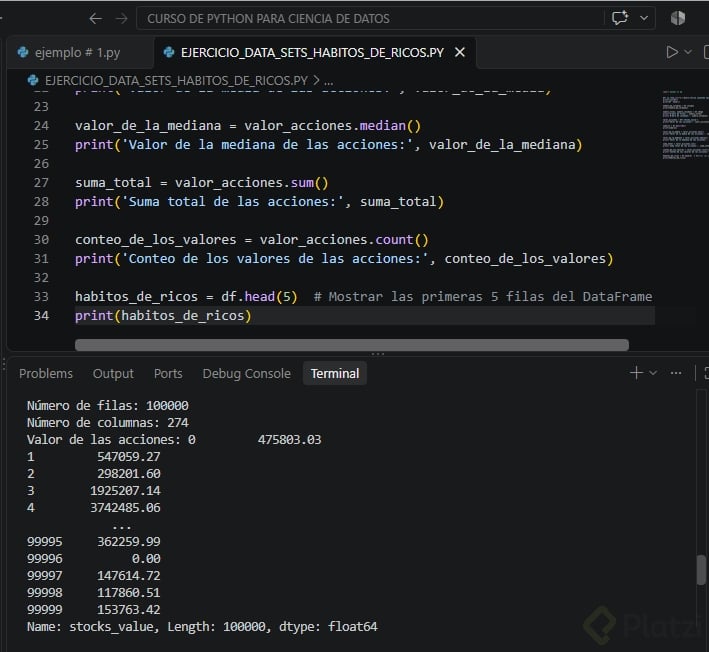
descargué un data set y lo realice en python
SERIE: En pandas es una estructura de datos unidimensional que almacena datos de cualquier tipo. Un ejemplo es una Columna de una tabla.
DATAFRAME: Es una estructura bidimensional similar a una tabla en una base de datos.
file_path = '/content/OnlineRetail.csv'sales_data = pd.read_csv(file_path, encoding='ISO-8859-1')sales_data.head()
Recuerda que Estamos enfocados en atender y brindar espacios para nomadas digitales, teletrabajo y coworking space en Agrolenials Paradise Ecohostel Country Inns contacto directo whatsapp +573206299333 y Faccebook
MOdelo coworcountry o modelo coworculture con muchas actividades para pausas activas y acompañamiento de tu rol profesional
# Tarea: Ejercicio adicional con otra columna del df
precios = df_retail_data['UnitPrice']
print("Precios:\n", precios)
print("Precio Fila 3:", precios[3])
print("Minimo:", precios.min())
print("Promedio:", precios.mean())
print("Mediana:", precios.median())
print("Maximo:", precios.max())
print("Conteo:", precios.count())
print("Conteo valores:", precios.value_counts())
print("Estadistica:\n", precios.describe())
print("Percentil 90%:\n", precios.describe(percentiles=[0.9]))
print("Primeros 5 registros:\n", precios.head())
###
Precios:
0 2.55
1 3.39
2 2.75
3 3.39
4 3.39
...
541904 0.85
541905 2.10
541906 4.15
541907 4.15
541908 4.95
Name: UnitPrice, Length: 541909, dtype: float64
Precio Fila 3: 3.39
Minimo: -11062.06
Promedio: 4.611113626088513
Mediana: 2.08
Maximo: 38970.0
Conteo: 541909
Conteo valores: UnitPrice
1.25 50496
1.65 38181
0.85 28497
2.95 27768
0.42 24533
...
11586.50 1
254.43 1
888.06 1
1.07 1
0.52 1
Name: count, Length: 1630, dtype: int64
Estadistica:
count 541909.000000
mean 4.611114
std 96.759853
min -11062.060000
25% 1.250000
50% 2.080000
75% 4.130000
max 38970.000000
Name: UnitPrice, dtype: float64
Percentil 90%:
count 541909.000000
mean 4.611114
std 96.759853
min -11062.060000
50% 2.080000
90% 7.950000
max 38970.000000
Name: UnitPrice, dtype: float64
Primeros 5 registros:
0 2.55
1 3.39
2 2.75
3 3.39
4 3.39
Name: UnitPrice, dtype: float64
import matplotlib.pyplot as plt
# 1. Preparamos los datos: contamos cuántos productos tiene cada marca
# Tomamos las 10 marcas con más presencia
top_marcas = df['brands'].value_counts().head(10)
# 2. Creamos la gráfica
plt.figure(figsize=(10, 6)) # Tamaño de la imagen
top_marcas.plot(kind='bar', color='skyblue', edgecolor='black')
# 3. Personalización del gráfico (Títulos y etiquetas)
plt.title('Top 10 Marcas por Cantidad de Productos', fontsize=15)
plt.xlabel('Marca', fontsize=12)
plt.ylabel('Número de Productos', fontsize=12)
plt.xticks(rotation=45) # Rotamos los nombres para que se lean bien
plt.grid(axis='y', linestyle='--', alpha=0.7)
# 4. Mostrar la gráfica
plt.tight_layout()
plt.show()

import requests
import urllib3
import pandas as pd
urllib3.disable_warnings(urllib3.exceptions.InsecureRequestWarning)
# --- ESTA ES UNA URL REAL DE PRUEBA (Open Food Facts - Cosméticos) ---
url_retail = "https://world.openfoodfacts.org/api/v2/search?categories\_tags=en:creams\&fields=code,product\_name,brands,price"
try:
print(f"Conectando a: {url_retail}...")
# El GET con el bypass de seguridad que ya probamos que te funciona
r = requests.get(url_retail, timeout=15, verify=False)
if r.status_code == 200:
# En esta API, los productos vienen dentro de una 'llave' llamada 'products'
json_recibido = r.json()
df = pd.json_normalize(json_recibido['products'])
print(f"✅ ¡CONEXIÓN EXITOSA!")
print(f"📊 Se han descargado {len(df)} productos de retail.")
# Mostramos los resultados
print("\nTabla de productos obtenida:")
print(df[['product_name', 'brands']].head()) # Mostramos nombre y marca
else:
print(f"❌ Error del servidor: {r.status_code}")
except Exception as e:
print(f"🚨 Error: {e}")
Conectando a: ,product_name,brands,price...
✅ ¡CONEXIÓN EXITOSA!
📊 Se han descargado 20 productos de retail.
Tabla de productos obtenida:
product_name brands
0 Kiri carré 8p Kiri
1 crème cuisson Jaouda
2 Crempro gastro mixte
3 Crème sous pression à la vanille 250g Isigny Sainte-Mère
4 La crème des chefs ferme et onctueuse gastrono... President
conteo_marcas = df['brands'].value_counts()
print("Top de marcas en el inventario:")
print(conteo_marcas.head())
Top de marcas en el inventario:
brands
Bridélice 4
Jaouda 2
Kiri 1
gastro mixte 1
Isigny Sainte-Mère 1
Name: count, dtype: int64
roductos_kiri = df[df['brands'] == 'Kiri']
print(productos_kiri[['product_name', 'code']])
product_name code
0 Kiri carré 8p 6111028000980
El método describe() en Pandas muestra estadísticas solo para columnas numéricas de tu DataFrame. Si solo aparecen 3 columnas, significa que solo esas columnas contienen datos numéricos. Las columnas no numéricas, como cadenas de texto, no se incluirán en el resultado. Puedes utilizar el método info() para verificar el tipo de datos de cada columna y asegurarte de que las columnas que esperas analizar son numéricas. Así podrás tomar decisiones informadas sobre cómo limpiar o transformar tus datos.
Esta es la respuesta al ejercicio
#capturar una de las columnas otro ejercicio de practica precio_unitario=retail_data['UnitPrice'] print(precio_unitario[4]) print('============================================================================================================') mean_valor=precio_unitario.mean()print('La media es: ', mean_valor) print('============================================================================================================') mediana_valor=precio_unitario.median()print('La mediana es: ', mediana_valor) print('============================================================================================================') suma_valor=precio_unitario.sum()print('La suma es: ', suma_valor) print('============================================================================================================') conteo_ventas_diarias=precio_unitario.count()print('La cuenta es: ', conteo_ventas_diarias)
#Contar los Nones/Nulls totales por columna A = pd.DataFrame({'Num': [7, None, 9, None, 11, 23, 45, None]}) conteo_nas = A.isna().sum() print(conteo_nas)
file_path = '/content/OnlineRetail.csv'sales_data = pd.read_csv(file_path, encoding='ISO-8859-1')sales_data.head()
print("Suma de Quantity:", total_sum)
count_values = daily_sales.count()
print("Conteo de Quantity:", count_values)
9) Vista Previa del DataFrame:retail_data.head()
retail_data.head(8)