📝 Mis apuntes de esta clase:
Datos Faltantes
Los datos faltantes, por lo general son valores nulos o bien valores que están fuera de rango (según la variable).
Los datos pueden faltar en nuestro dataset por varias razones:
- Datos no disponibles a la hora de la recolección.
- Errores durante el almacenamiento.
- Errores en la recolección.
Durante el proceso de limpieza de datos se les da tratamiento a los valores faltantes, que pueden ser:
- Imputación (rellenar los faltantes con valores conocidos, ej: media, mediana)
- Eliminación
Para buscar valores faltantes pandas nos provee dos funciones:
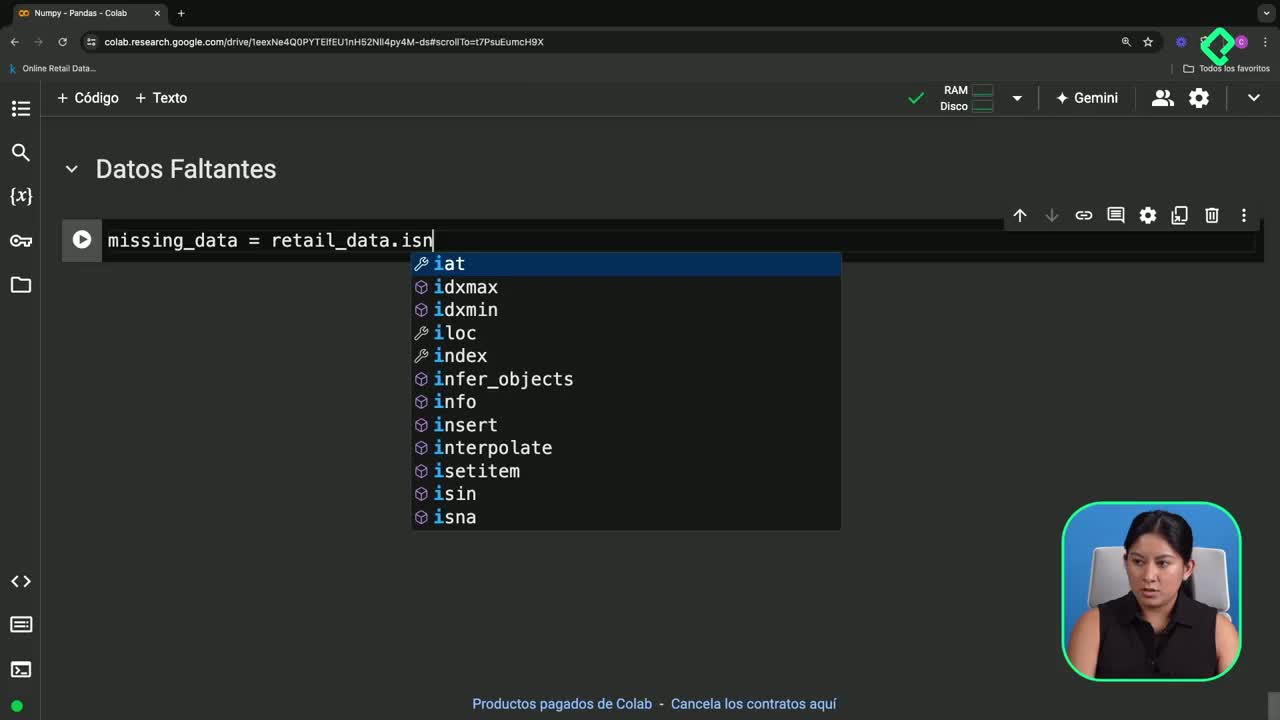
- isna()
- isnull()
Ambdas funciones regresan un DataFrame booleano, donde:
- False: El dato NO es faltante.
- True: El dato SI es faltante.
Al DataFrame resultante podemos aplicarle la función sum() y obtendremos una Serie con el conteo (sumatoria) de los valores en True, el índice de la serie es el nombre de la columna.
# Cuantos faltantes tenemos en total?
total_missing = retail_df.isna().sum().sum()
print(f"Total de valores faltantes: {total_missing}")
# Cuantos faltantes tenemos por columna?
total_missing_column = retail_df.isnull().sum()
print("Total de valores faltantes por cada columna:\n", total_missing_column)

# Cual es la proporción de faltatantes respecto a total de registros?
lenght = retail_df.shape[0]
column_proportion = round((total_missing_column[total_missing_column > 0] / lenght) * 100, 2)

total_proportion = round((total_missing / lenght) * 100, 2)

print(f"\nProporción total de faltantes: {total_proportion}")
print("Proporción de faltantes por columna:\n", column_proportion)
Resultado:
Total de valores faltantes: 136534
Total de valores faltantes por cada columna:
 InvoiceNo           0
StockCode           0
Description      1454
Quantity            0
InvoiceDate         0
UnitPrice           0
CustomerID     135080
Country             0
dtype: int64

Proporción total de faltantes: 25.2
Proporción de faltantes por columna:
 Description     0.27
CustomerID     24.93
dtype: float64
En en análisis podemos observar que el 25.2% del DataFrame corresponde a datos faltantes, de los cuales solo el 0.27% corresponden a la columna Description y el resto al CustomerID.
Para el caso de la columna Description podemos eliminar los registros con datos faltantes dado que la proporción es mínima.
Sin embargo eliminar el 24.93% de datos faltantes en CustomerID conllevaría una perdida de información considerable, por lo tanto es mejor proceder a imputar dichos valores faltantes.
Eliminar datos faltantes
La función drona() elimina datos faltantes tanto de un DataFrame como de una Serie, la función por si sola (sin parámetros ) devuelve un DataFrame/Serie sin los registros que tengan algún valor faltante, sin embargo podemos enviar una serie de parámetros para modificar este resultado.
Parámetros:
- axis: 0 (default) para eliminar filas, 1 para eliminar columnas.
- how: "any" (default) elimina la fila/columna si encuentra algún valor faltante, "all" elimina la fila/columna si y solo si todos los elementos son faltantes.
- subset: Lista de columnas a evaluar si cuentan con nulos.
- inplace: False (default) no modifica el DataFrame/Serie pero retorna uno nuevo sin los faltantes, True modifica el DataFrame/Serie y no retorna nada.
Análisis de datos donde Description tiene valores faltantes.
data_description_na = retail_df[retail_df["Description"].isna()]
quantity_less_0 = data_description_na[data_description_na["Quantity"] < 0].shape[0]
print(f"Total de datos de 'Quantity' menor a 0: {quantity_less_0}")
print("Valores de 'UnitPrice': ", data_description_na["UnitPrice"].unique())
print("Valores de 'CustomerID': ", data_description_na["CustomerID"].unique())
Resultado:
Total de datos de 'Quantity' menor a 0: 862
Valores de 'UnitPrice':  [0.]
Valores de 'CustomerID':  [nan]
Las columnas CustomerID, UnitPrice y Quantity cuando Description es null (valor faltante) son a su vez faltantes y negativos, por lo tanto podemos concluir que eliminar los registros donde Description es null no incurrirá en análisis sesgados o con interpretaciones erróneas.
# Eliminamos las filas con valores faltantes solo en la columna "Description" y modificamos el DataFrame
retail_df.dropna(subset=["Description"], inplace=True)
retail_df.isna().sum()
Resultado:
InvoiceNo           0
StockCode           0
Description         0
Quantity            0
InvoiceDate         0
UnitPrice           0
CustomerID     133626
Country             0
dtype: int64
Imputar datos faltantes
Pandas incluye funciones para imputar datos faltantes a partir de un dato conocido.
Funciones:
- ffill(): Forward Fill o llenado hacia adelante, rellena los valores faltantes (NA/NaN) a partir del último dato valido hasta el siguiente dato valido.
- bfill(): Backward Fill o llenado hacia atrás, rellena los valores faltantes (NA/NaN) a partir del siguiente dato valido hasta rellenar los datos faltantes que están detrás.
Ambas funciones reciben el parámetro inplace para indicarle a pandas si modifica o no el DataFrame original.
Para la columna CustomerID aplicaré la función ffill.
retail_df["CustomerID"].ffill(inplace=True)
retail_df.isna().sum()
Resultado:
InvoiceNo      0
StockCode      0
Description    0
Quantity       0
InvoiceDate    0
UnitPrice      0
CustomerID     0
Country        0
dtype: int64
Espero este aporte les sea de utilidad.