








Ventas Trimestrales

Transformar columnas en un DataFrame de Pandas es la etapa donde dejas de limpiar datos y empiezas a pensar como científico de datos. Aquí aprendes a crear columnas derivadas, convertir fechas a datetime y agrupar ventas por año y semestre para encontrar insights reales del negocio.
Cómo crear una nueva columna a partir de otras en Pandas
Cuando ya tienes el set limpio, lo siguiente es preguntarte qué columnas adicionales puedes derivar de las existentes. En el ejemplo, el DataFrame tiene cantidad y precio unitario, así que multiplicarlas genera una columna nueva llamada monto total [01:00].
La sintaxis es directa: le indicas a tu variable data el nombre de una columna que aún no existe y le asignas la operación entre las dos columnas originales. Al imprimir head, ya aparece el monto total junto al resto de la información.
¿Cómo creo una columna calculada en Pandas? Asigna
data['nueva'] = data['col1'] * data['col2']. Pandas crea la columna automáticamente si el nombre no existe y la rellena fila por fila.
Por qué convertir fechas a datetime antes de analizar series de tiempo
La columna invoice date viene como objeto de texto, lo que limita el análisis. Para trabajarla como serie de tiempo, conviértela con pd.to_datetime() y reemplaza la columna original [02:30].
A simple vista los valores parecen iguales, pero internamente cambia el tipo. Si revisas los dtypes del DataFrame antes y después, pasa de object a datetime64, lo que te habilita extraer año, mes, día y hora de forma nativa.
Eso sí, ten cuidado al sobrescribir columnas: si la conversión falla en alguna fila, puedes perder datos sin darte cuenta. Verifica siempre el resultado con head o revisando nulos.
Cómo desglosar una fecha en año y mes
Una vez que la columna está en formato datetime, accedes a sus componentes con el atributo .dt. Crear las columnas año y mes te da control total para agrupar después [04:00].
data['año'] = data['invoice date'].dt.year.data['mes'] = data['invoice date'].dt.month..dt.day y .dt.hour.Con estas columnas listas, el DataFrame queda preparado para cualquier agrupación temporal que necesites.
Cómo analizar ventas por año con groupby
El método groupby es el corazón del análisis agregado en Pandas. Para calcular ventas anuales, agrupas por la columna año y aplicas suma sobre monto total [05:30].
En el dataset del ejemplo hay datos de 2010 y 2011, así que el resultado son dos filas con la ganancia total por año. La estructura es:
python ventas_por_año = data.groupby('año')['monto_total'].sum()
¿Qué hace groupby en Pandas? Agrupa filas que comparten un mismo valor en una columna y te permite aplicar operaciones como suma, promedio o conteo sobre cada grupo.
Cómo calcular ventas por semestre con una función lambda
Para segmentar por semestre, primero creas una columna que clasifique cada mes en 1 o 2. Aquí entra una función lambda aplicada sobre la columna mes [07:00].
La lógica es simple: si el mes es menor o igual a 6, pertenece al primer semestre; en caso contrario, al segundo.
python data['semestre'] = data['mes'].apply(lambda x: 1 if x <= 6 else 2)
Luego agrupas por año y semestre, sumando el monto total. El resultado muestra que 2010 solo tiene ventas en el segundo semestre, mientras que 2011 cubre ambos.
Errores comunes al ejecutar celdas en notebooks
Un problema típico es olvidar correr la celda donde creas la columna nueva antes de usarla en otra. Si el kernel no la registró, groupby falla porque la columna no existe todavía. La solución es ejecutar las celdas en orden y volver a correr la que dio error.
Qué insights puedes extraer al transformar columnas
Crear columnas derivadas no es un ejercicio decorativo: cada nueva variable abre una pregunta de negocio distinta. Con monto total mides ingresos, con año y mes detectas estacionalidad, con semestre comparas mitades de año.
El reto que te queda es replicar este flujo para calcular ventas trimestrales y mensuales usando la misma lógica de lambda y groupby. ¿Cómo lo resolverías tú? Cuéntamelo en los comentarios.
Transformar columnas en un DataFrame de Pandas es la etapa donde dejas de limpiar datos y empiezas a pensar como científico de datos. Aquí aprendes a crear columnas derivadas, convertir fechas a datetime y agrupar ventas por año y semestre para encontrar insights reales del negocio.
Cuando ya tienes el set limpio, lo siguiente es preguntarte qué columnas adicionales puedes derivar de las existentes. En el ejemplo, el DataFrame tiene cantidad y precio unitario, así que multiplicarlas genera una columna nueva llamada monto total [01:00].
La sintaxis es directa: le indicas a tu variable data el nombre de una columna que aún no existe y le asignas la operación entre las dos columnas originales. Al imprimir head, ya aparece el monto total junto al resto de la información.
¿Cómo creo una columna calculada en Pandas? Asigna
data['nueva'] = data['col1'] * data['col2']. Pandas crea la columna automáticamente si el nombre no existe y la rellena fila por fila.
La columna invoice date viene como objeto de texto, lo que limita el análisis. Para trabajarla como serie de tiempo, conviértela con pd.to_datetime() y reemplaza la columna original [02:30].
A simple vista los valores parecen iguales, pero internamente cambia el tipo. Si revisas los dtypes del DataFrame antes y después, pasa de object a datetime64, lo que te habilita extraer año, mes, día y hora de forma nativa.
Eso sí, ten cuidado al sobrescribir columnas: si la conversión falla en alguna fila, puedes perder datos sin darte cuenta. Verifica siempre el resultado con head o revisando nulos.
Una vez que la columna está en formato datetime, accedes a sus componentes con el atributo .dt. Crear las columnas año y mes te da control total para agrupar después [04:00].
data['año'] = data['invoice date'].dt.year.data['mes'] = data['invoice date'].dt.month..dt.day y .dt.hour.Con estas columnas listas, el DataFrame queda preparado para cualquier agrupación temporal que necesites.
El método groupby es el corazón del análisis agregado en Pandas. Para calcular ventas anuales, agrupas por la columna año y aplicas suma sobre monto total [05:30].
En el dataset del ejemplo hay datos de 2010 y 2011, así que el resultado son dos filas con la ganancia total por año. La estructura es:
python ventas_por_año = data.groupby('año')['monto_total'].sum()
¿Qué hace groupby en Pandas? Agrupa filas que comparten un mismo valor en una columna y te permite aplicar operaciones como suma, promedio o conteo sobre cada grupo.
Para segmentar por semestre, primero creas una columna que clasifique cada mes en 1 o 2. Aquí entra una función lambda aplicada sobre la columna mes [07:00].
La lógica es simple: si el mes es menor o igual a 6, pertenece al primer semestre; en caso contrario, al segundo.
python data['semestre'] = data['mes'].apply(lambda x: 1 if x <= 6 else 2)
Luego agrupas por año y semestre, sumando el monto total. El resultado muestra que 2010 solo tiene ventas en el segundo semestre, mientras que 2011 cubre ambos.
Un problema típico es olvidar correr la celda donde creas la columna nueva antes de usarla en otra. Si el kernel no la registró, groupby falla porque la columna no existe todavía. La solución es ejecutar las celdas en orden y volver a correr la que dio error.
Crear columnas derivadas no es un ejercicio decorativo: cada nueva variable abre una pregunta de negocio distinta. Con monto total mides ingresos, con año y mes detectas estacionalidad, con semestre comparas mitades de año.
El reto que te queda es replicar este flujo para calcular ventas trimestrales y mensuales usando la misma lógica de lambda y groupby. ¿Cómo lo resolverías tú? Cuéntamelo en los comentarios.
Ventas Trimestrales
def month_to_quarter(month):
    if month in [1, 2, 3]:
        return 'Q1'
    elif month in [4, 5, 6]:
        return 'Q2'
    elif month in [7, 8, 9]:
        return 'Q3'
    else:
        return 'Q4'
df_cleaned['Quarter']=df_cleaned['Month'].apply(month_to_quarter)
sales_by_quarter=df_cleaned.groupby(['Year','Quarter'])['Total_amount'].sum()
print(sales_by_quarter)

def convert_to_month_name(month):
    month_names=['January','February','March','April','May','June','July','August','September','October','November','December']
    return month_names[month-1]

df_cleaned['Month_name']=df_cleaned['Month'].apply(convert_to_month_name)

sales_by_month=df_cleaned.groupby(['Month_name','Country'])['Total_amount'].sum()
print(sales_by_month)
#Ventas trimestrales

#definmos la función de trimestre
def trimestre(month):
  if month<=3 :
    return 1

  elif month<=6 :
    return 2

  elif month<=9 :
    return 3

  else:
    return 4

#Creamos la columna de trimestro y aplicamos la función
data_clened['Trimestrales'] = data_clened['Month'].apply(trimestre)
data_clened.head()

#Datos de ventas totales por trimestre
sales_by_trimestrales = data_clened.groupby(['Year', 'Semestre','Trimestrales'])['Total Amount'].sum()
sales_by_trimestrales


#Ventas totales por meses

#definmos la función de meses
def mensual(key):
  meses = {
    1: 'Enero',
    2: 'Febrero',
    3: 'Marzo',
    4: 'Abril',
    5: 'Mayo',
    6: 'Junio',
    7: 'Julio',
    8: 'Agosto',
    9: 'Septiembre',
    10: 'Octubre',
    11: 'Noviembre',
    12: 'Diciembre'
}
  if key in meses:
    return meses[key]

#Crear una columna con los meses
data_clened['Mensual'] = data_clened['Month'].apply(mensual)
data_clened.head()

#Datos de ventas totales por meses en texto
sales_by_mensual = data_clened.groupby(['Year', 'Semestre','Trimestrales','Mensual'])['Total Amount'].sum()
sales_by_mensual
```#Ventas trimestrales #definmos la función de trimestre def trimestre(month): if month<=3 : return 1 elif month<=6 : return 2 elif month<=9 : return 3 else: return 4 #Creamos la columna de trimestro y aplicamos la función data\_clened\['Trimestrales'] = data\_clened\['Month'].apply(trimestre) data\_clened.head() #Datos de ventas totales por trimestre sales\_by\_trimestrales = data\_clened.groupby(\['Year', 'Semestre','Trimestrales'])\['Total Amount'].sum() sales\_by\_trimestrales #Ventas totales por meses #definmos la función de meses def mensual(key): meses = { 1: 'Enero', 2: 'Febrero', 3: 'Marzo', 4: 'Abril', 5: 'Mayo', 6: 'Junio', 7: 'Julio', 8: 'Agosto', 9: 'Septiembre', 10: 'Octubre', 11: 'Noviembre', 12: 'Diciembre' } if key in meses: return meses\[key] #Crear una columna con los meses data\_clened\['Mensual'] = data\_clened\['Month'].apply(mensual) data\_clened.head() #Datos de ventas totales por meses en texto sales\_by\_mensual = data\_clened.groupby(\['Year', 'Semestre','Trimestrales','Mensual'])\['Total Amount'].sum() sales\_by\_mensual

Cristian Mateo Velez Duran
NESTOR IVAN RONCANCIO CABALLERO

Luis Enrique Montes Gonzalez
Luis Enrique Montes Gonzalez
Antonio Demarco Bonino
Víctor Alexis Matos Ramírez
Mario Alexander Vargas Celis

José Arturo Melgar Martínez
Jhon Alexander Mosquera Vanegas
Danny Alejandro fernandez gallego
Daniel stevens Celorio sanabria

Leidy Katherin
Sebastian Melo Ruiz
Alejandro Vega Villegas
Jhonatan Smith Perez Guerrero
Elias Echeverri

Juan Silva

Saul Antonio Cerén Gálvez

Christopher Flores
Christopher Flores
Alvaro Jose Florez Rangel
Crear y transformar columnas es una práctica esencial en el preprocesamiento de datos. Estas transformaciones permiten que los datos sean más interpretables y compatibles con los métodos analíticos y modelos que se utilizarán. Sin estas transformaciones, es probable que la calidad del análisis se vea comprometida, y que los modelos no alcancen su máximo rendimiento debido a datos mal preparados o subutilizados. Además, la capacidad de crear nuevas características puede ser un factor clave en la obtención de insights más profundos y en la mejora de la capacidad predictiva de los modelos.


La **creación de columnas** es una operación común en el análisis de datos con bibliotecas como **Pandas**. Puedes crear nuevas columnas basadas en cálculos, transformaciones, combinaciones de otras columnas, o asignar valores predeterminados. Aquí te muestro algunas formas comunes de crear columnas en un DataFrame de **Pandas**.
### 1. **Crear una columna asignando un valor fijo**
Puedes crear una nueva columna y asignar un valor constante a todas las filas.
import pandas as pd


\# Crear un DataFrame de ejemplo

data = {'Nombre': \['Ana', 'Luis', 'Carlos', 'Julia'],

        'Edad': \[23, 34, 45, 28]}


df = pd.DataFrame(data)


\# Crear una nueva columna asignando un valor constante

df\['Ciudad'] = 'Desconocido'


print(df)
### 2. **Crear una columna basada en otra columna**
Puedes crear una columna nueva aplicando una operación matemática o lógica sobre otra columna existente.
#### Ejemplo: Calcular una nueva columna a partir de una columna existente
\# Crear una nueva columna calculando el doble de la edad

df\['Edad\_doble'] = df\['Edad'] \* 2


print(df)
### 3. **Crear una columna basada en condiciones**
Es posible crear columnas que se generen con base en condiciones lógicas aplicadas a otras columnas.
#### Ejemplo: Crear una columna que indique si la persona es mayor de 30 años
\# Crear una nueva columna con valores basados en una condición

df\['Mayor\_de\_30'] = df\['Edad'] > 30


print(df)
### 4. **Crear una columna utilizando funciones personalizadas**
Si necesitas aplicar una lógica más compleja, puedes usar el método apply() para aplicar una función a las filas o columnas.
#### Ejemplo: Crear una columna con una función personalizada
\# Definir una función que devuelva una clasificación basada en la edad
def clasificar\_edad(edad):
  if edad < 30:
  return 'Joven'
  elif 30 <= edad < 40:
  return 'Adulto Joven'
  else:
  return 'Mayor'
\# Aplicar la función a la columna 'Edad'
df\['Clasificación\_Edad'] = df\['Edad'].apply(clasificar\_edad)
print(df)
### 5. **Crear columnas combinando varias columnas**
Puedes crear una columna combinando los valores de dos o más columnas.
#### Ejemplo: Crear una columna combinada de nombre y edad
\# Crear una nueva columna combinando 'Nombre' y 'Edad'

df\['Descripción'] = df\['Nombre'] + ' tiene ' + df\['Edad'].astype(str) + ' años.'


print(df)
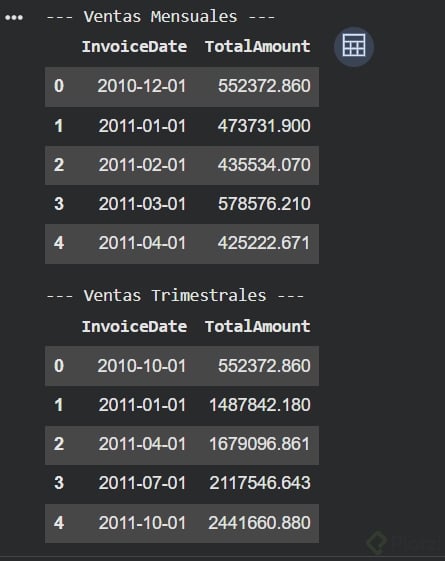
import matplotlib.pyplot as plt

# Agrupar por mes (Año y Mes) y sumar el total de ventas
sales_monthly = data_cleaned.groupby(data_cleaned['InvoiceDate'].dt.to_period('M'))['TotalAmount'].sum().reset_index()
sales_monthly['InvoiceDate'] = sales_monthly['InvoiceDate'].dt.to_timestamp()

# Agrupar por trimestre (Año y Trimestre) y sumar el total de ventas
sales_quarterly = data_cleaned.groupby(data_cleaned['InvoiceDate'].dt.to_period('Q'))['TotalAmount'].sum().reset_index()
sales_quarterly['InvoiceDate'] = sales_quarterly['InvoiceDate'].dt.to_timestamp()

# Mostrar los primeros registros de ambos agrupamientos
print("--- Ventas Mensuales ---")
display(sales_monthly.head())
print("\n--- Ventas Trimestrales ---")
display(sales_quarterly.head())
Agrupar por año y por semestre, como se hace en esta clase, destapa algo que el total anual esconde: en 2010 solo hay datos del segundo semestre, mientras que 2011 tiene los dos. Si alguien comparara las ventas de ambos años sin mirar esa cobertura, concluiría que el negocio creció muchísimo cuando en realidad se estaría comparando un semestre contra dos. Por eso, antes de sacar conclusiones sobre variaciones anuales, conviene desglosar el periodo y confirmar que los dos años están completos. Es un error típico en informes de crecimiento y se evita con una agrupación adicional.
esto es una operacion vectorizada:
por trimestre:
sales_by_quarter = data_cleaned_frame.groupby(['Year', 'Quarter'])['TotalAmount'].sum()
print(sales_by_quarter)
por mes:
sales_by_month = data_cleaned_frame.groupby(['Year','Month'])['TotalAmount'].sum()
print(sales_by_month)
ventas trimestrales y mensuales
# Crear nueva columna con los trimestres
def trimestral(x):
    if x <=3:
        return 1
    elif x <=6:
        return 2
    elif x <=9:
        return 3
    else:
        return 4


data_limpio['Trimestre'] = data_limpio['Month'].apply(trimestral)
sales_by_trimestral = data_limpio.groupby(['Year', 'Trimestre'])['Total Price'].sum()
#print(sales_by_trimestral)

# Ventas mensuales
sales_by_mensual = data_limpio.groupby(['Year', 'Month'])['Total Price'].sum()
print(sales_by_mensual)
Ventas Trimestrales
def month_to_quarter(month): if month in [1, 2, 3]: return 'Q1' elif month in [4, 5, 6]: return 'Q2' elif month in [7, 8, 9]: return 'Q3' else: return 'Q4' df_cleaned['Quarter']=df_cleaned['Month'].apply(month_to_quarter) sales_by_quarter=df_cleaned.groupby(['Year','Quarter'])['Total_amount'].sum() print(sales_by_quarter) def convert_to_month_name(month): month_names=['January','February','March','April','May','June','July','August','September','October','November','December'] return month_names[month-1] df_cleaned['Month_name']=df_cleaned['Month'].apply(convert_to_month_name) sales_by_month=df_cleaned.groupby(['Month_name','Country'])['Total_amount'].sum() print(sales_by_month)
#Ventas trimestrales #definmos la función de trimestre def trimestre(month): if month<=3 : return 1 elif month<=6 : return 2 elif month<=9 : return 3 else: return 4 #Creamos la columna de trimestro y aplicamos la función data_clened['Trimestrales'] = data_clened['Month'].apply(trimestre) data_clened.head() #Datos de ventas totales por trimestre sales_by_trimestrales = data_clened.groupby(['Year', 'Semestre','Trimestrales'])['Total Amount'].sum() sales_by_trimestrales #Ventas totales por meses #definmos la función de meses def mensual(key): meses = { 1: 'Enero', 2: 'Febrero', 3: 'Marzo', 4: 'Abril', 5: 'Mayo', 6: 'Junio', 7: 'Julio', 8: 'Agosto', 9: 'Septiembre', 10: 'Octubre', 11: 'Noviembre', 12: 'Diciembre' } if key in meses: return meses[key] #Crear una columna con los meses data_clened['Mensual'] = data_clened['Month'].apply(mensual) data_clened.head() #Datos de ventas totales por meses en texto sales_by_mensual = data_clened.groupby(['Year', 'Semestre','Trimestrales','Mensual'])['Total Amount'].sum() sales_by_mensual ```#Ventas trimestrales #definmos la función de trimestre def trimestre(month): if month<=3 : return 1 elif month<=6 : return 2 elif month<=9 : return 3 else: return 4 #Creamos la columna de trimestro y aplicamos la función data\_clened\['Trimestrales'] = data\_clened\['Month'].apply(trimestre) data\_clened.head() #Datos de ventas totales por trimestre sales\_by\_trimestrales = data\_clened.groupby(\['Year', 'Semestre','Trimestrales'])\['Total Amount'].sum() sales\_by\_trimestrales #Ventas totales por meses #definmos la función de meses def mensual(key): meses = { 1: 'Enero', 2: 'Febrero', 3: 'Marzo', 4: 'Abril', 5: 'Mayo', 6: 'Junio', 7: 'Julio', 8: 'Agosto', 9: 'Septiembre', 10: 'Octubre', 11: 'Noviembre', 12: 'Diciembre' } if key in meses: return meses\[key] #Crear una columna con los meses data\_clened\['Mensual'] = data\_clened\['Month'].apply(mensual) data\_clened.head() #Datos de ventas totales por meses en texto sales\_by\_mensual = data\_clened.groupby(\['Year', 'Semestre','Trimestrales','Mensual'])\['Total Amount'].sum() sales\_by\_mensual


Crear y transformar columnas es una práctica esencial en el preprocesamiento de datos. Estas transformaciones permiten que los datos sean más interpretables y compatibles con los métodos analíticos y modelos que se utilizarán. Sin estas transformaciones, es probable que la calidad del análisis se vea comprometida, y que los modelos no alcancen su máximo rendimiento debido a datos mal preparados o subutilizados. Además, la capacidad de crear nuevas características puede ser un factor clave en la obtención de insights más profundos y en la mejora de la capacidad predictiva de los modelos.
La **creación de columnas** es una operación común en el análisis de datos con bibliotecas como **Pandas**. Puedes crear nuevas columnas basadas en cálculos, transformaciones, combinaciones de otras columnas, o asignar valores predeterminados. Aquí te muestro algunas formas comunes de crear columnas en un DataFrame de **Pandas**.
### 1. **Crear una columna asignando un valor fijo**
Puedes crear una nueva columna y asignar un valor constante a todas las filas.
import pandas as pd \# Crear un DataFrame de ejemplo data = {'Nombre': \['Ana', 'Luis', 'Carlos', 'Julia'],   'Edad': \[23, 34, 45, 28]} df = pd.DataFrame(data) \# Crear una nueva columna asignando un valor constante df\['Ciudad'] = 'Desconocido' print(df)
### 2. **Crear una columna basada en otra columna**
Puedes crear una columna nueva aplicando una operación matemática o lógica sobre otra columna existente.
#### Ejemplo: Calcular una nueva columna a partir de una columna existente
\# Crear una nueva columna calculando el doble de la edad df\['Edad\_doble'] = df\['Edad'] \* 2 print(df)
### 3. **Crear una columna basada en condiciones**
Es posible crear columnas que se generen con base en condiciones lógicas aplicadas a otras columnas.
#### Ejemplo: Crear una columna que indique si la persona es mayor de 30 años
\# Crear una nueva columna con valores basados en una condición df\['Mayor\_de\_30'] = df\['Edad'] > 30 print(df)
### 4. **Crear una columna utilizando funciones personalizadas**
Si necesitas aplicar una lógica más compleja, puedes usar el método apply() para aplicar una función a las filas o columnas.
#### Ejemplo: Crear una columna con una función personalizada
\# Definir una función que devuelva una clasificación basada en la edad def clasificar\_edad(edad):   if edad < 30:   return 'Joven'   elif 30 <= edad < 40:   return 'Adulto Joven'   else:   return 'Mayor' \# Aplicar la función a la columna 'Edad' df\['Clasificación\_Edad'] = df\['Edad'].apply(clasificar\_edad) print(df)
### 5. **Crear columnas combinando varias columnas**
Puedes crear una columna combinando los valores de dos o más columnas.
#### Ejemplo: Crear una columna combinada de nombre y edad
\# Crear una nueva columna combinando 'Nombre' y 'Edad' df\['Descripción'] = df\['Nombre'] + ' tiene ' + df\['Edad'].astype(str) + ' años.' print(df)
### 6. **Crear una columna con datos categóricos a partir de una variable numérica**
En algunos casos, puedes transformar una variable numérica en categorías.
#### Ejemplo: Crear categorías de edad
\# Crear categorías de edad utilizando pd.cut()

df\['Grupo\_Edad'] = pd.cut(df\['Edad'], bins=\[0, 18, 35, 50, 100], labels=\['Niño', 'Joven', 'Adulto', 'Mayor'])


print(df)
### 7. **Crear una columna utilizando el método assign()**
El método assign() de Pandas te permite crear nuevas columnas de una manera funcional y encadenada, lo que puede ser útil cuando realizas múltiples operaciones secuenciales.
#### Ejemplo:
\# Crear nuevas columnas utilizando assign()

df = df.assign(Edad\_más\_5 = df\['Edad'] + 5,

               Es\_adulto = df\['Edad'] >= 18)


print(df)
### 8. **Crear columnas a partir de expresiones regulares (Regex)**
Si necesitas extraer información de cadenas de texto, puedes utilizar expresiones regulares para crear nuevas columnas.
#### Ejemplo: Extraer la primera letra del nombre
\# Crear una nueva columna extrayendo la primera letra de 'Nombre'

df\['Inicial'] = df\['Nombre'].str\[0]


print(df)
### 9. **Crear columnas a partir de múltiples condiciones con np.select()**
Cuando tienes múltiples condiciones para generar una nueva columna, puedes utilizar np.select() de NumPy para mayor flexibilidad.
#### Ejemplo:
import numpy as np \# Definir condiciones condiciones = \[   (df\['Edad'] < 18),   (df\['Edad'] >= 18) & (df\['Edad'] < 35),   (df\['Edad'] >= 35) ] \# Definir los resultados correspondientes resultados = \['Niño', 'Joven', 'Adulto'] \# Crear una nueva columna basada en las condiciones df\['Categoría\_Edad'] = np.select(condiciones, resultados) print(df)
### Conclusión
Crear columnas en Pandas es un proceso flexible que te permite manipular y transformar tus datos según las necesidades del análisis. Puedes crear columnas a partir de cálculos simples, funciones personalizadas, condiciones lógicas, combinaciones de otras columnas, y más.
import matplotlib.pyplot as plt # Agrupar por mes (Año y Mes) y sumar el total de ventas sales_monthly = data_cleaned.groupby(data_cleaned['InvoiceDate'].dt.to_period('M'))['TotalAmount'].sum().reset_index() sales_monthly['InvoiceDate'] = sales_monthly['InvoiceDate'].dt.to_timestamp() # Agrupar por trimestre (Año y Trimestre) y sumar el total de ventas sales_quarterly = data_cleaned.groupby(data_cleaned['InvoiceDate'].dt.to_period('Q'))['TotalAmount'].sum().reset_index() sales_quarterly['InvoiceDate'] = sales_quarterly['InvoiceDate'].dt.to_timestamp() # Mostrar los primeros registros de ambos agrupamientos print("--- Ventas Mensuales ---") display(sales_monthly.head()) print("\n--- Ventas Trimestrales ---") display(sales_quarterly.head())
Agrupar por año y por semestre, como se hace en esta clase, destapa algo que el total anual esconde: en 2010 solo hay datos del segundo semestre, mientras que 2011 tiene los dos. Si alguien comparara las ventas de ambos años sin mirar esa cobertura, concluiría que el negocio creció muchísimo cuando en realidad se estaría comparando un semestre contra dos. Por eso, antes de sacar conclusiones sobre variaciones anuales, conviene desglosar el periodo y confirmar que los dos años están completos. Es un error típico en informes de crecimiento y se evita con una agrupación adicional.
esto es una operacion vectorizada:
por trimestre:
sales_by_quarter = data_cleaned_frame.groupby(['Year', 'Quarter'])['TotalAmount'].sum() print(sales_by_quarter)
por mes:
sales_by_month = data_cleaned_frame.groupby(['Year','Month'])['TotalAmount'].sum() print(sales_by_month)
ventas trimestrales y mensuales
# Crear nueva columna con los trimestres def trimestral(x): if x <=3: return 1 elif x <=6: return 2 elif x <=9: return 3 else: return 4 data_limpio['Trimestre'] = data_limpio['Month'].apply(trimestral) sales_by_trimestral = data_limpio.groupby(['Year', 'Trimestre'])['Total Price'].sum() #print(sales_by_trimestral) # Ventas mensuales sales_by_mensual = data_limpio.groupby(['Year', 'Month'])['Total Price'].sum() print(sales_by_mensual)
data_cleaned['Quarter'] = data_cleaned['InvoiceDate'].dt.quarter
sales_by_quarter = data_cleaned.groupby(['Year', 'Quarter'])['TotalAmount'].sum() sales_by_quarter
df_cleaned['Trimester'] = df_cleaned['Month'].apply(lambda x: 1 if x <= 3 else (2 if x <= 6 else (3 if x <= 9 else 4))) sales_by_trimester = df_cleaned.groupby(['Year', 'Trimester'])['TotalAmount'].sum() sales_by_trimester
# Crear un nuevo Data Frame con la información de las ventas por mes sales_by_month = df_cleaned.groupby(["Year","Month"])["Total"].sum() sales_by_month
import pandas as pd import numpy as np # pyrefly: ignore [missing-import] import matplotlib.gridspec as gridspec # pyrefly: ignore [missing-import] import matplotlib.pyplot as plt path = r"C:\Users\perez\OneDrive\Documents\Antigravity\Python\Pandas\online_retail.csv" df = pd.read_csv(path) #Cuantos valores nulos existen por columna print(df.isnull().sum()) #Cuantas filas duplicadas existen print(df.duplicated().sum()) #Crea un diccionario con los valores unicos de cada columna unique_values = {col: df[col].unique() for col in df.columns} #Recorre el diccionario anterior solo para imprimir sus valores for col, values in unique_values.items(): print(f'Columna {col}') print(f'Numero de valores unicos: {len(values)}') print(f'Valores unicos: {values}') print('-' * 50) #Limpieza de datos #Elimina filas duplicadas df_cleaned = df.drop_duplicates() #Elimina datos donde Customer ID es vacio df_cleaned = df.dropna(subset=['CustomerID']) #Crea una nueva columna para calcular el total de cada factura df_cleaned['Total'] = df_cleaned['Quantity'] * df_cleaned['UnitPrice'] #Reemplaza el tipo de dato de InvoiceDate df_cleaned['InvoiceDate'] = pd.to_datetime(df_cleaned['InvoiceDate']) #Creamos 2 nuevas columnas desglozando las fechas para facilitar el analisis df_cleaned['Year'] = df_cleaned['InvoiceDate'].dt.year df_cleaned['Month'] = df_cleaned['InvoiceDate'].dt.month #Agrupamos por año y mes y sumamos el total sales_by_year = df_cleaned.groupby('Year')['Total'].sum() sales_by_month = df_cleaned.groupby('Month')['Total'].sum() print('Ventas por año:\n',sales_by_year) print('Ventas por mes:\n',sales_by_month) #Agrupamos por año y semestre y sumamos el total df_cleaned['Semester'] = df_cleaned['Month'].apply(lambda x:1 if x <= 6 else 2) sales_by_semester = df_cleaned.groupby(['Year','Semester'])['Total'].sum() df_cleaned['Trimestre'] = df_cleaned['Month'].apply(lambda x: 1 if x <= 3 else 2 if x <= 6 else 3 if x <= 9 else 4) sales_by_trimester = df_cleaned.groupby(['Year','Trimestre'])['Total'].sum() print('Ventas por semestre:\n',sales_by_semester) print('Ventas por trimestre:\n',sales_by_trimester) print('Ventas por mes:\n',sales_by_month)
#Ventas trimestrales
data_cleaned['Quarter'] = data_cleaned['InvoiceDate'].dt.quarter
sales_by_quarter = data_cleaned.groupby(['Year', 'Quarter'])['TotalAmount'].sum()
sales_by_quarter
#Ventas mensuales
data_cleaned['MonthName'] = data_cleaned['InvoiceDate'].dt.month_name()
sales_by_month = data_cleaned.groupby(['Year', 'MonthName'], sort=False)['TotalAmount'].sum()
sales_by_month
MOdelo coworcountry o modelo coworculture con muchas actividades para pausas activas y acompañamiento de tu rol profesional Recuerda que Estamos enfocados en atender y brindar espacios para nomadas digitales, teletrabajo y coworking space en Agrolenials Paradise Ecohostel Country Inns contacto directo whatsapp +573206299333 y Faccebook
La forma más rápida y optimizada que encontré:
# Ventas trimestrales
df_cleaned['Quarter'] = df_cleaned['InvoiceDate'].dt.quarter
sales_by_quarter = df_cleaned.groupby(['Year', 'Quarter'])['TotalAmount'].sum()
sales_by_quarter
# Aseguramos limpieza
df = df.dropna(subset=['CustomerID'])
df['InvoiceDate'] = pd.to_datetime(df['InvoiceDate'])
df['TotalRevenue'] = df['Quantity'] * df['UnitPrice']
# Agrupamos por trimestre (Quarter)
# 'QE' es el estándar para fin de trimestre en pandas 2.0+
ventas_trimestrales = df.set_index('InvoiceDate')['TotalRevenue'].resample('QE').sum()
# Calculamos el crecimiento porcentual respecto al trimestre anterior
crecimiento = ventas_trimestrales.pct_change() * 100
print("--- REPORTE ESTRATÉGICO ---")
reporte = pd.DataFrame({
'Ventas Totales': ventas_trimestrales,
'% Crecimiento': crecimiento
})
print(reporte)
--- REPORTE ESTRATÉGICO ---
Ventas Totales % Crecimiento
InvoiceDate
2010-12-31 554604.020 NaN
2011-03-31 1491585.140 168.945966
2011-06-30 1682312.091 12.786863
2011-09-30 2122046.853 26.138715
2011-12-31 2449517.710 15.431839
# Agrupamos por producto
productos = df.groupby('Description')['TotalRevenue'].sum().sort_values(ascending=False).reset_index()
# Calculamos el porcentaje acumulado
productos['PorcentajeAcumulado'] = 100 * productos['TotalRevenue'].cumsum() / productos['TotalRevenue'].sum()
# Clasificamos
def clasificar_abc(porcentaje):
if porcentaje <= 80: return 'A (Estratégico)'
elif porcentaje <= 95: return 'B (Intermedio)'
else: return 'C (Baja Rotación)'
productos['Categoria_ABC'] = productos['PorcentajeAcumulado'].apply(clasificar_abc)
print("--- TOP 5 PRODUCTOS CLASE A ---")
print(productos.head(5))
--- TOP 5 PRODUCTOS CLASE A ---
Description TotalRevenue PorcentajeAcumulado \
0 REGENCY CAKESTAND 3 TIER 132870.40 1.600835
1 WHITE HANGING HEART T-LIGHT HOLDER 93823.85 2.731234
2 JUMBO BAG RED RETROSPOT 83236.76 3.734079
3 PARTY BUNTING 67687.53 4.549585
4 POSTAGE 66710.24 5.353316
Categoria_ABC
0 A (Estratégico)
1 A (Estratégico)
2 A (Estratégico)
3 A (Estratégico)
4 A (Estratégico)
clientes = df.groupby('CustomerID')['TotalRevenue'].agg(['sum', 'count']).sort_values(by='sum', ascending=False)
clientes.columns = ['Total_Gastado', 'Numero_Pedidos']
print("\n--- TOP 5 CLIENTES (PARA FIDELIZACIÓN) ---")
print(clientes.head(5))
--- TOP 5 CLIENTES (PARA FIDELIZACIÓN) ---
Total_Gastado Numero_Pedidos
CustomerID
14646.0 279489.02 2085
18102.0 256438.49 433
17450.0 187482.17 351
14911.0 132572.62 5903
12415.0 123725.45 778
ventas mensuales:

Ventas por trimestre:

# Ejercicios de Manipulacion total ventas por trimestre y mes # Total ventas por trimestre def quarter(month): if month in [1, 2, 3]: return 1 elif month in [4, 5, 6]: return 2 elif month in [7, 8, 9]: return 3 else: return 4 df_cleaned['Quarter'] = df_cleaned['Month'].apply(quarter) sales_by_quarter = df_cleaned.groupby(['Year', 'Quarter'])['TotalAmount'].sum() print("Total ventas por trimestre:\n", sales_by_quarter) # Total ventas por mes def mensual(month): meses = {1: 'Enero', 2: 'Febrero', 3: 'Marzo', 4: 'Abril', 5: 'Mayo', 6: 'Junio', 7: 'Julio', 8: 'Agosto', 9: 'Septiembre', 10: 'Octubre', 11: 'Noviembre', 12: 'Diciembre'} if month in meses: return meses[month] else: return 'No es un mes valido' df_cleaned['Monthly'] = df_cleaned['Month'].apply(mensual) sales_by_month = df_cleaned.groupby(['Year', 'Monthly'])['TotalAmount'].sum() print("Total ventas por mes:\n", sales_by_month) # Total ventas consolidado desglosado por año, semestre, trimestre y mes sales_by_consolidated = df_cleaned.groupby(['Year', 'Semester', 'Quarter', 'Monthly'])['TotalAmount'].sum() print("Total ventas consolidado desglosado por año, semestre, trimestre y mes:\n", sales_by_consolidated)
### 6. **Crear una columna con datos categóricos a partir de una variable numérica**
En algunos casos, puedes transformar una variable numérica en categorías.
#### Ejemplo: Crear categorías de edad
\# Crear categorías de edad utilizando pd.cut()
df\['Grupo\_Edad'] = pd.cut(df\['Edad'], bins=\[0, 18, 35, 50, 100], labels=\['Niño', 'Joven', 'Adulto', 'Mayor'])
print(df)
### 7. **Crear una columna utilizando el método assign()**
El método assign() de Pandas te permite crear nuevas columnas de una manera funcional y encadenada, lo que puede ser útil cuando realizas múltiples operaciones secuenciales.
#### Ejemplo:
\# Crear nuevas columnas utilizando assign()
df = df.assign(Edad\_más\_5 = df\['Edad'] + 5, 
  Es\_adulto = df\['Edad'] >= 18)
print(df)
### 8. **Crear columnas a partir de expresiones regulares (Regex)**
Si necesitas extraer información de cadenas de texto, puedes utilizar expresiones regulares para crear nuevas columnas.
#### Ejemplo: Extraer la primera letra del nombre
\# Crear una nueva columna extrayendo la primera letra de 'Nombre'
df\['Inicial'] = df\['Nombre'].str\[0]
print(df)
### 9. **Crear columnas a partir de múltiples condiciones con np.select()**
Cuando tienes múltiples condiciones para generar una nueva columna, puedes utilizar np.select() de NumPy para mayor flexibilidad.
#### Ejemplo:
import numpy as np
\# Definir condiciones
condiciones = \[
  (df\['Edad'] < 18),
  (df\['Edad'] >= 18) & (df\['Edad'] < 35),
  (df\['Edad'] >= 35)
]
\# Definir los resultados correspondientes
resultados = \['Niño', 'Joven', 'Adulto']
\# Crear una nueva columna basada en las condiciones
df\['Categoría\_Edad'] = np.select(condiciones, resultados)
print(df)
### Conclusión
Crear columnas en Pandas es un proceso flexible que te permite manipular y transformar tus datos según las necesidades del análisis. Puedes crear columnas a partir de cálculos simples, funciones personalizadas, condiciones lógicas, combinaciones de otras columnas, y más.