
La estructura de los comprenhensions me recuerda a la de sql en un motor de busqueda.
SELECT (el dato que necesitamos)
FROM (tabla que vamos a recorrer)
WHERE (condicion)
Si trabajas con listas de datos en Python y quieres código más corto y legible, las comprensiones son tu mejor herramienta. Aquí aprenderás a transformar bucles tradicionales en set comprehensions y dictionary comprehensions anidadas, partiendo de un caso real: extraer y categorizar noticias por su fuente.
Este contenido es ideal si ya dominas los for tradicionales y quieres dar el salto hacia un código más pythónico sin perder claridad.
Cómo extraer fuentes únicas con un set en Python
El reto arranca con una lista de artículos. Cada artículo tiene un title y una source, y esa fuente es un diccionario con un name. El objetivo es obtener todas las fuentes sin repetir ninguna.
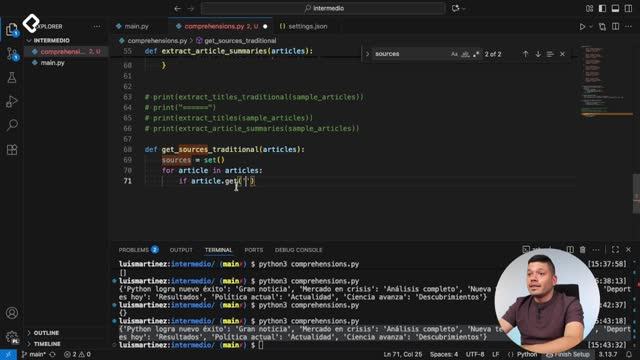
La solución tradicional usa una función get_sources que crea un set vacío. ¿Por qué un set y no una lista? Porque el set no admite duplicados: si el dato ya existe, simplemente no lo agrega [00:36].
Dentro de la función iteramos con for article in articles y validamos dos cosas antes de agregar:
get.name.Esa validación doble se hace con un ampersand (operador and): si existe la fuente, obtenemos el nombre y lo agregamos con el método add [01:15]. Al terminar la iteración, retornamos el set.
¿Para qué sirve un set en Python? Es una estructura que guarda valores sin duplicados. Si agregas "tech news" dos veces, solo queda una copia. Perfecto para listar fuentes o categorías únicas.
Cómo refactorizar un for a set comprehension
Aquí viene lo interesante: ese mismo código de varias líneas cabe en una sola con una comprensión. La sintaxis reordena las tres piezas que ya conoces.
Envolviendo todo entre llaves {} creas un set directamente [02:24]. Copias el for y el if (sin los dos puntos) y colocas al inicio lo que quieres guardar.
Al comparar ambas versiones con un print, el resultado es idéntico: aunque el set de pruebas tenga "tecnología" repetida, solo aparece una vez "tech news" [03:14].
Cómo categorizar noticias con diccionarios anidados
Muchos modelos de negocio necesitan iteraciones anidadas, y las comprensiones también las soportan. El siguiente paso es agrupar todas las noticias según su categoría, generando una lista de artículos por cada fuente.
La versión tradicional, categorizar_tradicional, reutiliza get_sources para obtener la lista de fuentes y luego hace dos iteraciones anidadas [04:15]. El resultado es un diccionario donde:
Antes de agregar cualquier artículo, hay que crear la llave. Con un condicional not in verificamos si la fuente ya existe en results; si no, la definimos como una lista vacía [05:07]. Esto evita que la lista se reinicie en cada vuelta y borre los artículos ya agregados.
¿Por qué validar con not in antes de agregar a un diccionario? Porque si no verificas, cada iteración sobrescribe la lista con una vacía y pierdes los datos previos. El
not insolo crea la llave la primera vez.
Después iteramos sobre los artículos y, con otro if, comparamos si la fuente externa es igual al nombre de la fuente del artículo. Si coinciden, lo sumamos con el método append [06:00].
Cómo convertir dos for anidados en una comprensión
Pasar esto a una comprensión de diccionario evita tener que crear la lista vacía manualmente, porque se genera sola en cada iteración.
La lógica se lee así: trae todas las fuentes, itera sobre ellas y usa cada fuente como llave del diccionario. Dentro del valor, que es una lista, itera los artículos y agrega cada uno solo si su fuente coincide con la que estás recorriendo [07:36].
Al probar ambas versiones con un separador entre los print, el output es exactamente igual [08:13]. La diferencia es que la comprensión anidada elimina el código extra de inicializar llaves.
Cuándo conviene usar comprensiones en tu código
Las comprensiones funcionan en listas, diccionarios y sets, pero no son una regla obligatoria. Úsalas cuando mejoren la legibilidad, no cuando compliquen la lectura.
Tres recomendaciones prácticas del cierre de la clase:
Un detalle curioso del ejemplo: el editor marcó un error de variable no definida porque el nombre del sample no coincidía, algo que herramientas como estas detectan automáticamente [06:40]. Corregirlo fue tan simple como usar la variable correcta.
¿Ya intentaste refactorizar alguno de tus bucles a comprensiones? Cuéntame en los comentarios qué tan legible te quedó el código.
Si trabajas con listas de datos en Python y quieres código más corto y legible, las comprensiones son tu mejor herramienta. Aquí aprenderás a transformar bucles tradicionales en set comprehensions y dictionary comprehensions anidadas, partiendo de un caso real: extraer y categorizar noticias por su fuente.
Este contenido es ideal si ya dominas los for tradicionales y quieres dar el salto hacia un código más pythónico sin perder claridad.
El reto arranca con una lista de artículos. Cada artículo tiene un title y una source, y esa fuente es un diccionario con un name. El objetivo es obtener todas las fuentes sin repetir ninguna.
La solución tradicional usa una función get_sources que crea un set vacío. ¿Por qué un set y no una lista? Porque el set no admite duplicados: si el dato ya existe, simplemente no lo agrega [00:36].
Dentro de la función iteramos con for article in articles y validamos dos cosas antes de agregar:
get.name.Esa validación doble se hace con un ampersand (operador and): si existe la fuente, obtenemos el nombre y lo agregamos con el método add [01:15]. Al terminar la iteración, retornamos el set.
¿Para qué sirve un set en Python? Es una estructura que guarda valores sin duplicados. Si agregas "tech news" dos veces, solo queda una copia. Perfecto para listar fuentes o categorías únicas.
Aquí viene lo interesante: ese mismo código de varias líneas cabe en una sola con una comprensión. La sintaxis reordena las tres piezas que ya conoces.
Envolviendo todo entre llaves {} creas un set directamente [02:24]. Copias el for y el if (sin los dos puntos) y colocas al inicio lo que quieres guardar.
Al comparar ambas versiones con un print, el resultado es idéntico: aunque el set de pruebas tenga "tecnología" repetida, solo aparece una vez "tech news" [03:14].
Muchos modelos de negocio necesitan iteraciones anidadas, y las comprensiones también las soportan. El siguiente paso es agrupar todas las noticias según su categoría, generando una lista de artículos por cada fuente.
La versión tradicional, categorizar_tradicional, reutiliza get_sources para obtener la lista de fuentes y luego hace dos iteraciones anidadas [04:15]. El resultado es un diccionario donde:
Antes de agregar cualquier artículo, hay que crear la llave. Con un condicional not in verificamos si la fuente ya existe en results; si no, la definimos como una lista vacía [05:07]. Esto evita que la lista se reinicie en cada vuelta y borre los artículos ya agregados.
¿Por qué validar con not in antes de agregar a un diccionario? Porque si no verificas, cada iteración sobrescribe la lista con una vacía y pierdes los datos previos. El
not insolo crea la llave la primera vez.
Después iteramos sobre los artículos y, con otro if, comparamos si la fuente externa es igual al nombre de la fuente del artículo. Si coinciden, lo sumamos con el método append [06:00].
Pasar esto a una comprensión de diccionario evita tener que crear la lista vacía manualmente, porque se genera sola en cada iteración.
La lógica se lee así: trae todas las fuentes, itera sobre ellas y usa cada fuente como llave del diccionario. Dentro del valor, que es una lista, itera los artículos y agrega cada uno solo si su fuente coincide con la que estás recorriendo [07:36].
Al probar ambas versiones con un separador entre los print, el output es exactamente igual [08:13]. La diferencia es que la comprensión anidada elimina el código extra de inicializar llaves.
Las comprensiones funcionan en listas, diccionarios y sets, pero no son una regla obligatoria. Úsalas cuando mejoren la legibilidad, no cuando compliquen la lectura.
Tres recomendaciones prácticas del cierre de la clase:
Un detalle curioso del ejemplo: el editor marcó un error de variable no definida porque el nombre del sample no coincidía, algo que herramientas como estas detectan automáticamente [06:40]. Corregirlo fue tan simple como usar la variable correcta.
¿Ya intentaste refactorizar alguno de tus bucles a comprensiones? Cuéntame en los comentarios qué tan legible te quedó el código.
La estructura de los comprenhensions me recuerda a la de sql en un motor de busqueda.
SELECT (el dato que necesitamos)
FROM (tabla que vamos a recorrer)
WHERE (condicion)
Estas clases me tienen quemando materia gris en forma jajajaja
Hasta el momento, estan buenas las clases, y con ese metodo de quizes tipo "flash, o aprende o aprende
Si les parece muy complicado entender como se va ejecutando el codigo yo les recomiendo este sitio, tan solo toman y pegan el codigo allá, ah medida que avanza se mira como se va ejecutando paso por paso: 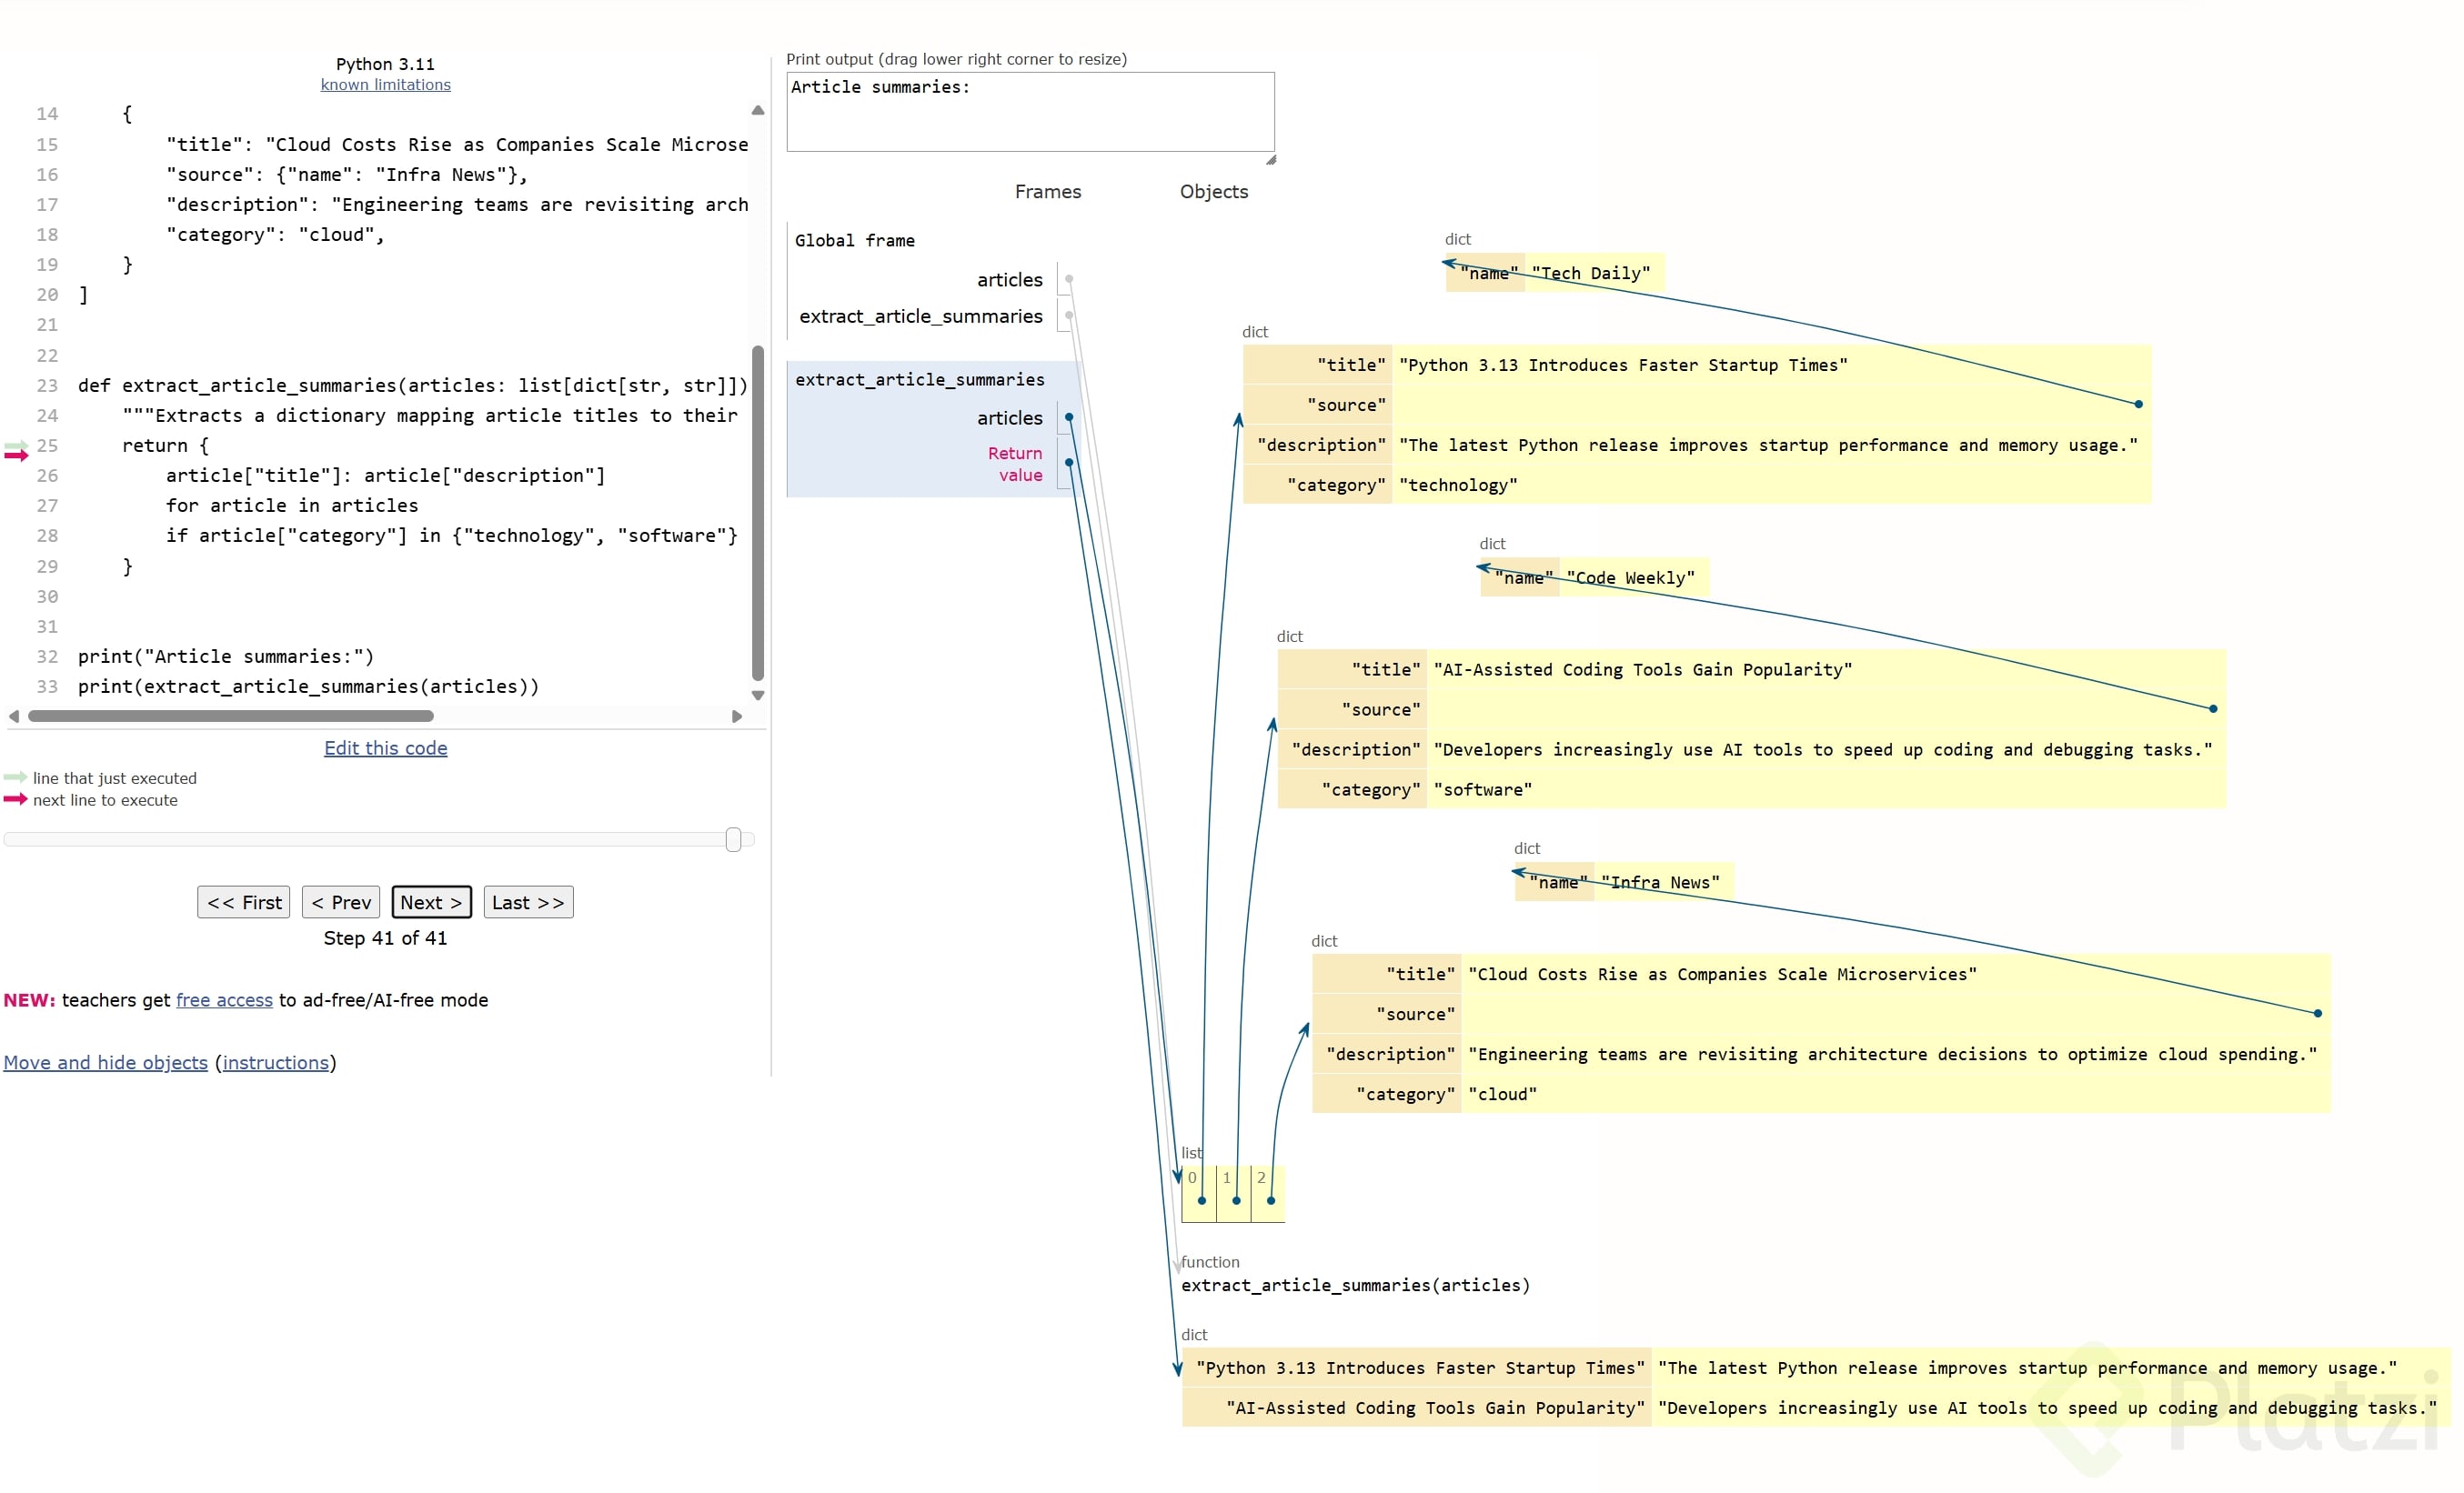
Aprender a usar list, set y dict comprehension para:
🔹 Escribir código más claro y conciso
🔹 Evitar duplicados con sets
🔹 Agrupar información sin perder legibilidad
🔹 Reducir líneas sin alterar la lógica
Son atajos sintácticos para crear listas, conjuntos o diccionarios a partir de bucles y condiciones.
💬 Piensa en ellas como una forma de decir: ➡️ “Toma cada elemento, filtra y transforma en una sola expresión.”
📦 Tipos:
Un set mantiene solo valores únicos → elimina duplicados automáticamente.
def get_sources_traditional(articles):
sources = set()
for article in articles:
source = article.get('source')
if source and source.get('name'):
sources.add(source['name'])
return sources
🧠 Lógica:
def get_sources(articles):
return {
a['source']['name']
for a in articles
if a.get('source') and a['source'].get('name')
}
📘 Lectura:
💡 Comprobación: Imprime ambos resultados: si hay fuentes repetidas, el set mostrará una sola vez cada una.
Queremos agrupar artículos según su fuente → cada fuente será una clave con una lista de artículos.
def categorize_traditional(articles):
sources = get_sources(articles)
results = {}
for source in sources:
if source not in results:
results[source] = []
for article in articles:
art_source = article.get('source')
name = art_source.get('name') if art_source else None
if name == source:
results[source].append(article)
return results
🔍 Lógica paso a paso:
def categorize(articles):
return {
source: [
article
for article in articles
if article.get('source') and article['source'].get('name') == source
]
for source in get_sources(articles)
}
🎯 Ventajas:
✅ Usa comprensiones para patrones de mapear y filtrar.
✅ Utiliza .get() para evitar errores de clave.
✅ Emplea set cuando necesites eliminar duplicados.
✅ Usa comprensiones anidadas para agrupar datos de forma clara.
✅ Verifica equivalencia con print() antes y después del refactor.
✅ Corrige advertencias del linter (como ruff).
✅ Comprueba que las funciones devuelvan datos correctos tras refactorizar.
Esto me ayudó a entender la segunda parte de la clase:
{... for source in sources}[... for article in articles if ...]Esto se llama dict comprenhension y su forma básica es:
- {clave: valor for elemento in algo}🧨
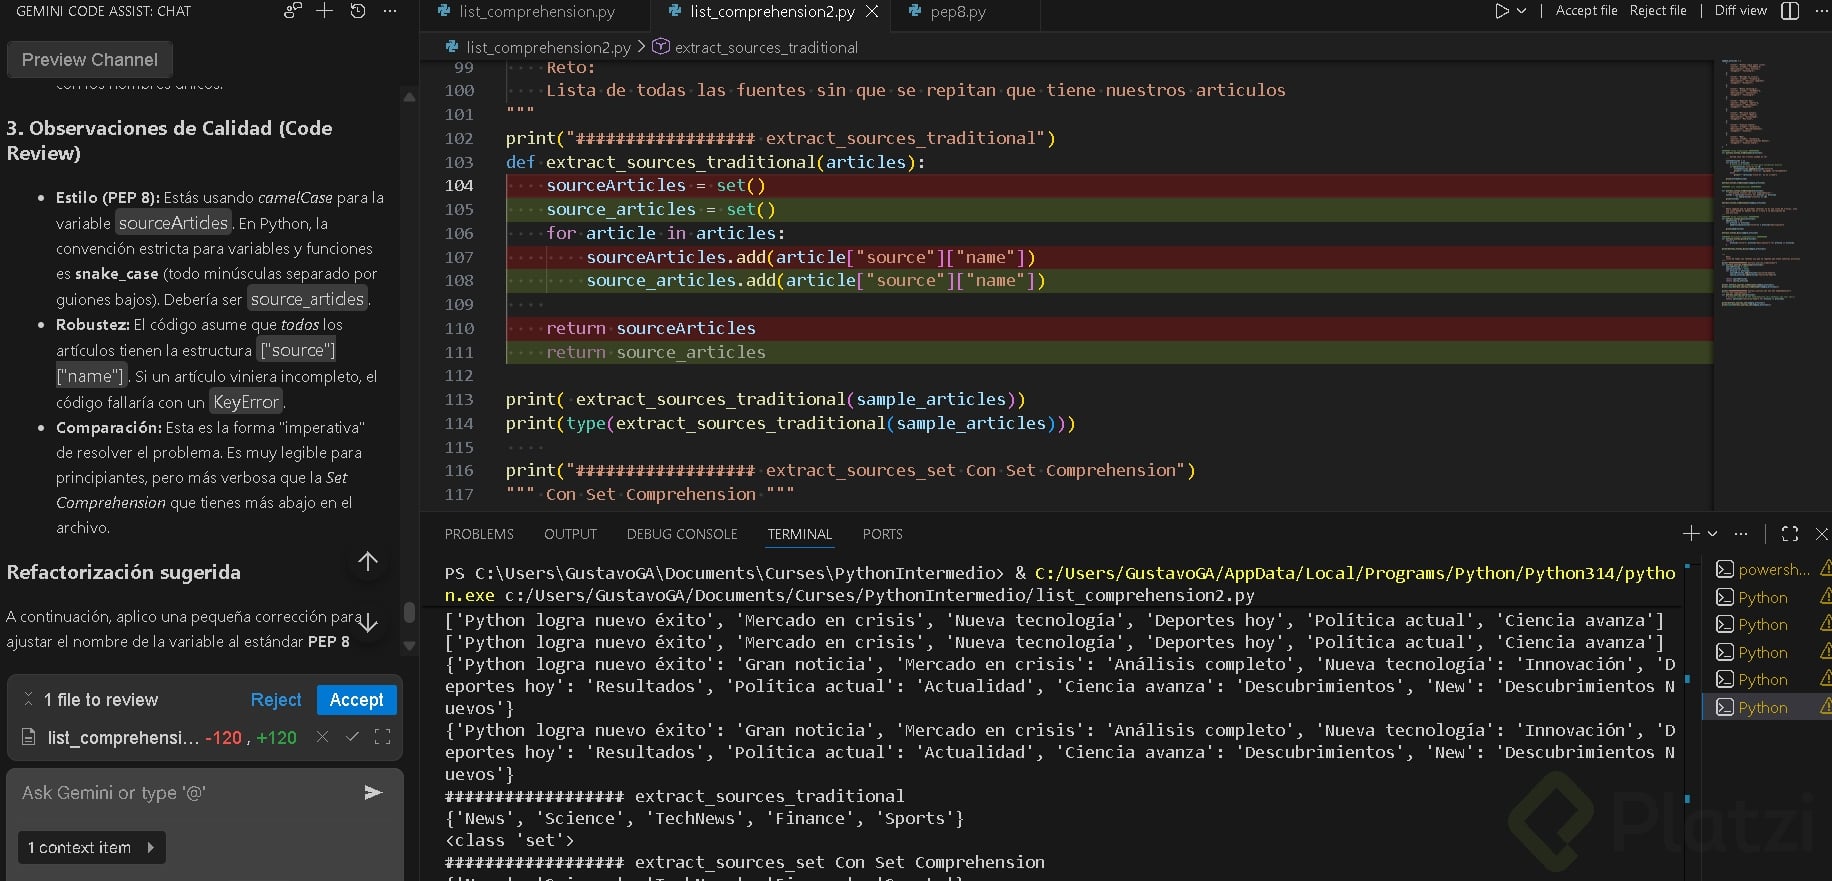
Quiero compartir algo que me impacto. Estoy usando Gemini Code Assist en VSC. Realice el reto de la clase anterior y posterior a eso le pedí a gemini que evaluara mi código y me genero
Eso me boló la cabeza ya que utilizó el contexto de otros archivos (sin que yo se lo dijera) para realizar la observación de calidad.
Yo solamente le puse un prompt pidiendo que analizara mi función, unicamente esa función y automaticamente me sugirió que usara snake case en lugar de camelcase como lo hice en mi código ya que esto no esto no es acorte a PEP 8.
Es el primer asistente de código que uso y de momento me gustó
En el curso de fundamentos de Python era 1+1=2, y en este curso (en especial esta clase) ha sido: si un tren va de China a Japón un martes por la tarde, cual es la distancia de la tierra al sol?... tendré que ver esta clase como 3 veces más para entender que hizo el profe acá...
Las comprensiones anidadas en Python permiten agrupar datos complejos en una sola línea, sustituyendo a los bucles for tradicionales y reduciendo significativamente la cantidad de código.
El código organiza una lista de artículos de noticias en un diccionario, agrupándolos según su medio de origen (source).
categorize_traditional)for explícitos e independientes..append().categorize).append().sample_articles = [
{
"title": "python logra nuevo exito",
"source": {"name": "TechNews"},
"description": "Gran noticia",
"category": "Tecnologia",
},
{
"title": "Mercado en crisis",
"source": {"name": "finance"},
"description": "Analisis completo",
"category": "Economia",
},
{
"title": "Nueva tecnologia",
"source": {"name": "TechNews"},
"description": "Innovacion",
"category": "Tecnologia",
},
{
"title": "Deportes hoy",
"source": {"name": "sports"},
"description": "Resultados",
"category": "Deportes",
},
{
"title": "politica actual",
"source": {"name": "News"},
"description": "Actualidad",
"category": "politica",
},
{
"title": "ciencia avanzada",
"source": {"name": "Science"},
"description": "Descubrimientos",
"category": "Ciencia",
},
]
def get_sources(articles):
return {
article.get("source").get("name")
for article in articles
if (article.get("source") and article["source"].get("name"))
}
def categorize_traditional(articles):
sources = get_sources(articles)
results = {}
for source in sources:
if source not in results:
results[source] = []
for article in articles:
if source == article.get("source").get("name"):
results[source].append(article)
return results
def categorize(articles):
sources = get_sources(articles)
return {
source: [
article
for article in articles
if source == article.get("source").get("name")
]
for source in sources
}
print(categorize_traditional(sample_articles))
print("---------------------------------")
print(categorize(sample_articles))
Sin saber si es o no mas rapido usar compresiones en vez de el for tradicional, pienso que con la practica y con el tiempo sera mas legible usar compresiones, y mayormente cuando sean anidadas. Es mas facil distinguir que sigla y que se busca en la extraccion para luego filtrar.
Interesante, el get permite retornar un valor por defecto si no existe el key, con eso se evita que de un error si no lo encuentra.
claro, supongo que dependerá de la situación el usarlo o no.
sería algo así:
if article.get("source", {}).get("name"):
en este caso, si source no existe, retorna {}