Spoiler: si volver a una versión estable exige recompilar un proyecto (frontend, backend, you name it) y ese proceso tarda muchos minutos, un mal despliegue puede dejarte fuera de línea durante todo ese tiempo :( Eso era lo que nos preocupaba. Qué digo: lo que nos ocurrió al tener frontends con server-side rendering en Workers for Platforms. Y sí, servimos frontends desde Workers for Platforms: nuestra infraestructura vive entre AWS, Cloudflare y más. Es spoiler para otra historia. Nos faltaba algo pequeño y bastante obvio: una forma de volver a una versión anterior sin recompilarla, como lo que ya tienen Workers y Pages de forma nativa. Algo que a estas alturas debería venir incluido.
Así que construimos esa funcionalidad y la pusimos al alcance de un botón. Antes, un error podía dejar a nuestros estudiantes sin poder estudiar durante 20 minutos o más mientras completábamos la recuperación. En las pruebas con esta herramienta, actualizar el Worker con el código anterior tomó tres segundos, más otro par de segundos de propagación. La experiencia que buscamos es casi un «dale refresh y sigue aprendiendo».
Tú pensarás: «¿Pero no probaste antes de ir a producción?». Sí. Incluso en Platzi nos gusta hablar de nuestro multistaging, donde hoy ya estamos todos subidos y podemos probar los cambios de forma aislada. Lo construimos antes de esta era de IA y, vaya, vaya, con IA sí que se le saca provecho. Pero eso es otro tema.
Con IA, escribir código se ha vuelto mucho más rápido. Pero producir más código no demuestra que estemos construyendo algo útil. El cuello de botella se movió: el trabajo sigue siendo validar si lo que hacemos mejora la vida de los usuarios; en nuestro caso, nuestros estudiantes. A veces esa mejora es una nueva experiencia. Otras veces es que la experiencia que ya usan vuelva a funcionar cuanto antes.
Y sí, los feature flags, los experimentos y demás ayudan a reducir el riesgo. Pero ajá, siempre puede ocurrir un incidente y necesitas un rollback rápido.Este feature nació para que nuestros estudiantes pudieran volver a aprender cuanto antes.
Hasta 20 minutos para volver atrás
Llevamos tiempo usando Workers para servir frontends con SSR, es decir, para generar las páginas en el servidor antes de entregarlas al navegador. Cuando un despliegue sale mal, poder regresar a una versión estable es parte de operar ese producto.
Si la salida es revertir el código y ejecutar otra vez el proceso de compilación y despliegue, la recuperación queda amarrada a la duración del build. En nuestro flujo anterior, un rollback completo podía tomar hasta 20 minutos. Con estudiantes esperando, ese tiempo pesa.
Podemos discutir por qué un frontend tarda tanto en compilar. Es una discusión válida y vale la pena optimizarlo. Pero incluso con un build más rápido, recuperar una versión que ya funcionaba debería ser una operación directa.
En Cloudflare Pages y en Workers normales ya habíamos vivido la diferencia: sus herramientas de rollback nos salvaron varias veces y nos permitieron recuperarnos en segundos. Ambos productos permiten volver a despliegues anteriores sin reconstruirlos. Rollback en Pages y rollback en Workers.
Workers también tiene despliegues graduales nativos: puedes repartir tráfico entre versiones y construir encima la lógica de un canary, con tus criterios para avanzar o retroceder. Esa capacidad está documentada en Gradual Deployments.
Con esa capacidad disponible en otros productos, que Workers for Platforms no tuviera una funcionalidad equivalente de rollback nos resultaba difícil de entender.
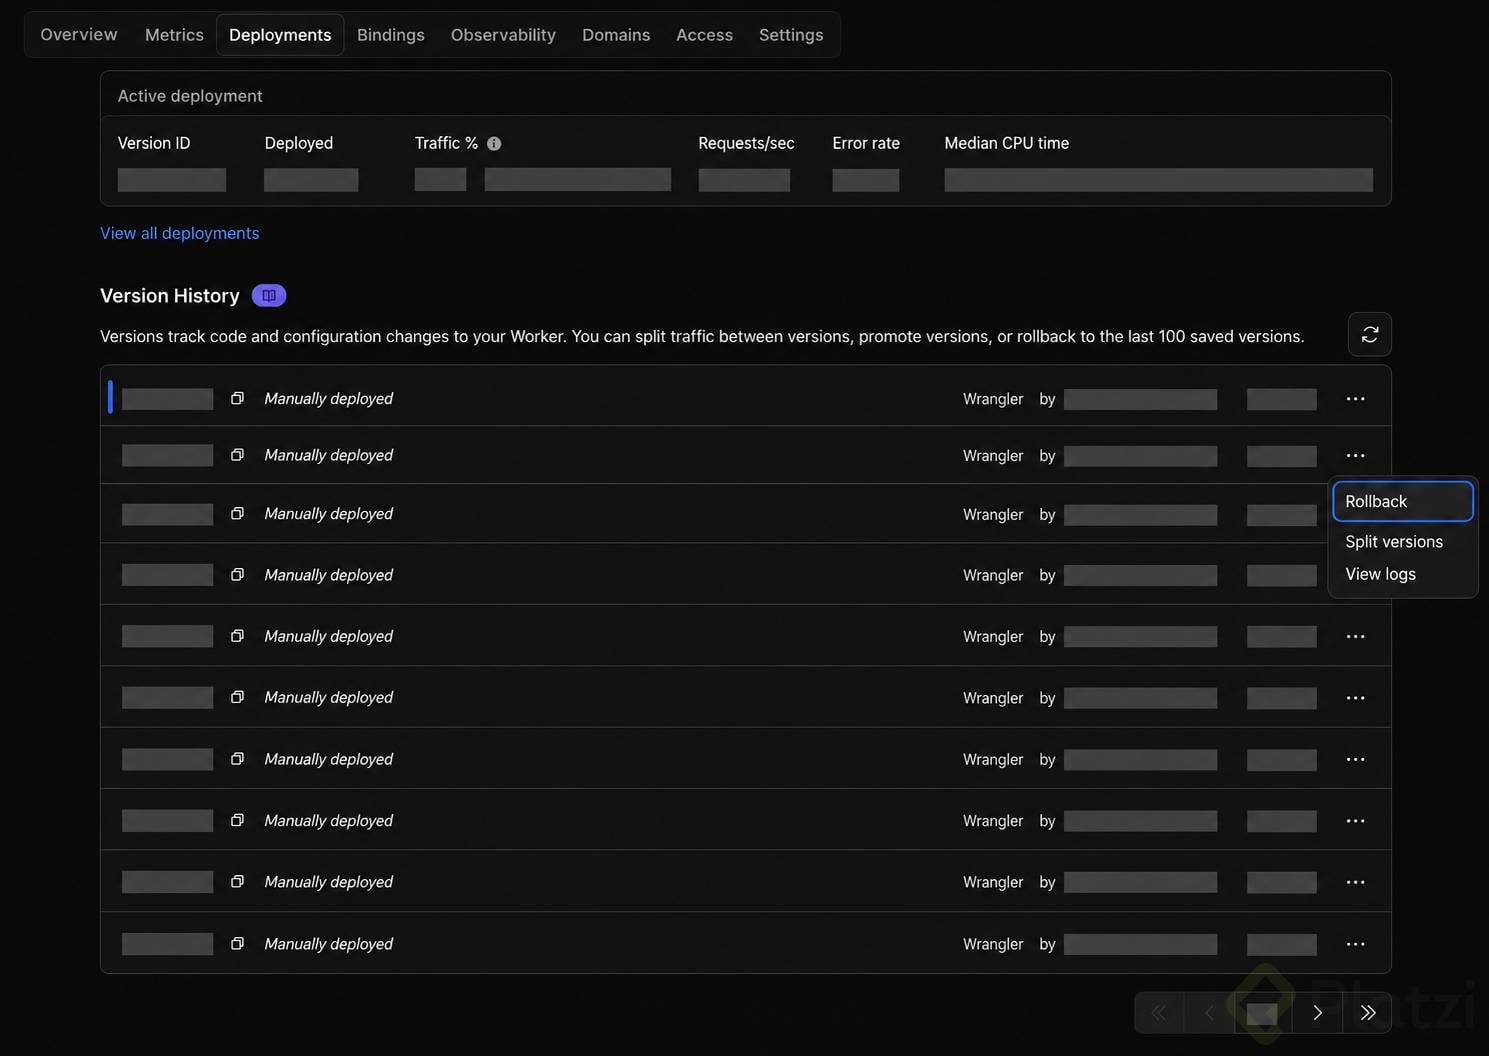
En un Worker normal, el historial y la opción de volver a una versión anterior están a mano. Datos internos ocultos.
Mucho potencial, una experiencia de operación incompleta
Workers for Platforms permite que una plataforma despliegue y ejecute Workers de forma programática, con un Worker despachador que decide a cuál enviar cada petición. Es una pieza muy potente para construir sistemas dinámicos. Así lo presenta Cloudflare.
En Platzi lo adoptamos desde sus primeras etapas. Es parte de la base dinámica de nuestro API Gateway, donde resolvemos reglas de routing, autenticación, caché y otras necesidades. Esa arquitectura merece su propia historia; la dejamos para otro blog.
Cloudflare hace muy bien algo que valoramos mucho: su enfoque API-first. Poder integrar sus capacidades en nuestras propias herramientas y automatizaciones es parte de lo que hace tan potente esta plataforma. Precisamente por eso, echábamos de menos una operación de rollback que nos permitiera elegir una versión anterior y restaurarla. Ese era el hueco que necesitábamos cubrir.
También hay espacio para mejorar la visibilidad en el panel. En el de un Worker normal encuentras versiones, despliegues, configuración y acciones para recuperarte. En la vista de Workers for Platforms que usamos, la experiencia sigue siendo mucho más limitada. Ahora podemos ver los bindings, las conexiones del Worker con otros recursos. Gracias por eso: antes teníamos todavía menos visibilidad.
La configuración se puede consultar por API, y reunirla con el historial de releases nos ayuda a operar. Cloudflare documenta esa consulta de configuración. En nuestra herramienta juntamos esa visibilidad con la funcionalidad de rollback que construimos. El panel es la forma de poner ambas cosas a mano del equipo.
Además, al escribir este artículo, la documentación indica que los user Workers de Workers for Platforms todavía no soportan Gradual Deployments: los cambios se despliegan al 100 % del tráfico. Límites de Workers for Platforms.
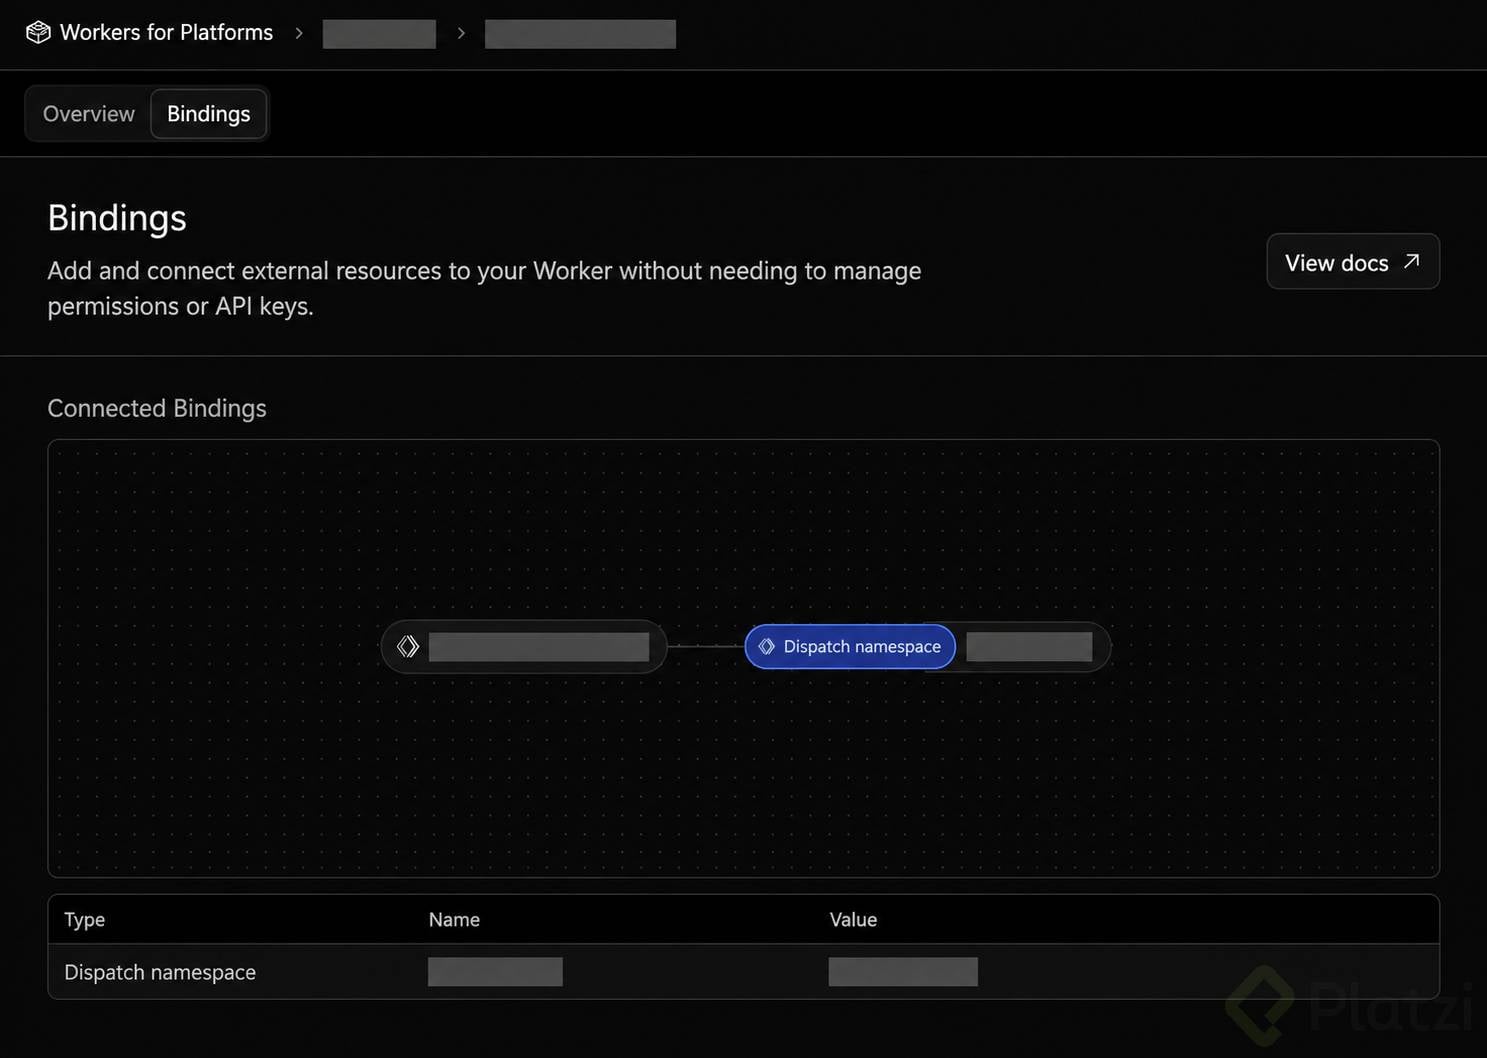
La vista de bindings mejoró la visibilidad, pero todavía nos faltaba la funcionalidad de rollback. Datos internos ocultos.
El feature: ver qué está corriendo y poder volver atrás
Construimos una herramienta interna que reúne lo que necesitábamos para tomar esa decisión:
- La release que está desplegada.
- El historial de releases, con su fecha y referencias al commit y a la ejecución del pipeline.
- La configuración actual y la opción de consultar la configuración de cada release.
- Un botón de Rollback junto a las releases anteriores.
¿Qué hay detrás del botón? Agregamos una acción al pipeline que, después del deploy, descarga el bundle compilado exactamente como quedó en Cloudflare y lo guarda comprimido en formato gzip en R2. Para volver atrás, otro Worker recupera ese paquete y lo envía nuevamente por API. Sin recompilar.
También nos encargamos de limpiar los artefactos antiguos, con una política de retención por cantidad de versiones y antigüedad. Porque guardar versiones está muy bien, pero tampoco necesitamos coleccionarlas para siempre.
En las pruebas, actualizar el Worker con el código anterior tomó tres segundos. A eso se suma lo que tarda Cloudflare en propagar la actualización, que en nuestra experiencia suele ser otro par de segundos. Volver al código anterior pasa a ser una operación de segundos, sin esperar otra compilación. Detectar el problema y comprobar que la experiencia se recuperó también forman parte del incidente, pero la actualización del Worker ya no nos deja esperando un build.
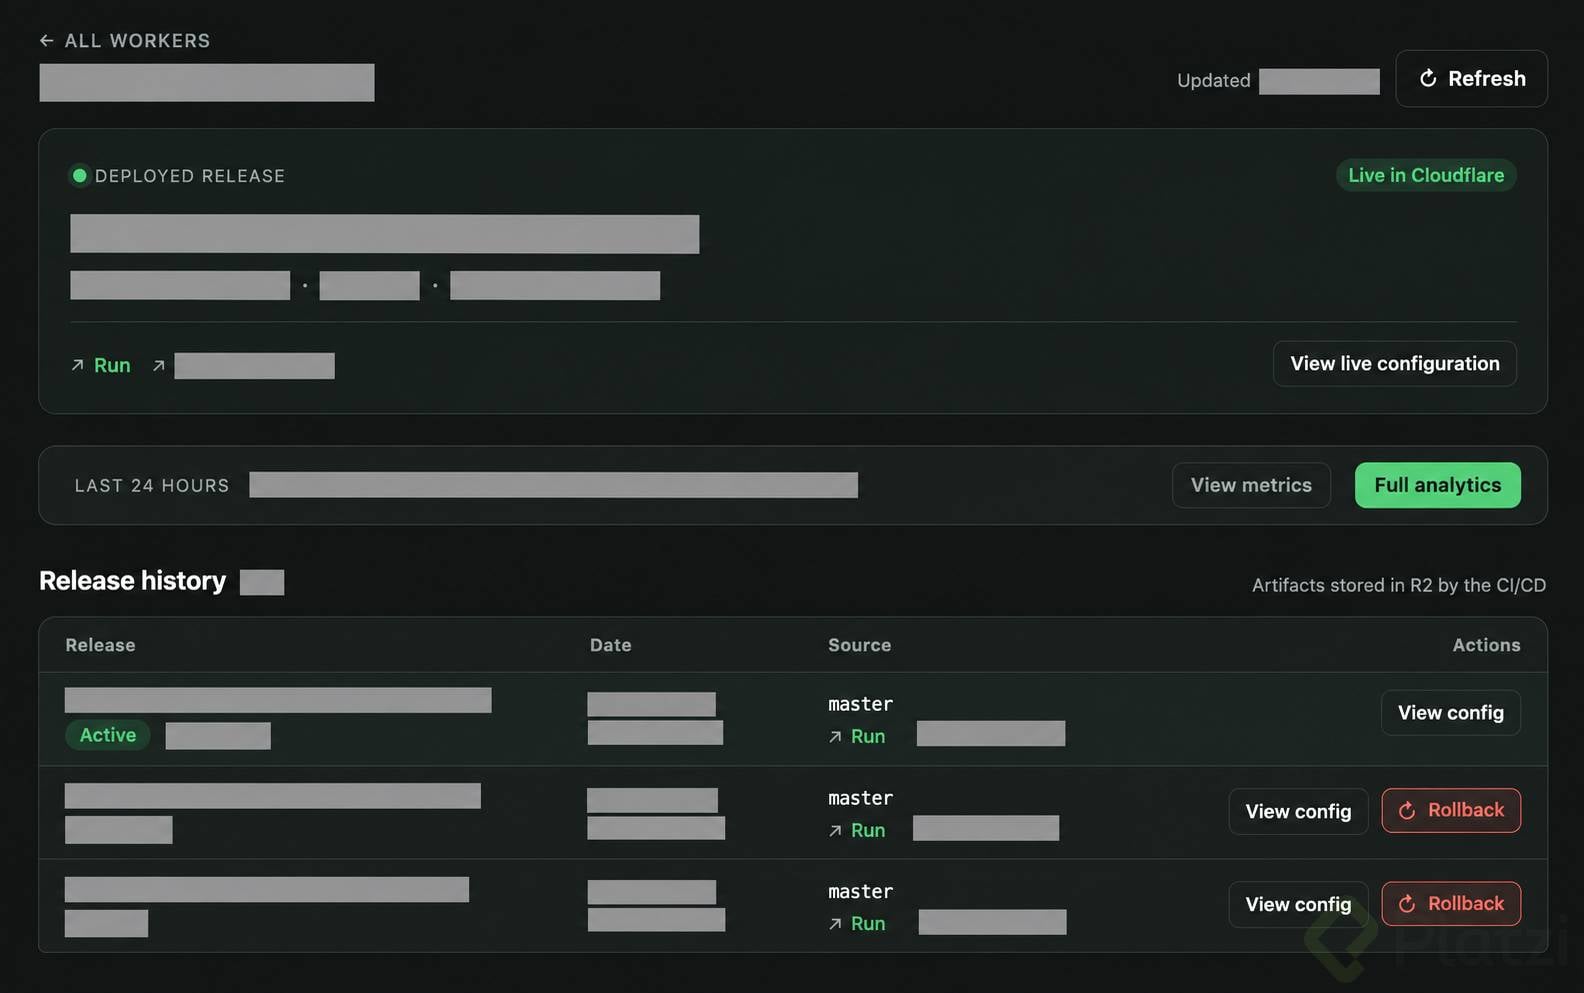
La release activa, el historial y la acción de rollback, en una misma vista. Datos internos ocultos.
La configuración también importa. Durante un incidente necesitas saber qué quedó desplegado: fecha de compatibilidad, flags, bindings y opciones de observabilidad. Tenerlo en el mismo lugar ayuda a entender sobre qué versión estás tomando una decisión.
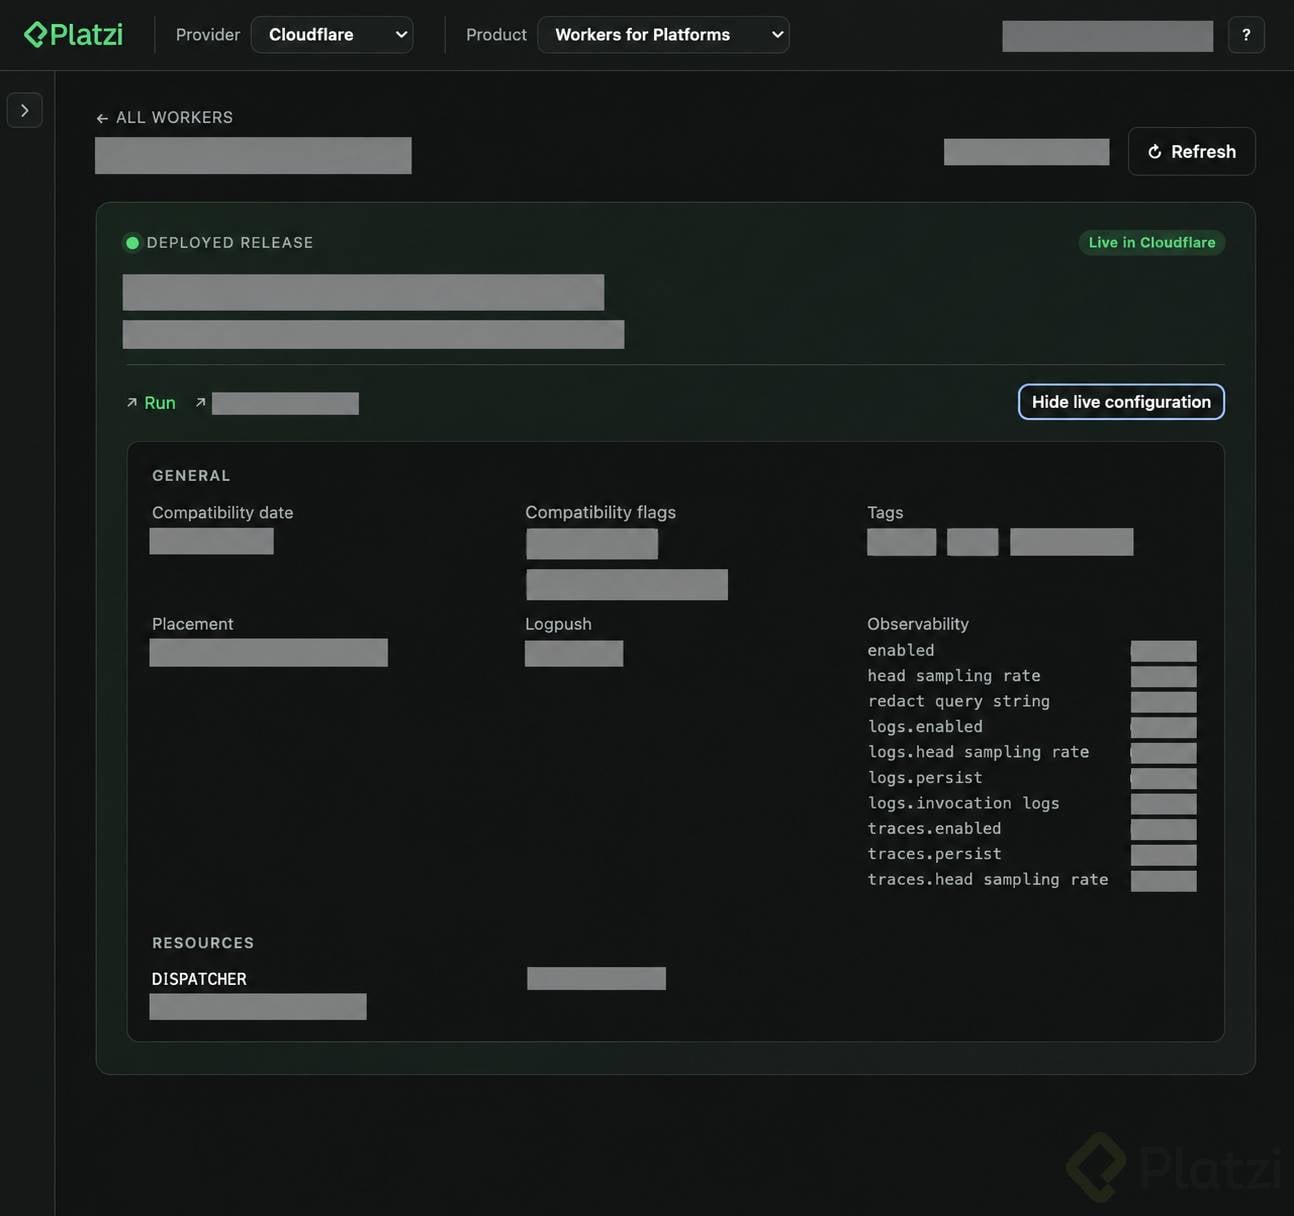
Consultar la configuración desplegada sin salir del contexto de la release. Datos internos ocultos.
Un botón así difícilmente protagoniza una demo de producto. Pero para alguien que está intentando entrar a una clase, cada minuto que podamos quitarle a un incidente sí cuenta.
Y ahí está la validación que me interesa: cuánto tardamos en identificar la versión estable, ejecutar la recuperación y comprobar que la experiencia volvió a funcionar. Ese es el resultado que hay que medir. Tener una interfaz bonita o haber escrito el código muy rápido no basta.
Cloudflare: ojalá nos vuelvas a ahorrar mantener esto
Tengo la sospecha de que en unos días o meses Cloudflare va a lanzar algo parecido y este artículo tendrá un comentario mío diciendo: «Ya lo hicieron 😈».
Mientras tanto, déjennos presumir un poco.
Ya hemos vivido situaciones parecidas. Como clientes Enterprise, recuerdo conversaciones con ingenieros de Cloudflare sobre por qué no podíamos tener una capa de caché delante de un Worker con la experiencia que buscábamos, como la caché del CDN delante de un servidor de origen externo. Había explicaciones y restricciones, pero la necesidad seguía ahí. Terminamos construyendo nuestro propio motor sobre Workers con KV, dentro de lo que en Platzi llamamos API Gateway.
Y el 6 de julio de 2026 Cloudflare anunció Workers Cache: una caché delante del Worker.
Vaya, vaya.
También teníamos una solución propia de AI Gateway antes de que apareciera la de Cloudflare; esa historia incluso quedó recogida en su caso de estudio sobre Platzi.
También nos pasó con los despliegues. Cloudflare tiene una experiencia de builds muy buena; nosotros ya teníamos la nuestra, integrada con ese ecosistema multistaging que les mencioné al principio. Y en los primeros días de Workers for Platforms, hasta desplegar tenía su historia: había poca documentación, teníamos nuestros hacks y terminamos creando una librería para hacerlo.
Cuando Wrangler incorporó el soporte que necesitábamos, archivamos esa librería. Otro de varios desarrollos internos que hemos podido retirar conforme Cloudflare incorpora esas capacidades. Y nosotros felices: menos cosas que mantener. Ojalá a este rollback también le llegue su rollback, hehehe 😈.
Para mí, esto habla de necesidades que aparecen cuando llevas estas herramientas a producción. A veces las resuelves tú primero y después el proveedor las convierte en producto. Bienvenido sea: prefiero dedicar ese tiempo a lo siguiente que nuestros estudiantes necesiten.
Construye algo y cuéntanos cómo te fue
Si quieres explorar la capa de Developer Platform de Cloudflare, puedes empezar por el Curso de Cloudflare Workers en Platzi.
Y sigue explorando después en su documentación. Hay piezas para ejecutar código, guardar datos, coordinar procesos y construir agentes. Workers for Platforms es una de esas herramientas cuyo potencial me gustaría ver en más conversaciones.
Después de años ayudando a crear, mantener y escalar productos en Platzi, sigo pensando que este proveedor se paga solo. Y voy a decir una sola palabra: caché.
Quienes me conocen saben el trasfondo. Caché fría, caché caliente, estrategias de invalidación, qué guardar, cuándo servirlo y cuándo volver al origen… Podría quedarme hablando de eso otro buen rato. Cloudflare ha sido un buen aliado para dejar volar esa imaginación y llevarla a producción.
¿Qué te gustaría aprender a construir con Cloudflare? No necesitas estar trabajando con esta tecnología: cuéntanos tu idea o qué te da curiosidad y podemos dedicarle otro blog o incluso un curso nuevo enfocado en eso en particular. Durable Objects es un productazo y su SDK de agentes es otra estrella. Hay mucho por explorar.
Y hay algo de Workers que me encanta: la alta disponibilidad de la capa de ejecución viene resuelta por la plataforma. Despliegas en la red global de Cloudflare sin tener que replicar tu Worker región por región ni administrar servidores en cada ubicación. Pero si desplegamos un error, también lo distribuimos globalmente. El bug también disfruta de la alta disponibilidad. Ahí vuelve a entrar nuestro botón de rollback.
Y si ya desarrollas o mantienes aplicaciones, cuéntanos qué te ha ayudado a desplegar con confianza y recuperarte cuando algo falla. ¿Qué herramientas usas y qué funcionalidad has tenido que construir porque te hacía falta?
Curso de Cloudflare Workers
COMPARTE ESTE ARTÍCULO Y MUESTRA LO QUE APRENDISTE