Al ser un curso de nivel intermedio, agradezco que el curso maneje solo 2 algoritmos y altamente relacionados
PERO siento que le faltaron modulos, y algunas cosas fueron superficiales, los EDA no fueron propiamente EDA
No se toco como hacer PCA, esos dos aspectos pasables, complementamos con otros cursos
Lo que si falto fue dedicar un modulo a los parametros de los algoritmos en sklearn, y como su modificación afecta nuestros resultados, EJ no se dijo nada de n_jobs, class_weight, max_features y muchas otras
o como seleccionar su valores mas correctos
sin dejar de lado que tampoco se planteo la búsqueda de los mejores hyper parametros
No digo que lo que hay este mal, solo que puede ser mejor
y si alguien dice, pues ve y lee la documentación ... Eso lo puedo hacer sin pagar una subscripción a un curso
Hola Edwin :) gracias por tus comentarios, sin dudas hay muchos temas que se podrian agregar y se toman en cuenta. Respecto a los otros algoritmos que comentan, en este curso solo se abordan unicamente esos dos, ninguno mas! forma parte de la propuesta educativa. Un saludo!
No tiene mucho sentido entrenar árboles y bosques con PCA, incluso Sin normalización z-core de los datos les va bien porque no son tan sensibles a valores atípicos. Mas bien encontrar variables altamente correlacionadas en el EDA es más relevante porque estos modelos se sobre ajustan mucho.
Gracias Felix, excelente aporte :)
me genera curiosidad como lograste eso. Es posible que nos puedas compartir como se logra? Saludos.
Experimentos con Random Forest
Entrenando con 5 features
["buying","maint","persons","lugboot","safety"]
descontando el feature "doors" por tener un bajo feature_importance
Aplicando Random Forest el accuracy fue:
Train accuracy: 0.97
Test accuracy: 0.93
Además la matriz de confusión fue el sgte:
Despues usé GridSearchCV
obteniendo un modelo con los sgtes parámetros:
{'criterion': 'gini', 'max_depth': 10, 'n_estimators': 20}
con un score de 0.94
usando el sgte codigo
from sklearn.model_selectionimportGridSearchCVparametros ={"n_estimators":range(1,40),"criterion":["gini","entropy","log_loss"],"max_depth":range(2,11)}rf_grid =GridSearchCV( rf, parametros, cv=5, scoring="accuracy", verbose=1, n_jobs=-1).fit(X_train,y_train)
Fitting 5 folds for each of 1053 candidates, totalling 5265 fits
En lo personal, si me gusto que el curso se mantuviera básico.
Hay muchos cursos que termina uno haciendo cosas increibles, pero de los que se entiende muy poco de fondo.
Es más, me gustaría uno donde se pudiera explorar de donde salen las formulas básicas de sklearn antes de seguir sacando librerias para obtener resultados.
Gracias por el curso.
Gracias Mauricio, se anexo informacion sobre este tema, para complementar! Un saludo!
Accurancy del reto anterior("safety ","persons")
En lo que anteriormente concluimos como las variables relevantes.
Disculpa, podrías explciar la matriz de confusión para este caso?
Hola Johan, se explica. Fijate en los recursos que se menciona, el tema. Sino tambien, lee los post, lo han comentado otros estudiantes. Saludos :)
Al re entrenar el modelo con menos variables no logré un cambio significativo en el modelo. Pero al cambiar el max_depth si que se han notado los cambios. Aquí un sumario:
maxdepth = 2. Vemos que el desicion tree por si solo ha tenido mejor desempeño que el random forest, lo cuál "tendría" sentido dado que el random forest brilla mucho más con datasets grandes. y el dataset actual es pequeño (1708 filas)
sin embargo no es la máxima capacidad del algoritmo y tampoco es el mejor resultado que podemos obtener
resultados: train 0.71, test 0.70
aclaraciones: El desempeño del Decision Tree y el Random Forest puede variar dependiendo de varios factores, no solo del tamaño del dataset. En este caso, el Decision Tree puede haber obtenido un mejor desempeño debido a la configuración específica de los parámetros o a la naturaleza de los datos. A grandes rasgos no se podría generalizar que el Decision Tree siempre superará al Random Forest en datasets pequeños
maxdepth = 5. El desempeño del random forest ha mejorado de manera significativa (~ más de 10 puntos porcentuales), llegando a train 0.83, test 0.80
lo cuál indica que el especificar la profundidad del árbol es muy importante para obtener los mejores resultados
max depth = 10 .El desempeño del random forest ha mejorado aún más que las vez anterior, habiendo un incremento de 20 puntos porcentuales que el mínimo obtenido con el max_depth = 2 siendo: train 0.98, test 0.90
Lo curioso es que este resultado es parecido (aunque no exactamente igual) que simplemente no colocar especificar este parámetro.
(sin especificar max depth) El parámetro max_depth en el Random Forest no tiene un valor predeterminado, por lo que si no se especifica se expandirá hasta que todas las hojas sean puras o hasta que todas las hojas contengan menos de min_samples_split muestras. En este caso específico, la mejora en el desempeño del modelo con max_depth = 10 puede deberse a una mejor capacidad de generalización y control del sobreajuste. En resumen, le atiné con el 10 :D
feature importances tree vs forest:
También me aventé esta cosa que encontré chusmeando en sklearn, que no tengo idea de qué significa pero se ve muy intelectual y elegante:
#plot_tree(tree_model, filled=True,# rellenar nodos con colores feature_names= X.columns, class_names= y.unique(),# exitar que se repitan las clases fontsize=10)plt.show()
Genial la prueba Mauricio :) excelente.
Si queremos conocer el performance de nuestro modelo en función del número de estimadores, podemos usar este código que escribí basado en el aporte de un compañero.
defperformance_plot(n_estimators, X, y)-> plt.plot: perform_dict ={"test":[],"train":[]}for i inrange(1, n_estimators+1):# Spliting data, 30% for training and 70% for testing. X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42, test_size=0.3)# Encoding data encoder = ce.OrdinalEncoder(cols=['buying_price','maint_cost','n_doors','n_person','lug_boot','safety']) X_train = encoder.fit_transform(X_train) X_test = encoder.transform(X_test)# Creating Random Forest model random_forest = RandomForestClassifier(n_estimators=i)# Training model random_forest.fit(X_train, y_train)# Predicting y_pred_test = random_forest.predict(X_test) y_pred_train = random_forest.predict(X_train)# Metrics a_test = accuracy_score(y_test, y_pred_test) a_train = accuracy_score(y_train, y_pred_train) perform_dict["test"].append(a_test) perform_dict["train"].append(a_train)# Dataframe perform_data = pd.DataFrame(perform_dict).reset_index().rename(columns={"index":"iteration"})( perform_data[["test","train"]].pipe(lambda df:( df.test.interpolate(method="linear").plot(color="black", marker="o", alpha=6/9, linestyle="dashed"), df.train.interpolate(method="linear").plot(color="red", marker="o", alpha=6/9, linestyle="dashed")))) plt.grid() plt.xlabel("Number of iterations") plt.ylabel("Performance") plt.show()```De esta forma, tendremos gráficas como estas: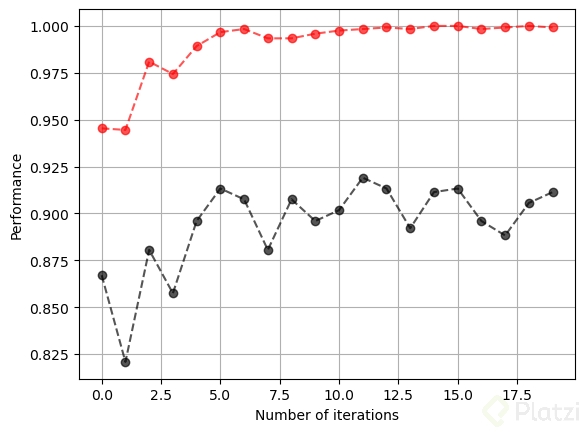
Un muy buen curso sin duda de los que más aprendi siendo alguien que recien comienza en el mundo del DataScience.
De las mejores explicacion con los modulos muy parametrizados.
Muy buen curso, muy bueno para entender de forma adecuada los modelos de ML, ya que en cierto aspecto, algunos pasos o tematicas son similares entre si, muchas gracias 💪💪💪.
AJUSTES EN EL MODELO
Para este nuevo modelo, ejecuta las siguientes celdas **en orden**. No necesitas usar category\_encoders ni el OrdinalEncoder.
La idea será:
1. Separar X e y.
2. Usar únicamente safety, buying y persons.
3. Dividir los datos.
4. Codificar variables categóricas con OneHotEncoder.
5. Buscar hiperparámetros con GridSearchCV.
6. Evaluar con accuracy, matriz de confusión y classification\_report.
## Celda 1: importar librerías
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.model\_selection import train\_test\_split, GridSearchCV
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
from sklearn.pipeline import Pipeline
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import(  accuracy\_score,  confusion\_matrix,  classification\_report)
## Celda 2: verificar el dataframe
Esta celda supone que ya ejecutaste la carga de df\_car y que sus columnas tienen nombres.
df\_car.head()
Si todavía no asignaste los nombres, ejecuta primero:
## Celda 3: seleccionar únicamente las variables necesarias
Usaremos como características:
- safety
- buying
- persons
La variable objetivo será class.
features = \['safety','buying','persons']X = df\_car\[features]y = df\_car\['class']
## Celda 4: verificar X e y
print("Características utilizadas:")display(X.head())print("\nVariable objetivo:")display(y.head())print("\nDimensiones de X:", X.shape)print("Dimensiones de y:", y.shape)
El resultado esperado para X será:
(1728, 3)
## Celda 5: revisar los valores categóricos
for column in features:  print(f"\nValores de {column}:")  print(X\[column].unique())
También puedes revisar la distribución de la variable objetivo:
y.value\_counts()
## Celda 6: separar entrenamiento y prueba
Usaremos el 70 % para entrenar y el 30 % para evaluar.
stratify=y conserva aproximadamente la misma proporción de clases en ambos conjuntos.
## Celda 17: calcular accuracy en entrenamiento y prueba
train\_accuracy = accuracy\_score(y\_train, y\_train\_pred)test\_accuracy = accuracy\_score(y\_test, y\_test\_pred)print("Accuracy en entrenamiento:", train\_accuracy)print("Accuracy en prueba:", test\_accuracy)
El valor más importante es el accuracy de prueba:
test\_accuracy
Con estas tres variables, normalmente deberías obtener un resultado dentro o cerca del rango solicitado de 0.7 a 0.9. El valor exacto depende de la versión de las librerías y de la división de los datos.
No conviene forzar artificialmente el accuracy. Si supera 0.9, significa que el modelo obtuvo un resultado mejor que el rango solicitado; en ese caso debes reportarlo correctamente.
## Celda 18: comprobar el rango solicitado
if0.7 \<= test\_accuracy \<=0.9:  print("El accuracy está dentro del rango solicitado.")else:  print("El accuracy está fuera del rango solicitado.")
## Celda 19: calcular la matriz de confusión
cm = confusion\_matrix(y\_test, y\_test\_pred)print("Matriz de confusión:")print(cm)
Para conocer el orden de las clases:
class\_labels = best\_model.named\_steps\['model'].classes\_
print("Orden de las clases:")print(class\_labels)
La matriz se interpreta así:
- Filas: clases reales.
- Columnas: clases predichas.
- Diagonal principal: predicciones correctas.
## Celda 20: visualizar la matriz de confusión
plt.figure(figsize=(7,5))sns.heatmap(  cm,  annot=True,  fmt='d',  cmap='Blues',  xticklabels=class\_labels,  yticklabels=class\_labels)plt.xlabel('Clase predicha')plt.ylabel('Clase real')plt.title('Matriz de confusión - Random Forest')plt.show()
df\_car
  -> X e y  -> train\_test\_split  -> OneHotEncoder  -> Pipeline  -> GridSearchCV  -> Random Forest optimizado  -> accuracy  -> confusion\_matrix  -> classification\_report
Este enfoque evita entrenar el encoder con información del conjunto de prueba y permite que GridSearchCV compare las combinaciones de hiperparámetros de forma correcta.
Mejores hiperparámetros:
{'model__max_depth': 5,
'model__max_features': 'sqrt',
'model__min_samples_leaf': 1,
'model__min_samples_split': 2,
'model__n_estimators': 200}
¿Puedo saber qué variables importan más?
¡Totalmente! Una de las grandes ventajas de usar Random Forest frente a otros algoritmos más opacos es que te permite ver dentro de su proceso de decisión mediante la importancia de características (feature importance). Una vez que tu modelo está entrenado, puedes extraer un ranking de cuáles variables tuvieron más peso al momento de clasificar. Por ejemplo, si estás prediciendo el tipo de un vehículo, el modelo podría revelarte que el 'número de puertas' y el 'tamaño del motor' definen el 80% de la decisión, mientras que el 'color' casi no importa. Esta evaluación no solo te ayuda a entender el modelo, sino que te permite simplificarlo en el futuro eliminando las variables que solo aportan ruido.
¿Cómo mido el éxito de mi modelo?
Para evaluar un modelo de Random Forest, no basta con mirarlo por encima; necesitas métricas específicas que actúen como un 'examen médico' de tus predicciones. En clasificación, las herramientas más comunes son la matriz de confusión y el reporte de clasificación (que incluye Precision, Recall y F1-Score). Imagina que tu modelo es un filtro de spam. No solo quieres saber cuántos correos clasificó bien en total, sino también cuántos correos importantes mandó a la papelera por error. Usando la librería scikit-learn, puedes generar estas métricas rápidamente con funciones como classification_report. Esto te dará una visión panorámica de dónde tu bosque aleatorio es fuerte y en qué categorías específicas se está confundiendo, permitiéndote ajustar los hiperparámetros de manera mucho más estratégica.
reto: reducir el numero de estimadores y usando solo los features mas importantes se obtiene los siguientes resultados:
Al reducir el estimador por debajho de 10, no se apreciaban cambios en los valores de acurracy
Comparando los valores de clasificacion se puede notar que si se ven valores significativos cuando se usa todos los valores o solo los mas importantes en cuanto a la precision, recall y el f1-score y mantiene igual el support.
Como paso final, se comparará el performance del modelo de Decision Tree y Random Forest
🔹 Precision: De los que predije como clase X, ¿cuántos eran realmente X?
🔹 Recall: De todos los que eran clase X, ¿cuántos los detecté correctamente?
🔹 F1-score: Promedio ponderado de precisión y recall.
✅ 4. Importancia de características
Para saber qué variables influyen más en el modelo:
importances = model.feature_importances_
for col, imp in zip(X.columns, importances):
print(f"{col}: {imp:.4f}")
🎯 Ejemplo de salida esperada (si se usó el código anterior)
Accuracy del modelo: 0.80
precision recall f1-score support
alto 0.75 1.00 0.86 1
bajo 1.00 0.50 0.67 2
medio 1.00 1.00 1.00 1
¿En que situación podría ser mejor un solo Árbol de Decision, frente a un Random Forest?
Hola Leandro, generalmente cuando tenes pocos datos y un dataset chico. Ya cuando tenes mas cantidad de datos siempre es mejor un RF :) Pero acordate que es muy importante que estes validando con metricas tus modelos. Un saludo!
Entiendo. Muchas Gracias.
Este tipo de evaluación solo funciona con los Randon forest o se puede utilizar con otros modelos como regresión lineal, logística, etc?
Hola, Luis.
La evaluación de resultados en un modelo de clasificación, utilizando métricas como precisión, recall, F1-score, matriz de confusión, etc., no está limitada exclusivamente al modelo de Random Forest. Estas métricas pueden ser utilizadas para evaluar el rendimiento de cualquier modelo de clasificación, incluyendo modelos como regresión logística, regresión lineal, SVM (Support Vector Machines), entre otros.
Es importante tener en cuenta que cada modelo tiene sus propias características y supuestos, por lo que las métricas y técnicas de evaluación pueden variar en función del modelo utilizado. Por ejemplo, en un modelo de regresión logística, se pueden utilizar métricas como la precisión, recall y F1-score, así como el área bajo la curva ROC (AUC-ROC), que es específica para problemas de clasificación binaria.