API Gateway como puerta de big data
Contenido del curso


Arquitecturas


Extracción de información
- 9

Cómo mover datos a cloud con SDK y CLI
02:21 min - 10

Python y boto3 para listar buckets S3
10:16 min - 11

Boto3: inicializar clients de AWS en Python
03:56 min - 12

API Gateway como puerta de big data
Viendo ahora - 13

Storage Gateway: puerta entre on-premise y S3
03:13 min - 14

AWS Kinesis: streaming masivo de datos
05:53 min - 15

Cómo crear Kinesis Data Stream en AWS
06:50 min - 16

Despliegue automatizado de Kinesis con CloudFormation
10:42 min - 17

Cómo Kinesis Firehose entrega datos en tiempo real
03:27 min - 18

Configuración de Kinesis Firehose en AWS
05:45 min - 19
Configuración Básica de Amazon Kinesis Firehose en AWS
02:53 min - 20

MSK vs Kinesis: cuál elegir en AWS
03:42 min - 21

Creación de clúster AWS MSK desde la consola
07:21 min
Transformación de Información
- 22

Cómo AWS Glue transforma datos en la nube
06:33 min - 23

Instalación de Apache Zeppelin paso a paso
04:49 min - 24

Configurar developer endpoint de AWS Glue con Zeppelin
05:38 min - 25

Conexión de Apache Zeppelin con AWS
08:29 min - 26

Configurar AWS Glue Crawler para poblar catálogo
08:15 min - 27

Configuración de Developer Endpoint en AWS Glue
08:00 min - 28

Cómo configurar AWS Glue ETL desde S3 a Parquet
10:23 min - 29

Qué es EMR y cuándo usarlo
05:30 min - 30

Crear tu primer cluster de AWS EMR
09:01 min - 31

Conectar Apache Zeppelin a EMR
03:18 min - 32

EMR automatizado con CloudFormation
06:32 min - 33

AWS Lambda para proyectos de big data
07:02 min - 34

Lambdas en big data: real time y batch
04:54 min - 35

Configuración de AWS Lambda para Big Data
07:16 min
Carga de Información


Consumo de información


Seguridad, Orquestación y Automatización


Clase pública

Recursos
Resumen
Pensado para proyectos de big data, API Gateway de AWS actúa como puerta de enlace entre tus fuentes de datos y la nube. Soporta miles y cientos de miles de llamadas recurrentes y ayuda a prevenir ataques de denegación de servicio, habilitando flujos de ingesta que conectan productores como Zendesk, dashboards o IoT con servicios analíticos y de almacenamiento como Kinesis o S3.
¿Qué es API Gateway en big data y por qué importa?
Este servicio funciona como una front door: recibe eventos de múltiples productores y los enruta hacia los servicios adecuados en AWS. Es el intermediario entre “donde está la data” y “donde se procesa” dentro del ecosistema de AWS.
- Soporta grandes volúmenes: miles y cientos de miles de llamadas recurrentes.
- Ayuda a prevenir ataques de denegación de servicio.
- Puede manejar caché para respuestas frecuentes.
- Registra todo en los logs para auditoría y monitoreo.
- Habilita servicios posteriores de cómputo, datos y visualización.
¿Cómo se construye el flujo de datos con API Gateway y Lambda?
Un escenario práctico: un sistema de tickets como Zendesk o GLPI envía casos vía operación put a API Gateway. Este, a su vez, dispara una función Lambda que procesa el evento y lo integra con servicios de datos en AWS.
- Productor de información: plataforma de tickets que genera casos.
- Envío al gateway: operación put hacia API Gateway.
- Orquestación: API Gateway lanza una función Lambda.
- Procesamiento: la función usa Python o cualquier SDK para interactuar con servicios de información.
- Resultado: almacenar, transformar o alimentar una plataforma de visualización como Kibana.
¿Qué servicios puede alimentar la función lambda?
- Kinesis para procesamiento de datos en streaming.
- S3 para almacenamiento de objetos.
- EMR para procesamiento con frameworks de datos.
- Instancias de EC2 para cargas específicas.
- Base de datos no relacional DynamoDB para consultas rápidas.
- Visualización con Kibana como destino del flujo.
¿Qué habilidades y conceptos se aplican en este flujo?
- Diseño de ingesta de información escalable.
- Enrutamiento mediante una puerta de enlace confiable.
- Prevención de denegación de servicio en el borde.
- Orquestación con funciones Lambda.
- Integración con servicios de datos usando SDK y Python.
- Uso de caché y logs para eficiencia y trazabilidad.
¿Qué entradas y salidas admite para extraer información?
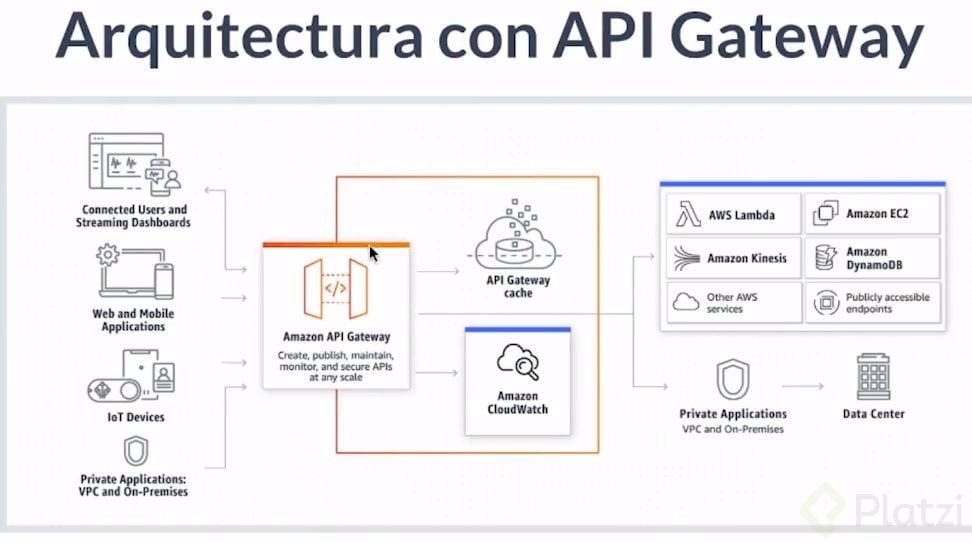
En el “lado izquierdo” se agrupan los productores de información: es decir, todo lo que genera eventos que deben llegar a AWS. En el “lado derecho”, API Gateway despliega o dispara servicios que ejecutan el procesamiento, guardan datos y dejan trazas.
¿Qué productores de información se conectan?
- Dashboards con envío de eventos.
- Aplicaciones móviles con llamadas recurrentes.
- Dispositivos IoT con telemetría.
- Aplicaciones también on-premise que exponen APIs.
¿Qué servicios se disparan y registran?
- Funciones Lambda para lógica sin servidor.
- Instancias EC2 para cómputo administrado.
- Kinesis para procesamiento de datos.
- DynamoDB como base de datos no relacional.
- Manejo de caché para acelerar respuestas.
- Logs completos para seguimiento operativo.
¿Te gustaría comentar un caso de uso o productor específico para mapearlo con API Gateway y Lambda? Comparte tus preguntas o contexto y continuamos la conversación.