Recursos
Resumen
¿Cuánto te cuesta responderle un mensaje a un cliente con inteligencia artificial? La respuesta depende del escalón que elijas, y aquí aprenderás a calcular el costo real de un agente de IA frente a una automatización contando tokens. Es clave para cualquiera que diseñe soluciones de atención automatizada y quiera controlar su factura.
Por qué pagas por tokens y no por mensajes
Los proveedores de modelos de lenguaje no te cobran por cada mensaje enviado, sino por la cantidad de tokens que consumes. Esta es la base para entender todo lo demás.
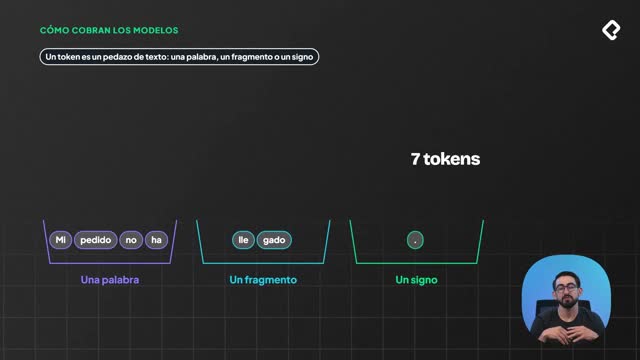
Un token es un pedazo de texto. A veces es una palabra completa, a veces un fragmento de palabra y a veces incluso un signo. La pregunta "¿dónde está mi pedido 4521?" se descompone en varios tokens antes de que el modelo pueda procesarla.
Y aquí viene lo interesante: pagas por dos cosas distintas.
- La entrada, que es todo lo que el modelo lee.
- La salida, que es todo lo que el modelo escribe.
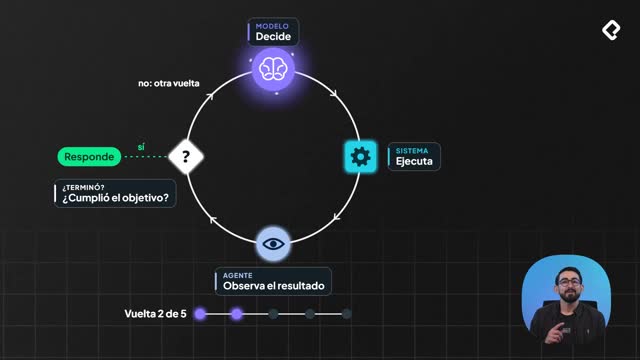
En la entrada no solo va el mensaje del cliente. También van las instrucciones y, si usas un agente, todo el historial de la conversación se reconsidera en cada iteración del bucle de razonamiento.
¿Qué es un token? Es un pedazo de texto que el modelo procesa: puede ser una palabra, un fragmento de palabra o un signo. Los proveedores cobran según cuántos tokens consumes en la entrada y en la salida.
Por qué un agente de IA cuesta más que una automatización
La diferencia de costo entre un agente y una automatización puede ser enorme, y la razón está en cómo cada uno consume tokens [01:40].
En la automatización cognitiva hacemos una sola llamada por correo analizado. Esa llamada para leer el correo consume alrededor de 1.000 tokens. Punto.
El agente funciona distinto. En cada vuelta de razonamiento envía al modelo todo el historial acumulado. Si cada paso agrega 1.000 tokens, la quinta vuelta no procesa 5.000 tokens, procesa 15.000. ¿Por qué? Porque a lo largo de cada iteración fuimos acumulando 1.000 tokens de más.
A esto se le llama ventana de contexto, y crece con cada vuelta que da el agente. Más vueltas, más relectura, más costo.
Cómo contener el consumo con caché
La buena noticia es que existe el caché para contener este gasto [02:40]. El caché es la parte del historial dentro del razonamiento que se repite y que es posible guardar.
El proveedor no vuelve a procesar esa parte repetida, por lo que te la cobra a una fracción del precio y además te responde más rápido. Solo el paso nuevo se paga completo.
¿Qué es el caché en modelos de lenguaje? Es el almacenamiento temporal del historial que se repite en cada iteración del agente. El proveedor no lo reprocesa y te lo cobra a una fracción del precio, acelerando también la respuesta.
Cómo calcular el costo real con el caso de Tienda Andina
Comparemos dos opciones con números redondos para ver la magnitud de la diferencia [03:25].
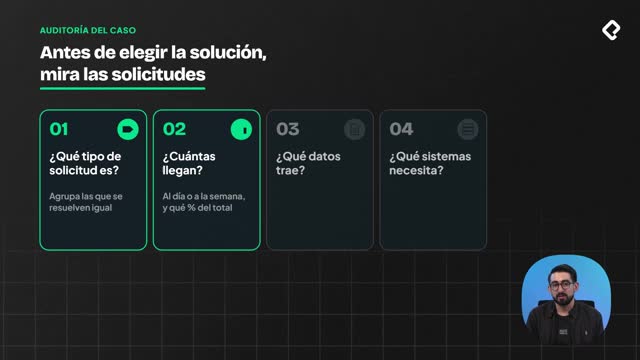
La opción A es la que pedía la gerencia: un agente para todo. Con un volumen de 800 mensajes por día y un consumo de 15.000 tokens por mensaje por las vueltas del agente, llegamos a 12 millones de tokens al día.
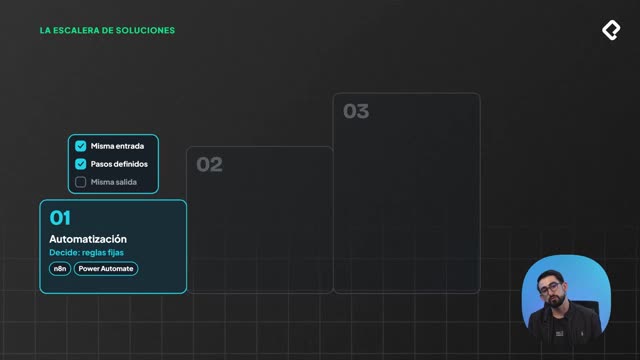
La opción B trata cada tipo de mensaje como un escalón distinto:
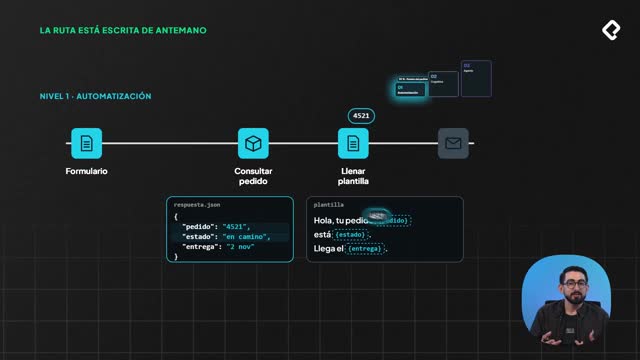
- Mensajes de estado del pedido: no usan inteligencia artificial, consumo de 0 tokens.
- 200 correos interpretados con una sola llamada del modelo: alrededor de 1.000 tokens por mensaje.
- 160 reclamos y reembolsos diarios: estos sí justifican un agente.
Sumando todo, la opción B consume alrededor de 2.6 millones de tokens al día. Eso es 4.6 veces menos que la opción A, y sin contar el caché, ni el mejor tiempo de respuesta, ni los riesgos que evitas al no agregar complejidad.
En los recursos de la clase hay una calculadora en Excel para que hagas este ejercicio con los precios vigentes del proveedor que elijas.
Qué compone la factura además del modelo
El costo no es solamente el modelo. La factura cambia según la solución que selecciones [05:10].
Para la automatización pagas una plataforma y casi nada de infraestructura, lo que hace que el costo sea casi fijo por caso de análisis.
Para la automatización cognitiva sumas el uso del servicio de APIs del modelo, que se cobra por tokens consumidos. El costo por caso se mantiene bajo y predecible, porque con pruebas puedes estimar el consumo con buena precisión.
El agente es otra historia. Necesitas más piezas alrededor del modelo:
- Una plataforma de agentes que garantice observabilidad.
- Infraestructura con manejo de sesiones, memoria y auditoría.
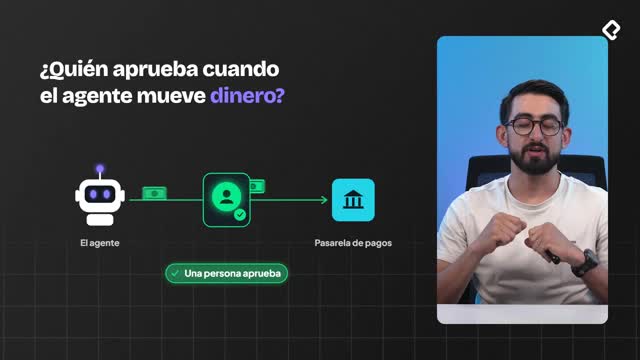
- Aprobación humana y monitoreo.
Si decides desarrollar todo esto por tu cuenta, tendrías que invertir en recurso humano e infraestructura propia. Por eso el modelo suele ser lo más económico del agente. Lo caro es todo lo que hay que construir alrededor para que sea seguro y auditable, lo que convierte al agente en un costo variable y mucho más alto.
Cuáles son las cuatro formas de controlar el costo de un agente
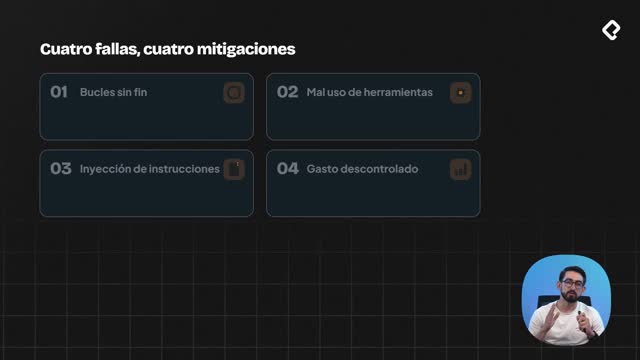
Existen cuatro estrategias para mantener a raya el gasto de un agente [06:50].
- Bajar de escalón: usa el agente solo donde de verdad sea necesario. En Tienda Andina, el 80 % de los mensajes se resolvía con los dos primeros escalones y solo el 20 % restante usaba el agente.
- Poner un tope de vueltas y escalar a una persona cuando se alcanza ese límite.
- Usar caché para no pagar completo el historial que se repite.
- Elegir el modelo justo: para tareas simples como clasificar un correo, un modelo más pequeño y barato suele bastar.
La estrategia más poderosa es la primera, bajar de escalón, porque evita el gasto antes de que ocurra.
¿Cuándo conviene usar un agente de IA? Solo para tareas complejas como reclamos y reembolsos. Para consultas simples, como el estado de un pedido o clasificar correos, una automatización resulta mucho más barata y predecible.
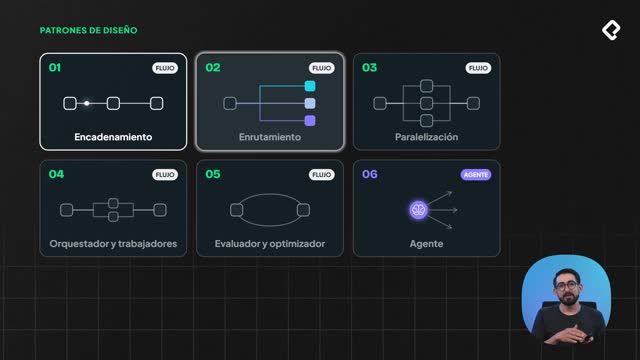
Con esto ya sabes dónde y cómo se justifica un agente dentro de Tienda Andina, y cómo definir la estructura de costos de tu solución. El siguiente paso es diseñar el agente con los patrones de diseño. ¿Qué escalón usarías tú para cada tipo de mensaje? Cuéntame en los comentarios.