Jeff AI es un modelo de lenguaje distinto a los LLM conversacionales, pensado para clasificar información y tomar decisiones con menor latencia y costo. Si trabajas en desarrollo de software y necesitas procesar miles de datos sin gastar de más, esto te interesa.
Por qué Jeff no es un LLM conversacional como GPT
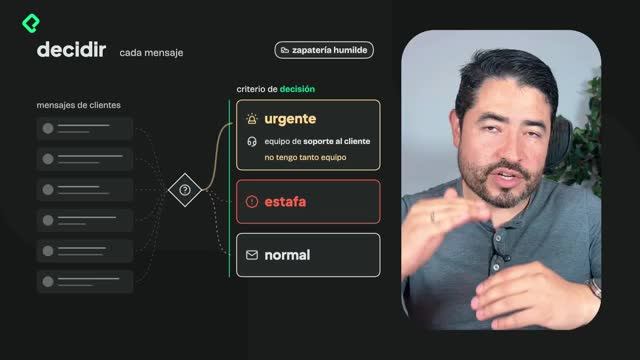
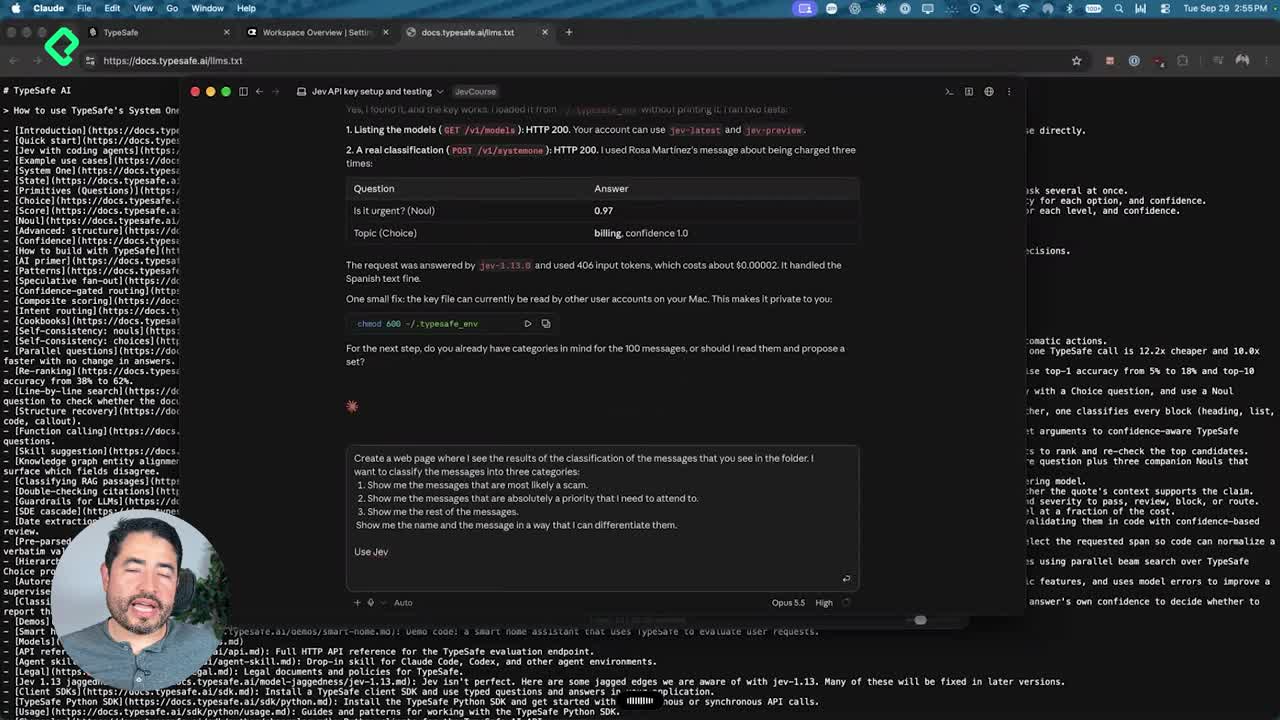
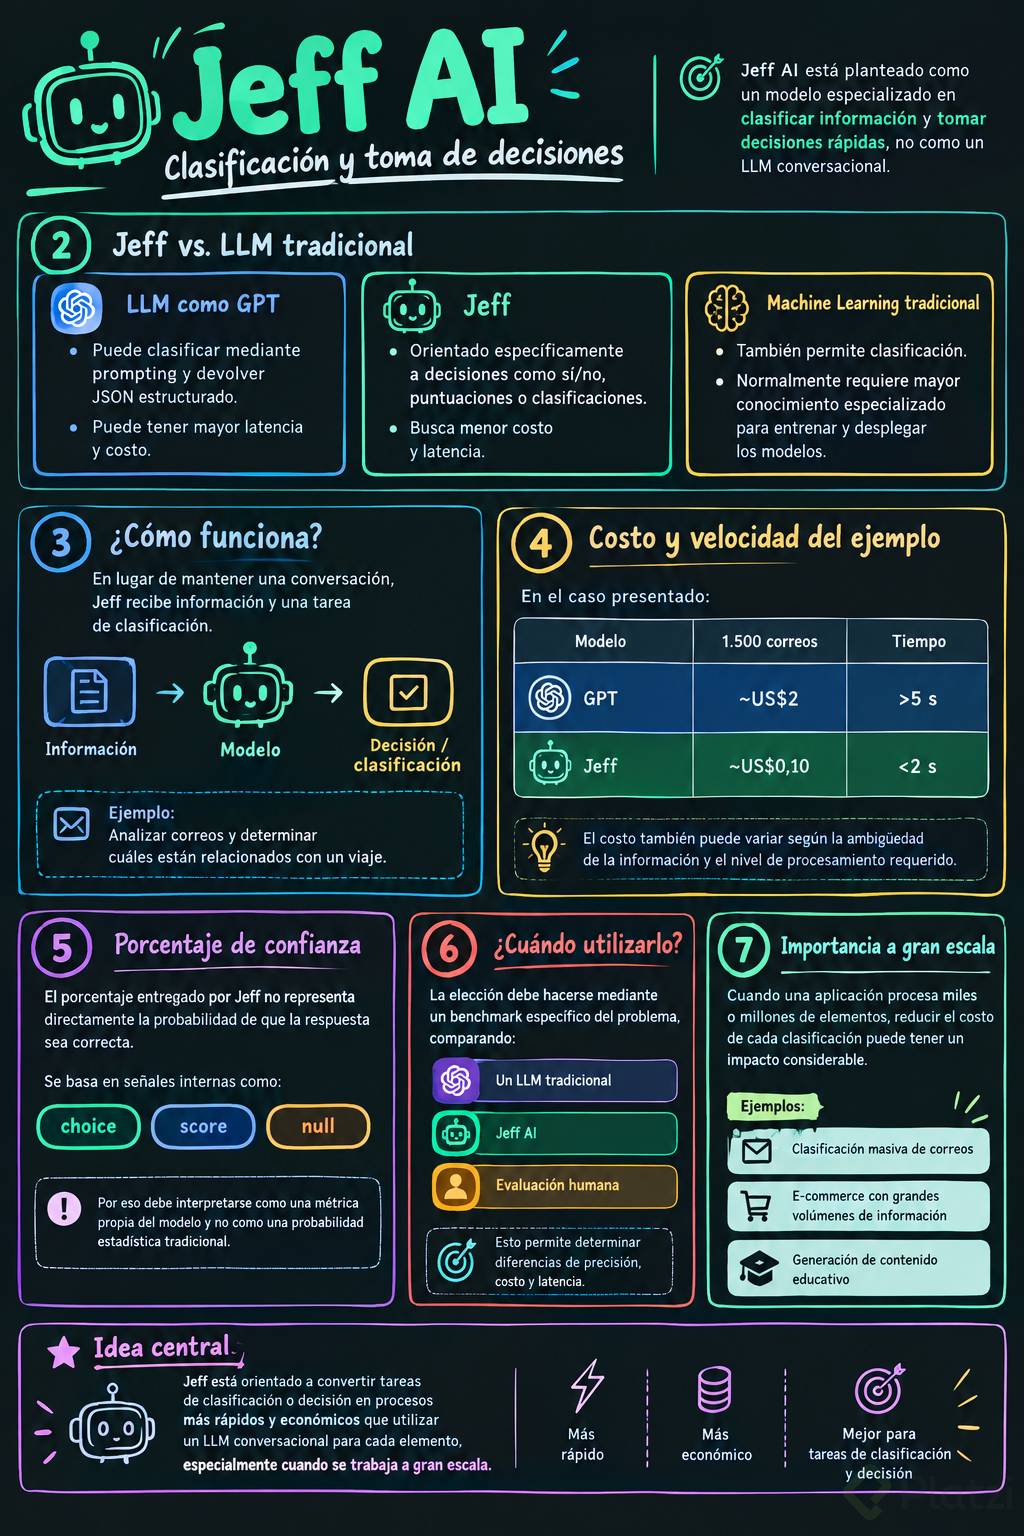
La primera idea que necesitas fijar es que Jeff no funciona como un chat. No le escribes una pregunta para recibir una respuesta en texto y mantener una conversación. Está diseñado para tomar decisiones y clasificar información dentro de distintos buckets.
Antes de que existieran estas soluciones, teníamos dos caminos. El primero eran los modelos de machine learning clásicos, capaces de decidir sí o no, o clasificar entre categorías. Lo ves cada día en Gmail cuando tu correo se separa en promocional, social, update o importante. El problema: la curva de aprendizaje para que un ingeniero construya y ponga operacional uno de esos modelos era muy alta.
El segundo camino fueron los LLM. Con un poco de prompting y programación podías pedirle que clasificara y devolviera un structured output, es decir, un JSON estructurado con la forma esperada de la respuesta. Eso eliminó la curva de aprendizaje, pero abrió otro problema: latencia y costo.
¿Para qué sirve Jeff AI? Para decidir o clasificar información cuya respuesta es probable o absoluta: un sí o no, un puntaje o una rúbrica. No sirve para conversar, sino para tomar decisiones rápidas y baratas.
Cómo Jeff reduce el costo y la latencia frente a un LLM
Aquí viene lo interesante. Jeff llega al mismo punto de partida que un LLM tradicional, pero con una latencia mucho más baja y un costo mucho menor. Esa es su razón de existir.
El ejemplo más claro sale de un proyecto real: un agente de viajes que revisa todos los correos de la bandeja de entrada y decide si cada correo pertenece o no a un viaje. Los números hablan solos:
- Analizar una suite de 1.500 correos con GPT costaba alrededor de 2 dólares.
- La misma cantidad de correos con Jeff costó 0.10 centavos de dólar.
- Un proceso que a GPT le tomaba más de 5 segundos, Jeff lo resolvía en menos de 2 segundos.
Esa diferencia de velocidad no es un detalle técnico: se traduce en una experiencia de usuario mucho más agradable cuando alguien espera una respuesta inmediata. El costo variaba según qué tan ambiguo fuera el correo, porque un mensaje confuso disparaba un proceso de thinking más extenso.
Qué significa el porcentaje de confianza en Jeff
Uno de los conceptos que más cuesta entender es el porcentaje de confianza. Cuando le das dos posibles respuestas, sí o no, o una clasificación, Jeff devuelve un porcentaje. Ese número no es la probabilidad de que sea esa respuesta.
Ese porcentaje es la combinación de tres métricas internas que el modelo maneja por detrás: choice, score o null, dependiendo de lo que le pidas hacer. Por eso resulta tan raro al inicio, sobre todo si vienes acostumbrado a la lógica simple del chat: escribo un mensaje, sale una respuesta.
Con Jeff la mecánica es distinta. Tienes un estado, una pregunta y tres posibles formas de respuesta: un puntaje, un sí o no, o una rúbrica.
¿El porcentaje de confianza de Jeff es una probabilidad? No. Es la combinación de tres señales internas del modelo llamadas choice, score y null, según la tarea. Por eso no debes leerlo como la probabilidad directa de acierto.
Cómo decidir entre un LLM y Jeff
Lo correcto no es asumir cuál es mejor, sino comparar. La recomendación es hacer un benchmark entre tres actores para tu problema específico:
- Un LLM tradicional como GPT.
- Jeff AI.
- El criterio de un humano.
Con esa comparación defines cuál solución encaja mejor. A veces la respuesta más rápida y barata gana, y a veces no. Después de ese contraste, la decisión deja de ser una corazonada.
Por qué reducir el costo en tokens cambia tu producto
Puede que pienses que esto es un complique y que prefieres quedarte con modelos como GPT u Opus. Es válido. Pero lo que Jeff te da es la opción de atacar problemas computacionales complejos en software mucho más barato.
Piensa en la escala. Platzi tiene millones de estudiantes enviando miles de mensajes. Un e-commerce gigante procesa volúmenes enormes de información en muchas categorías. A esa escala, clasificar con un LLM tradicional se vuelve costoso.
¿Cuánto puede costar procesar información con un LLM a gran escala? En el ejemplo, 1.500 correos costaban 2 dólares con GPT frente a 0.10 con Jeff. Multiplica eso por millones de mensajes y el ahorro se vuelve la diferencia entre viable e inviable.
El caso de Hanademy lo aterriza bien. Cada explainer se vende cerca de 9 dólares, y ese costo se acerca mucho al gasto real en tokens. Si se lograra reducir ese costo, se podría ofrecer una suscripción de 20 dólares para crear los explainers que quieras. Hoy no es posible porque el producto es muy complejo, pero esa reducción de costo en tokens es exactamente lo que hace que apostar por Jeff tenga sentido.
¿Tú en qué parte de tu producto gastas más en tokens? Cuéntame en los comentarios qué proceso te gustaría abaratar con una solución de clasificación como esta.