Clasificar miles de mensajes de un chat en vivo y asignarles una calificación automática es posible con modelos de decisión como Jeff frente a modelos de lenguaje como GPT-6 Luna. Si quieres entender cómo funciona la clasificación de texto con inteligencia artificial, por qué un modelo entrenado para decidir es más veloz y barato, y cómo se estructura cada consulta, aquí lo verás con un ejercicio real sobre reseñas de la película Interestelar.
Qué problema resuelve clasificar texto con un modelo de decisión
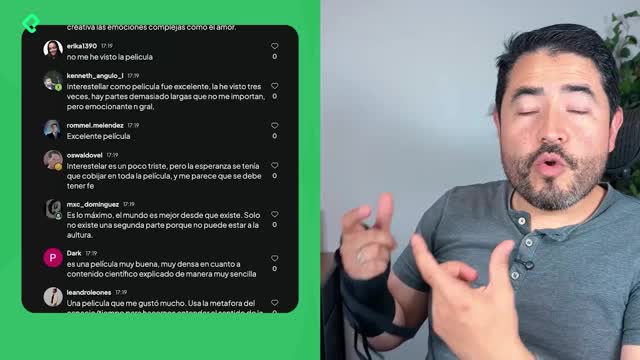
El ejercicio parte de un caso concreto: un chat en vivo de Platzi con 856 mensajes mezclados. Hay saludos, dudas técnicas, comentarios sobre el audio y, entre todo eso, opiniones sobre Interestelar que el host pidió a la audiencia [00:38].
La tarea tiene dos capas. Primero decidir cuáles mensajes son una reseña y cuáles son chat normal. Segundo, tomar esas reseñas y asignarles de una a cinco estrellas para calcular un promedio [01:50].
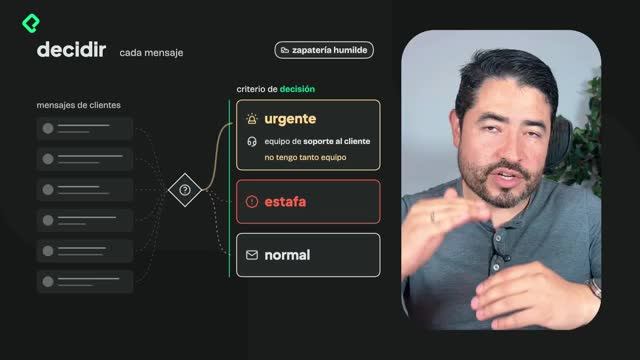
¿Qué es una clasificación de texto con IA? Es pedirle a un modelo que lea un mensaje y lo ordene en categorías, como "es reseña" o "no es reseña". El modelo no conversa: solo toma una decisión basada en un criterio que tú defines.
Aquí aparece una distinción clave. Jeff entiende texto y entiende decisión, pero no genera una respuesta tipo chatbot. Luna, en cambio, es un modelo rápido destilado de los modelos grandes de OpenAI que funciona como un LLM normal, leyendo cada reseña y respondiendo [05:30].
Cómo se le pide la tarea a la IA con un buen prompt
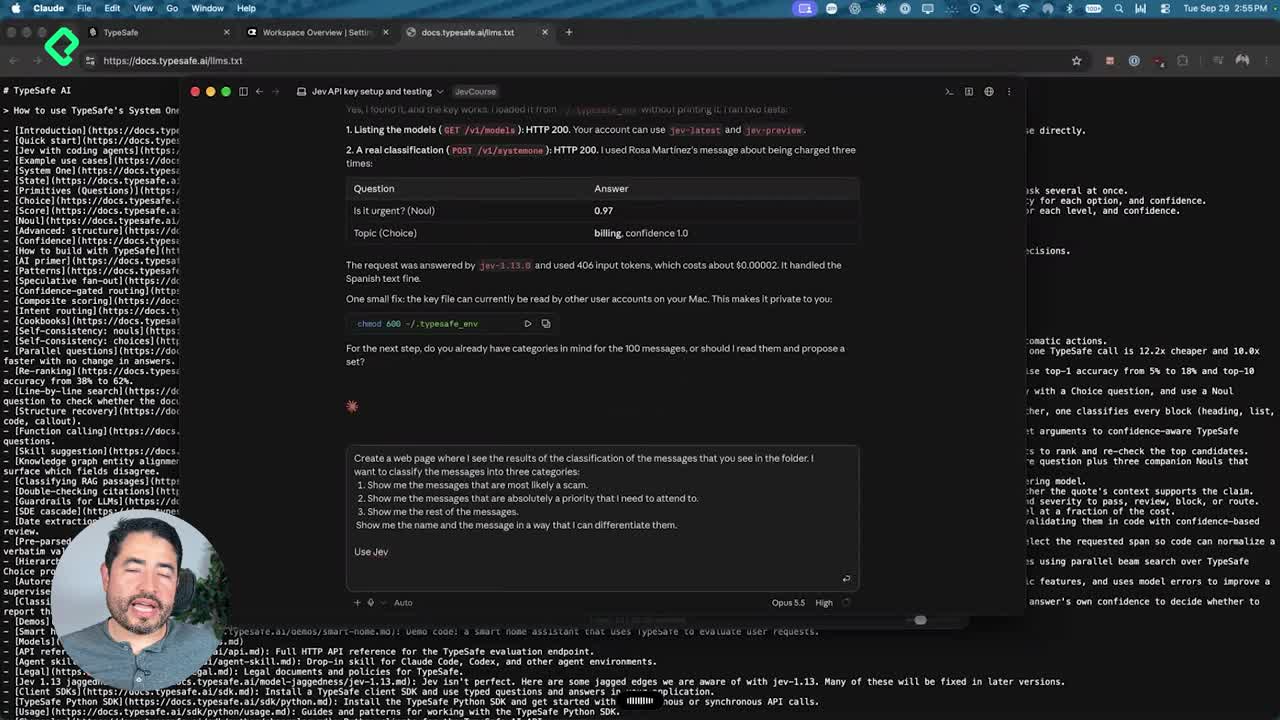
Todo arranca en Cloud Code con una pregunta simple: "Do you see chat.json?" [03:30]. Ese archivo contiene los mensajes exportados en formato JSON, que es JavaScript Object Notation, un formato de transmisión de datos de computación [02:28].
El consejo central es programar paso a paso. Si avanzas con afán, te pierdes de componentes importantes del proceso [03:40].
El prompt principal pide comparar Jeff contra GPT-6 Luna en las dos clasificaciones, generar un archivo HTML con los resultados, y medir el tiempo y el costo de cada decisión. Y termina con una frase que vale oro:
- "Feel free to ask me questions before you start", para que el modelo pregunte antes de ejecutar.
Y aquí viene lo interesante: el sistema sí pregunta. Lo hace en formato de selección múltiple, algo que tienen tanto Claude Code como Codex en ChatGPT [04:50]. Preguntó, por ejemplo, cómo tratar un mensaje que solo nombra la película sin dar opinión. La respuesta fue clara: nombrar la película como dato de la trama no cuenta como reseña [05:10].
Por qué Jeff gana en velocidad y costo frente a Luna
Los resultados muestran la verdadera diferencia entre un modelo de decisión y un LLM. En promedio de estrellas, los tres modelos quedaron cerca: Jeff dio 4.94, Luna sin razonamiento 4.04 y Luna con razonamiento medio 4.13 [07:40].
La magia está en la eficiencia. Para la primera clasificación de 856 decisiones:
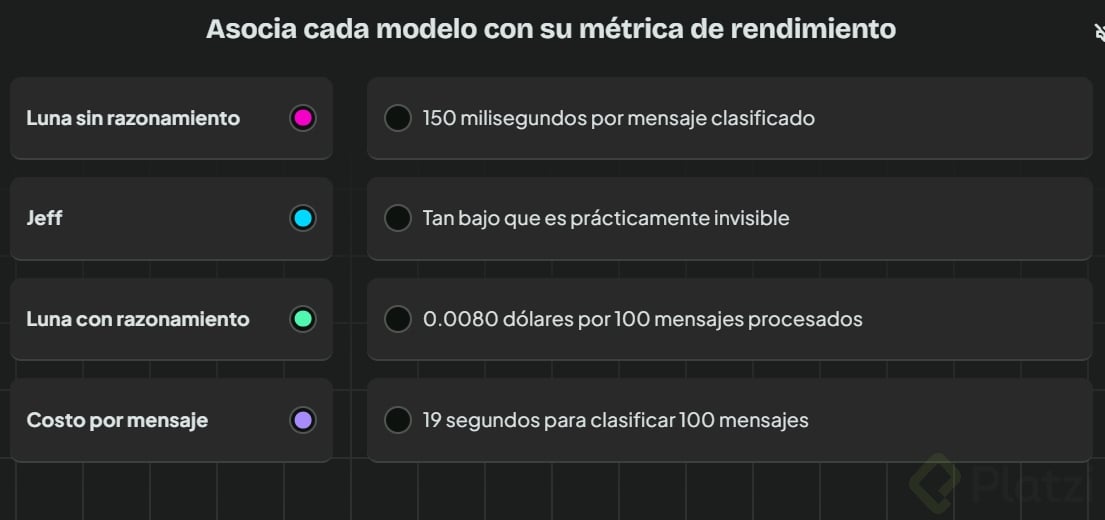
- Jeff tardó 143 milisegundos por decisión, 12.3 segundos en total, con un costo de 0.01 dólares.
- Luna sin razonamiento tardó cerca de un segundo por decisión, poco más de un minuto en total, por 0.03 dólares.
- Luna con razonamiento medio tardó casi dos minutos en total, por 0.05 dólares.
En la segunda decisión, la de cuántas estrellas, Jeff resolvió todo en 2.4 segundos frente a los 30 segundos de Luna intermedio [09:30]. En gran total, Jeff terminó en 14.5 segundos y Luna medio en más de dos minutos, con un costo hasta 2.7 veces mayor [09:50].
¿Por qué un modelo de decisión es más barato que un LLM? Porque fue entrenado específicamente para elegir entre opciones, no para redactar respuestas. Al generar menos texto, consume menos recursos y responde en milisegundos en lugar de segundos.
Piensa en escalar esto al chat de un influencer de Twitch con 100,000 viewers simultáneos para detectar a los fans más fieles. Esa diferencia de velocidad y precio se vuelve enorme [10:10].
Cómo decide la IA cuántas estrellas dar sin alucinar
Surgió una duda honesta en el chat: ¿cómo rankea Jeff de una a cinco estrellas sin reglas explícitas? ¿No estaría alucinando? [05:00].
No. Una alucinación es una respuesta incorrecta que no existe. Jeff fue entrenado con billones de decisiones estructuradas en su red neuronal, igual que los modelos grandes de lenguaje predicen la letra más probable tras otra letra [05:15]. Por eso toma decisiones coherentes sobre texto.
En los ejemplos reales se ve el matiz. Una reseña como "muy buena, da a pensar sobre nuestro futuro" recibió cinco estrellas de Jeff y cuatro de ambos Lunas. Otra, "me gusta más Roma", no es reseña de Interestelar sino una comparación, y los modelos difirieron en cómo tratarla [10:40].
Cómo se estructura la consulta: decisión booleana vs rúbrica
Al final del ejercicio se revela cómo Cloud Code arma cada consulta para Jeff, y aquí está la diferencia entre los dos tipos de clasificación [11:30].
La primera decisión es de tipo bool: verdadero o falso. Cloud Code crea un estado con el mensaje del usuario, define el modelo y escribe el criterio. Le explica a Jeff el contexto de la clase y pregunta si el mensaje es la opinión de alguien sobre Interestelar, incluyendo ejemplos de qué cuenta como verdadero ("loved it", "boring") y qué es falso (saludos, preguntas) [12:00].
La segunda decisión es de tipo score. Reenvía el mismo mensaje para compartir contexto y pide cuántas estrellas, de uno a cinco, da esa opinión. Define cada nivel: una estrella es muy negativo, cinco es entusiasta [12:40].
Con Luna, en cambio, la estructura es la de un LLM clásico. Se manda un system prompt con la configuración y un user prompt con el mensaje, pidiendo la respuesta en formato JSON, donde cero significa que no es reseña y uno que sí [13:20].
Esa es la base: un modelo de decisión usa criterios tipo bool o score, mientras que un LLM necesita rol, mensaje y respuesta probable. El resto fue carpintería de código en Python para construir el reporte [14:00].
¿Qué caso de clasificación masiva se te ocurre probar primero? Cuéntalo en los comentarios.