Clasificar 300 respuestas de una encuesta con IA en minutos es posible si usas un modelo rápido de decisiones como Jeff y lo comparas contra GPT 6 Luna. Esta práctica muestra, paso a paso, cómo construir un sistema que rankea perfiles y sugiere conexiones entre personas, usando solo datos del dataset. Ideal para quien quiere entender clasificación con modelos de IA en casos reales.
Qué datos usamos para construir el clasificador
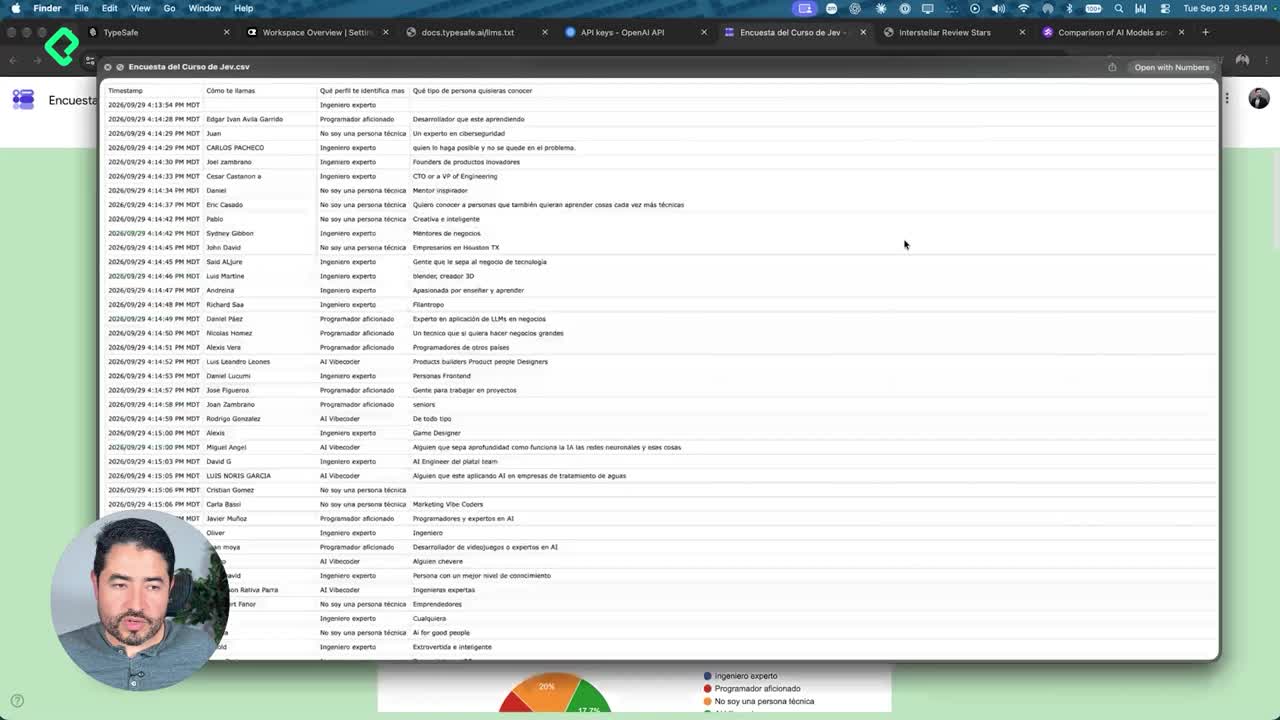
Todo arranca con una encuesta en vivo que respondieron estudiantes de Platzi. Las preguntas definían quién era cada persona: nombre, perfil que lo identifica (ingeniero experto, programador aficionado, persona técnica o AI Vibe Coder), qué tipo de persona quiere conocer, ciudad y país, edad y curso favorito de Platzi.
Las respuestas se descargaron como un archivo CSV, es decir, un archivo separado por comas, parecido a un Excel. El número creció en tiempo real: empezó en 299, pasó a 304 y el sistema terminó procesando 302 respuestas válidas en un archivo de 45 kilobytes [00:48].
¿Qué es un archivo CSV? Es un archivo de texto donde cada dato se separa por comas. Funciona como una tabla de Excel y es el formato estándar para exportar respuestas de Google Forms.
El archivo se renombró a encuesta.csv y se colocó en la carpeta del proyecto llamada Jeff Course, para que Cloud Code pudiera leerlo directamente [02:33].
Cómo se le pide a la IA que recomiende conexiones
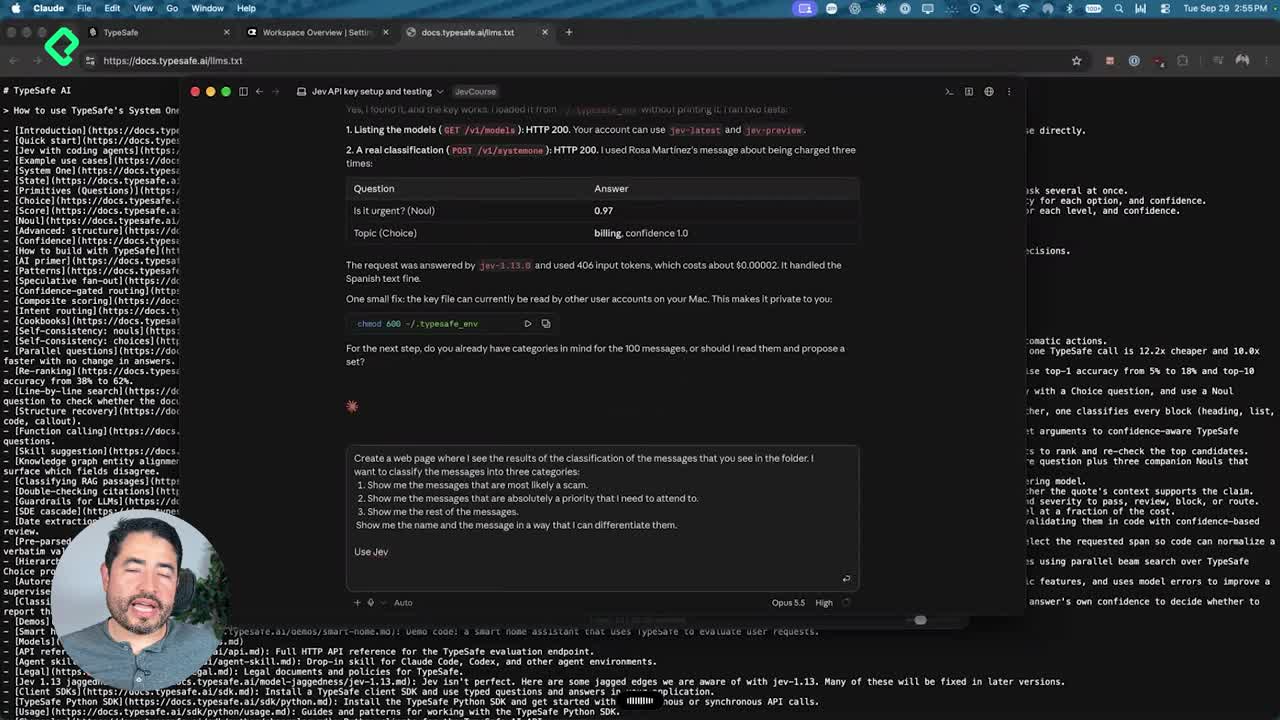
El objetivo del prompt fue claro: crear un sistema que recomiende, a cada estudiante, otra persona con quien debería conectar. Como conocemos tanto de cada usuario (su perfil, a quién quiere conocer, dónde vive, su edad y su curso favorito), el modelo tiene material suficiente para decidir.
El encargo tuvo dos partes:
- Rankear a las cinco personas más interesantes de la base de datos.
- Mostrar, por cada persona, las tres personas más importantes que debería conocer, con algunos datos de cada una.
Un detalle de método: promptear en inglés da mejores resultados, por eso toda la instrucción se escribió en ese idioma [03:40]. Además se pidió un formato simple en HTML5, porque herramientas como Cloud Code y Codex a veces generan diseños excesivamente cargados [05:34].
¿Qué es hacer steering en un prompt? Es inyectar texto adicional mientras el modelo está construyendo la respuesta, para guiar la ejecución sin empezar de cero. Se activa enviando el mensaje con el botón Send now.
Antes de ejecutar, el modelo hizo exactamente cuatro preguntas. Esto no es casualidad: los modelos de Anthropic, por su proceso de RLHF (aprendizaje por refuerzo con retroalimentación humana), tienden a limitarse a cuatro preguntas de aclaración [07:35].
Por qué comparar cada par genera 45,000 decisiones
Aquí aparece lo interesante. Para encontrar las mejores conexiones, el sistema no compara al azar: compara a cada persona contra todas las demás. Con 302 respuestas, eso produce decenas de miles de pares.
La cifra final fue de 45,753 comparaciones entre las 300 personas [15:19]. Jeff juzgó todos los pares directos, mientras que para Luna se usó un ranking por persona porque hacer todos los pares resultaba demasiado costoso.
Algunas decisiones de diseño que definieron el resultado:
- El lugar donde vive cada persona solo se usó como tiebreaker, es decir, para romper empates.
- Las filas en blanco se mantuvieron a propósito, para ver qué pasaba.
- Cada perfil recibió un puntaje del uno al cinco.
La verificación final del reporte la hizo Opus 5.5 High, descrito como un modelo de frontera, el más inteligente al momento de grabar, capaz de revisar las decisiones con mayor objetividad [11:35].
Qué resultados dio Jeff frente a Luna
Los números cuentan la historia. Jeff fue cuatro veces más rápido y dos veces más barato que Luna, aun leyendo muchos más tokens [16:12].
Comparativa directa de la ejecución:
- Tiempo: Jeff tardó 5.6 minutos; Luna, sin razonamiento, tardó 24 minutos.
- Velocidad por decisión: Jeff a 0.1 segundos; Luna a un segundo entero.
- Tokens de Jeff: 45.1 millones de entrada y 1.55 millones de salida, con costo de 1.89 dólares.
- Tokens de Luna: 35.2 millones de entrada y 0.87 millones de salida, con costo de 4 dólares.
La clave del ahorro es que Jeff solo cobra por los tokens de entrada, no por los de salida. Por eso puede leer mucho más y seguir costando menos.
En calidad, ambos coincidieron en tres de las cinco personas más interesantes: Rodrigo Torres, Odiel Velandia y John P. Curiosamente, Rodrigo Torres destacó porque respondió con IA, con el típico AI slope reconocible por esa flechita de vibe coding [17:40]. En cambio, al sugerir conexiones concretas entre personas, los modelos coincidieron mucho menos de lo esperado.
También aparecieron casos divertidos que estresaron el sistema: un perfil de 80 años que quería conocer supervillanos, nombres famosos como Jensen Huang, Daria Moraes y Sundar Pichai, e incluso una fila con inyección de prompt que recibió un puntaje bajo de 35 [12:40].
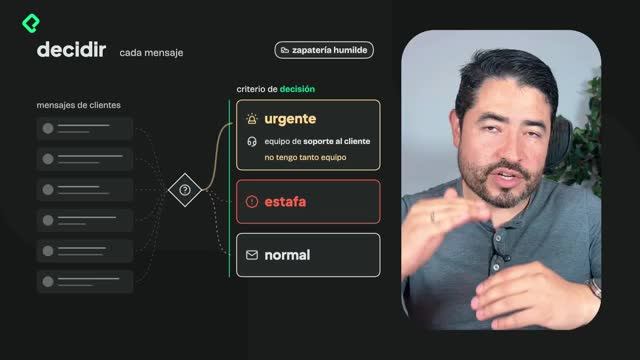
¿Por qué un modelo clasificador es más rápido? Porque cuando las preguntas tienen formato de decisión, el modelo da una respuesta directa sin generar texto largo. Eso reduce drásticamente tiempo y costo por consulta.
El entregable final fue un reporte en HTML que, para cada persona, lista con quién debería conectar. Por ejemplo, Edgar Ivan Avila con Oscar, Raul, Daniel, Michel y David Moreno; o Said Aljure con Miguel, Carlos, Mario, Raziel, Gerardo y Dario [18:40].
Ahora te toca a ti: toma este mismo clasificador, ponlo a trabajar con otro dataset y compáralo con modelos más potentes como Haiku, Sonnet 5.5 o Astra. ¿Qué otra cosa increíble se te ocurre clasificar? Cuéntalo en los comentarios.