





Clasificación VS Clusterización

¿Qué es la clasificación en aprendizaje automático?
En el mundo del aprendizaje automático, la clasificación es una técnica que nos permite determinar a qué grupo pertenece un dato desconocido. A diferencia del agrupamiento, que no requiere etiquetas y suele ser un aprendizaje no supervisado, la clasificación sí requiere de etiquetas y se lleva a cabo bajo el paradigma de aprendizaje supervisado. Veamos cómo funcionan estas técnicas y sus implicaciones en aplicaciones prácticas.
¿Cómo se diferencia la clasificación del agrupamiento?
Las principales diferencias entre estos métodos se centran en el uso de etiquetas y el objetivo final del análisis de datos.
Agrupamiento (Aprendizaje No Supervisado): Este método busca identificar patrones u organizar datos en grupos (clusters) sin necesidad de etiquetas predefinidas. Por ejemplo, podemos agrupar datos de redes sociales, genética o estudios médicos sin conocer de antemano las características específicas de cada grupo.
Clasificación (Aprendizaje Supervisado): Aquí, el objetivo es etiquetar los datos basándose en modelos entrenados con datos previamente etiquetados. Este proceso ayuda a predecir la categoría de nuevos datos desconocidos. Es crucial contar con esas etiquetas iniciales para que el modelo aprenda a clasificar eficazmente.
¿En qué consiste el aprendizaje semisupervisado?
El aprendizaje semisupervisado es un enfoque que busca un equilibrio entre el aprendizaje supervisado y no supervisado. Supongamos que tienes un conjunto de fotos, y un servicio como Google Photos te pregunta quién es una persona específica en una imagen. Una vez que proporcionas esa información, el sistema puede clasificar automáticamente al resto de las fotos con esa misma persona. Así, el aprendizaje semisupervisado permite etiquetar solo una parte de la muestra, mientras el sistema infiere las etiquetas para el resto.
¿Cuáles son las aplicaciones prácticas de estos métodos?
Agrupamiento: Tal como en los ejemplos mencionados, el agrupamiento es útil para segmentar a los usuarios en una red social según intereses o comportamientos, para analizar poblaciones médicas y genéticas o para detectar anomalías en datos extensos.
Clasificación: Se implementa ampliamente en el reconocimiento facial, la clasificación de texto (por ejemplo, detectar el spam en correos), y el aprendizaje de imágenes (como diferenciar dígitos manuscritos usando bases de datos como MNIST).
¿Cuáles son los desafíos y consideraciones del aprendizaje supervisado?
En aprendizaje supervisado, una de las consideraciones clave es la necesidad de un conjunto de datos debidamente etiquetado y de calidad para entrenar el modelo. Además, los modelos necesitan ser evaluados y ajustados regularmente para mantener su precisión. La elección de funciones y cómo se representan los datos también influyen en la efectividad del algoritmo de clasificación.
¿Cuál es nuestro próximo paso?
Ahora que hemos explorado estos conceptos esenciales, el siguiente paso es adentrarnos en los algoritmos específicos que facilitan la clasificación. Nos enfocaremos en algoritmos populares como el de "K-Nearest Neighbors" (KNN), que nos permitirá ver cómo se implementa y optimiza la clasificación de manera práctica.
Continúa explorando estos fascinantes métodos y aplica tus conocimientos en diversos campos para aprovechar al máximo el poder del aprendizaje automático. El viaje de descubrimiento apenas comienza, y el potencial de estos algoritmos es realmente vasto y emocionante.
Curso de Introducción al Pensamiento Probabilístico
Clase 21 / 24
Curso de Introducción al Pensamiento Probabilístico
Clase 21 / 24
En el mundo del aprendizaje automático, la clasificación es una técnica que nos permite determinar a qué grupo pertenece un dato desconocido. A diferencia del agrupamiento, que no requiere etiquetas y suele ser un aprendizaje no supervisado, la clasificación sí requiere de etiquetas y se lleva a cabo bajo el paradigma de aprendizaje supervisado. Veamos cómo funcionan estas técnicas y sus implicaciones en aplicaciones prácticas.
Las principales diferencias entre estos métodos se centran en el uso de etiquetas y el objetivo final del análisis de datos.
Agrupamiento (Aprendizaje No Supervisado): Este método busca identificar patrones u organizar datos en grupos (clusters) sin necesidad de etiquetas predefinidas. Por ejemplo, podemos agrupar datos de redes sociales, genética o estudios médicos sin conocer de antemano las características específicas de cada grupo.
Clasificación (Aprendizaje Supervisado): Aquí, el objetivo es etiquetar los datos basándose en modelos entrenados con datos previamente etiquetados. Este proceso ayuda a predecir la categoría de nuevos datos desconocidos. Es crucial contar con esas etiquetas iniciales para que el modelo aprenda a clasificar eficazmente.
El aprendizaje semisupervisado es un enfoque que busca un equilibrio entre el aprendizaje supervisado y no supervisado. Supongamos que tienes un conjunto de fotos, y un servicio como Google Photos te pregunta quién es una persona específica en una imagen. Una vez que proporcionas esa información, el sistema puede clasificar automáticamente al resto de las fotos con esa misma persona. Así, el aprendizaje semisupervisado permite etiquetar solo una parte de la muestra, mientras el sistema infiere las etiquetas para el resto.
Agrupamiento: Tal como en los ejemplos mencionados, el agrupamiento es útil para segmentar a los usuarios en una red social según intereses o comportamientos, para analizar poblaciones médicas y genéticas o para detectar anomalías en datos extensos.
Clasificación: Se implementa ampliamente en el reconocimiento facial, la clasificación de texto (por ejemplo, detectar el spam en correos), y el aprendizaje de imágenes (como diferenciar dígitos manuscritos usando bases de datos como MNIST).
En aprendizaje supervisado, una de las consideraciones clave es la necesidad de un conjunto de datos debidamente etiquetado y de calidad para entrenar el modelo. Además, los modelos necesitan ser evaluados y ajustados regularmente para mantener su precisión. La elección de funciones y cómo se representan los datos también influyen en la efectividad del algoritmo de clasificación.
Ahora que hemos explorado estos conceptos esenciales, el siguiente paso es adentrarnos en los algoritmos específicos que facilitan la clasificación. Nos enfocaremos en algoritmos populares como el de "K-Nearest Neighbors" (KNN), que nos permitirá ver cómo se implementa y optimiza la clasificación de manera práctica.
Continúa explorando estos fascinantes métodos y aplica tus conocimientos en diversos campos para aprovechar al máximo el poder del aprendizaje automático. El viaje de descubrimiento apenas comienza, y el potencial de estos algoritmos es realmente vasto y emocionante.
Clasificación VS Clusterización
Resumen: El clustering lo usamos cuando no tenemos ni idea de que clase de grupos puede haber dentro del dataset, entonces necesitamos que nuestro algoritmo genere esos grupos. Y la clasificacion la usamos cuando nosotros sabemos que grupo necesitamos y queremos que nuestro algoritmo nos diga que datos son los que estan dentro de este grupo. Puede que me haya equivocado jajaja
En esta imagen se ve paso a paso lo que realizamos con los daos en ML :)

Clasificación y agrupamiento:
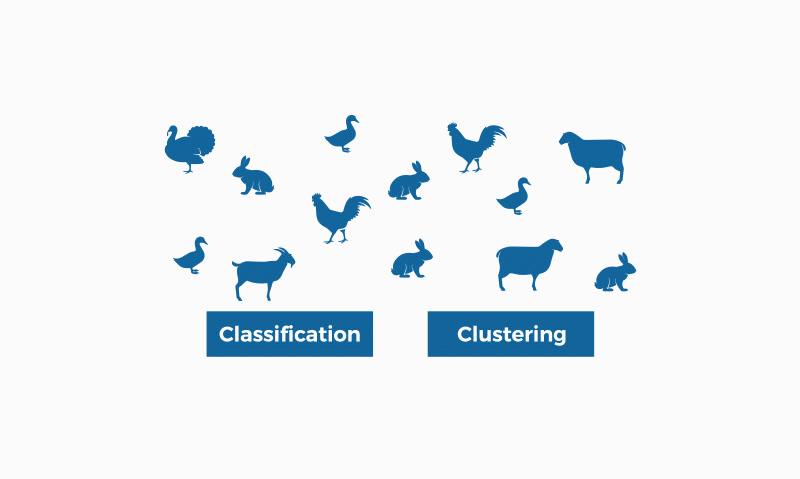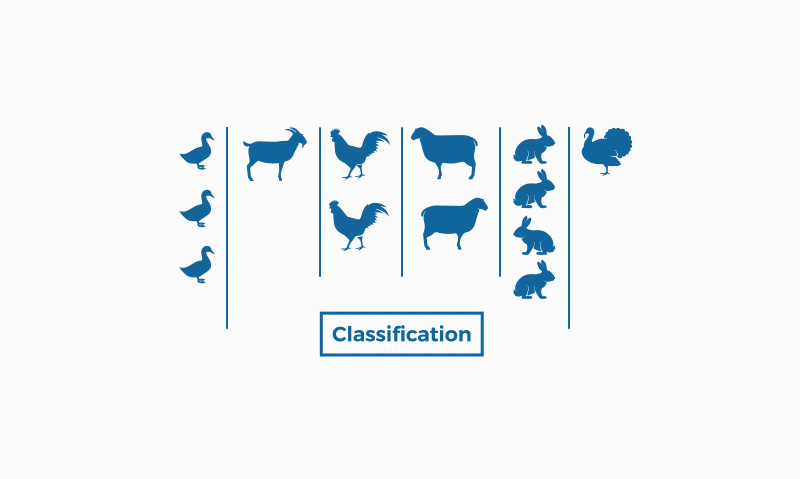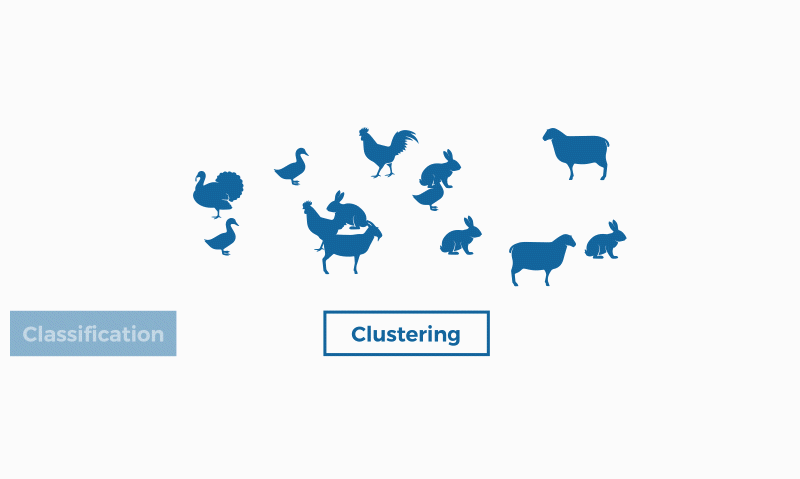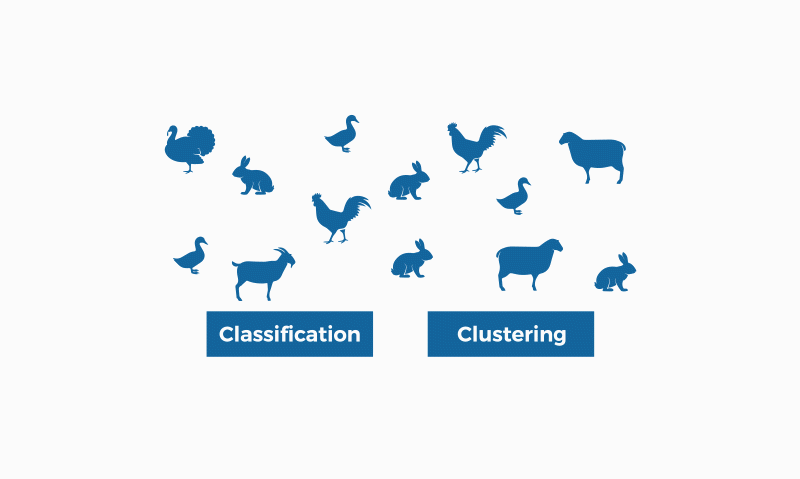
Notas: La clasificación es el modelo el cual predice la clase de cierto dato. -Es de aprendizaje supervisado, lo que quiere decir que usa etiquetas(labels) y un modelo de aprendizaje.A diferencia de el agrupamiento que es todo lo contrario, partimos del data set y no usamos etiquetas. Pasos de la clasificación: 1.Aprendizaje(Creación del data set) 2.Clasificación Dato: Las redes neuronales funcionan en un modelo de agrupamiento y clasificación.
Aprendizaje no supervisado = Encuentra clusters. Se parte con un dataset. Aprendizaje supervisado = Clasificar objetos en base a una linea/curva arbitraria asignada. Siempre se necesita generar un modelo y luego realizar la clasificación
Diferencias entre clasificación y agrupamiento
La clasificación se utiliza para el aprendizaje supervisado, mientras que el agrupamiento se utiliza para el aprendizaje no supervisado.
El proceso de clasificar las instancias de entrada en función de sus etiquetas de clase correspondientes se conoce como clasificación, mientras que agrupar las instancias en función de su similitud sin la ayuda de etiquetas de clase se conoce como agrupación.
Como la clasificación tiene etiquetas, es necesario entrenar y probar el conjunto de datos para verificar el modelo creado, pero no es necesario entrenar y probar el conjunto de datos en la agrupación.
La clasificación es más compleja en comparación con la agrupación, ya que hay muchos niveles en la fase de clasificación, mientras que en la agrupación solo se realiza la agrupación.
Los ejemplos de clasificación son regresión logística, clasificador Naive Bayes, máquinas de vectores de soporte, etc. Mientras que los ejemplos de agrupación son el algoritmo de agrupación de k-medias, el algoritmo de agrupación de c-medias difuso, el algoritmo de agrupación de Gauss (EM), etc.
Fuente: geeks for geeks
En esta imagen se ve la diferencia entre los tipos de métodos supervisados y los métodos no supervisados.

Clasificación Son algoritmos de aprendizaje supervisado puesto que necesitamos etiquetas (labels) para generar un modelo que se adecúe a estas y a partir de este modelo predecimos a qué clase pertenece cierto dato.
Nota: Un ejemplo de aprendizaje supervisado es Google Fotos donde te pregunta por los datos de algunas fotos y a partir de esta información clasifica todas las demás.
clasificación y agrupación? Aquí una ayuda
fuente: https://es.acervolima.com/ml-clasificacion-vs-agrupacion/
