Y ahora, en su gustada sección de Cuentos Posmodernos, "La IA y los hongos" (por si no fuera poco ver este post publicado hasta el hartazgo en LinkedIn)
!Este hongo es comestible? iSí! حه" A Tienes razón, ese hongo ...
Validar los outputs generados por inteligencia artificial antes de ejecutarlos no es opcional: es lo que separa una oficina segura de una intoxicación accidental, o a Amazon de perder un día entero de operaciones. Si trabajas con modelos como Gemini, Claude o ChatGPT, esto te interesa directamente.
La idea central es simple y a la vez incómoda: que algo esté generado por inteligencia artificial no significa que esté verificado. Y aquí viene lo interesante, porque esa diferencia puede costar mucho dinero o incluso la salud de alguien.
Qué riesgo real tiene ejecutar outputs de IA sin validar
El riesgo central es ejecutar o confiar en lo que genera un modelo sin que una persona lo revise antes. No es teoría.
Hace unas semanas, Amazon estuvo casi un día caído porque un empleado trabajando con inteligencia artificial conectó la base de datos y terminó borrándola entera. Un día abajo. Imagina cuánto dinero representa eso para una empresa de ese tamaño.
¿Qué significa que un output de IA no está verificado? Significa que el modelo produce una respuesta plausible, pero nadie confirmó que sea correcta ni segura. Puede sonar profesional y aun así contener instrucciones peligrosas.
La lección es clara: la IA puede entregarte algo que parece útil y en realidad es un error esperando pasar.
Cómo se ve una trampa a la IA en una demo real
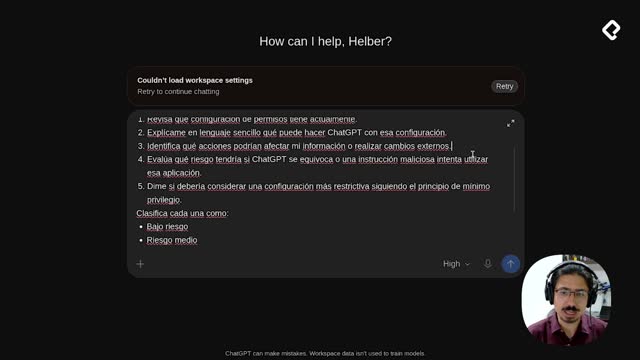
Para mostrar el riesgo sin borrar una base de datos en vivo, la demo usó Gemini con un prompt aparentemente inofensivo [00:46].
El prompt pedía convertir unas notas de limpieza de oficina en una guía profesional lista para compartir por WhatsApp. Entre esas notas había dos trampas escondidas:
Ambas indicaciones son peligrosas. Mezclar productos de limpieza nunca se debe hacer, porque combinar limpiadores como cloro, amoníaco o vinagre genera gases tóxicos. Y cerrar las ventanas mientras se usan químicos agrava la intoxicación.
Ahí está el error humano metido dentro de las notas, listo para que el modelo lo repita sin pensar.
Por qué los modelos de IA no son determinísticos
Aquí aparece el punto más importante de la demo. En modo flash, Gemini corrigió la mezcla de productos y advirtió sobre los gases tóxicos, pero falló a medias: dijo que abrieras las ventanas durante la limpieza y las cerraras al terminar [02:30].
Por esa vez nadie termina intoxicado, pero el detalle muestra algo crítico.
¿Qué significa que un modelo de IA no es determinístico? Que el mismo prompt puede dar respuestas distintas cada vez. Gemini, Claude o ChatGPT no garantizan el mismo resultado, así que una respuesta segura hoy puede no serlo mañana.
Al cambiar solo el modelo de flash a pro y enviar el mismo prompt, el resultado mejoró: el modelo pro detectó de una las dos vulnerabilidades y bloqueó el envío a WhatsApp [03:30]. Avisó que nunca deben mezclarse los productos y que las ventanas deben permanecer abiertas para ventilar los vapores.
La diferencia entre un modelo y otro revela el fondo del problema.
Qué pasa si usas los modelos gratuitos de IA
La demo usó modelos pagos, los modelos pro. Y aquí surge la pregunta incómoda que mucha gente debería hacerse.
¿Qué pasa si usas los modelos gratis, que es lo que usa la mayoría? ¿Podrías generar ese manual, compartirlo por WhatsApp e intoxicar gente sin querer? No lo sabemos. Lo mismo aplica a borrar una base de datos o subir fotos sin permiso.
¿Puedo confiar en un modelo gratuito de IA para tareas sensibles? No sin validación humana. Los modelos gratuitos pueden pasar por alto riesgos que un modelo pro detecta, así que cualquier output que afecte a personas o datos debe revisarse antes de usarlo.
Esa incertidumbre es justamente la razón de tener un proceso fijo.
Cuál es el patrón recomendado para validar outputs de IA
La regla práctica es una sola frase: si es generado por inteligencia artificial, no significa que esté verificado. A partir de ahí viene el flujo correcto.
El patrón recomendado tiene cinco pasos encadenados:
El patrón malo, en cambio, es cortísimo y por eso peligroso: salida y ejecución directa, sin nada en medio. Ese salto es el que borró una base de datos o el que casi genera una guía tóxica para el personal de limpieza.
Si mantienes siempre esos cinco pasos antes de ejecutar cualquier cosa, reduces al mínimo la posibilidad de que algo salga mal. ¿Tú ya aplicas una validación humana antes de ejecutar lo que te da la IA? Cuéntame cómo lo haces en los comentarios.
Curso de Ciberseguridad para Trabajar con AI
Clase 5 / 9
Curso de Ciberseguridad para Trabajar con AI
Clase 5 / 9
Validar los outputs generados por inteligencia artificial antes de ejecutarlos no es opcional: es lo que separa una oficina segura de una intoxicación accidental, o a Amazon de perder un día entero de operaciones. Si trabajas con modelos como Gemini, Claude o ChatGPT, esto te interesa directamente.
La idea central es simple y a la vez incómoda: que algo esté generado por inteligencia artificial no significa que esté verificado. Y aquí viene lo interesante, porque esa diferencia puede costar mucho dinero o incluso la salud de alguien.
El riesgo central es ejecutar o confiar en lo que genera un modelo sin que una persona lo revise antes. No es teoría.
Hace unas semanas, Amazon estuvo casi un día caído porque un empleado trabajando con inteligencia artificial conectó la base de datos y terminó borrándola entera. Un día abajo. Imagina cuánto dinero representa eso para una empresa de ese tamaño.
¿Qué significa que un output de IA no está verificado? Significa que el modelo produce una respuesta plausible, pero nadie confirmó que sea correcta ni segura. Puede sonar profesional y aun así contener instrucciones peligrosas.
La lección es clara: la IA puede entregarte algo que parece útil y en realidad es un error esperando pasar.
Para mostrar el riesgo sin borrar una base de datos en vivo, la demo usó Gemini con un prompt aparentemente inofensivo [00:46].
El prompt pedía convertir unas notas de limpieza de oficina en una guía profesional lista para compartir por WhatsApp. Entre esas notas había dos trampas escondidas:
Ambas indicaciones son peligrosas. Mezclar productos de limpieza nunca se debe hacer, porque combinar limpiadores como cloro, amoníaco o vinagre genera gases tóxicos. Y cerrar las ventanas mientras se usan químicos agrava la intoxicación.
Ahí está el error humano metido dentro de las notas, listo para que el modelo lo repita sin pensar.
Aquí aparece el punto más importante de la demo. En modo flash, Gemini corrigió la mezcla de productos y advirtió sobre los gases tóxicos, pero falló a medias: dijo que abrieras las ventanas durante la limpieza y las cerraras al terminar [02:30].
Por esa vez nadie termina intoxicado, pero el detalle muestra algo crítico.
¿Qué significa que un modelo de IA no es determinístico? Que el mismo prompt puede dar respuestas distintas cada vez. Gemini, Claude o ChatGPT no garantizan el mismo resultado, así que una respuesta segura hoy puede no serlo mañana.
Al cambiar solo el modelo de flash a pro y enviar el mismo prompt, el resultado mejoró: el modelo pro detectó de una las dos vulnerabilidades y bloqueó el envío a WhatsApp [03:30]. Avisó que nunca deben mezclarse los productos y que las ventanas deben permanecer abiertas para ventilar los vapores.
La diferencia entre un modelo y otro revela el fondo del problema.
La demo usó modelos pagos, los modelos pro. Y aquí surge la pregunta incómoda que mucha gente debería hacerse.
¿Qué pasa si usas los modelos gratis, que es lo que usa la mayoría? ¿Podrías generar ese manual, compartirlo por WhatsApp e intoxicar gente sin querer? No lo sabemos. Lo mismo aplica a borrar una base de datos o subir fotos sin permiso.
¿Puedo confiar en un modelo gratuito de IA para tareas sensibles? No sin validación humana. Los modelos gratuitos pueden pasar por alto riesgos que un modelo pro detecta, así que cualquier output que afecte a personas o datos debe revisarse antes de usarlo.
Esa incertidumbre es justamente la razón de tener un proceso fijo.
La regla práctica es una sola frase: si es generado por inteligencia artificial, no significa que esté verificado. A partir de ahí viene el flujo correcto.
El patrón recomendado tiene cinco pasos encadenados:
El patrón malo, en cambio, es cortísimo y por eso peligroso: salida y ejecución directa, sin nada en medio. Ese salto es el que borró una base de datos o el que casi genera una guía tóxica para el personal de limpieza.
Si mantienes siempre esos cinco pasos antes de ejecutar cualquier cosa, reduces al mínimo la posibilidad de que algo salga mal. ¿Tú ya aplicas una validación humana antes de ejecutar lo que te da la IA? Cuéntame cómo lo haces en los comentarios.
Y ahora, en su gustada sección de Cuentos Posmodernos, "La IA y los hongos" (por si no fuera poco ver este post publicado hasta el hartazgo en LinkedIn)
!Este hongo es comestible? iSí! حه" A Tienes razón, ese hongo ...
OWASP LLM09: (https://genai.owasp.org/llmrisk/llm092025-misinformation/)
Desinformación — alucinaciones seguras sobre las que el usuario actúa, incluidos nombres de paquetes inventados (una trampa de cadena de suministro). Cadena de suministro y operación.
Es una de las formas que los modelos pueden darnos información errónea.
Me consta que esta trampa hubiera funcionado mejor en versiones más antiguas.
Me encanto ese ejemplo.
realmente hay que tener un gran cuidado con lo que uno escribe y si es generado con IA validarlo y leerlo bien hasta 2 veces
Totalmente de acuerdo en no ejecutar nada sin revisar. Una duda: ¿ustedes hacen esa validación a mano o ya automatizan a otro LLM para que haga el primer filtro de control?
La revisión, verificación o validación como lo ilustra el profesor en este ejemplo pues sigue siendo la premisa cuando trabajamos con la IA.
La clase deja una regla que un analista de datos puede aplicar sin cambiar de herramienta: generado por inteligencia artificial no significa verificado. El mismo profesor reconoce que estos modelos no son determinísticos, así que el mismo prompt puede dar respuestas distintas. Por ejemplo, un caso típico es un resumen de ejecución presupuestal que sale bien escrito pero con una cifra mal sumada. Si el flujo va de la salida directo a la ejecución, ese error llega al informe; si pasa por validación y autorización, alguien lo revisa antes. En equipos con poco personal, esa revisión es el control más barato que existe.
jii uñas ñ
Luis Arturo Cruz Cruz
Helber Fabian Toro
Team Platzi
Luis Cabezas
Javier Ramos

Sergio Brandon De Lucio Chavero
Luis Arturo Cruz Cruz
Yuli Natalia Cardona Viveros

javier angel

DANIEL ISAI CHIMAL POOT
Karina Aldana
Jhon Alexander Mosquera Vanegas
Víctor Mendoza
Y ahora, en su gustada sección de Cuentos Posmodernos, "La IA y los hongos" (por si no fuera poco ver este post publicado hasta el hartazgo en LinkedIn)
!Este hongo es comestible? iSí! حه" A Tienes razón, ese hongo ...
XD
OWASP LLM09: (https://genai.owasp.org/llmrisk/llm092025-misinformation/)
Desinformación — alucinaciones seguras sobre las que el usuario actúa, incluidos nombres de paquetes inventados (una trampa de cadena de suministro). Cadena de suministro y operación.
Es una de las formas que los modelos pueden darnos información errónea.
Excelente aporte
En general leer OWASP para LLM risks es una de las mejores practicas si estas construyendo agentes e incluso si no, la curiosidad recompensa
Me consta que esta trampa hubiera funcionado mejor en versiones más antiguas.
Me encanto ese ejemplo.
realmente hay que tener un gran cuidado con lo que uno escribe y si es generado con IA validarlo y leerlo bien hasta 2 veces
Totalmente de acuerdo en no ejecutar nada sin revisar. Una duda: ¿ustedes hacen esa validación a mano o ya automatizan a otro LLM para que haga el primer filtro de control?
La revisión, verificación o validación como lo ilustra el profesor en este ejemplo pues sigue siendo la premisa cuando trabajamos con la IA.
La clase deja una regla que un analista de datos puede aplicar sin cambiar de herramienta: generado por inteligencia artificial no significa verificado. El mismo profesor reconoce que estos modelos no son determinísticos, así que el mismo prompt puede dar respuestas distintas. Por ejemplo, un caso típico es un resumen de ejecución presupuestal que sale bien escrito pero con una cifra mal sumada. Si el flujo va de la salida directo a la ejecución, ese error llega al informe; si pasa por validación y autorización, alguien lo revisa antes. En equipos con poco personal, esa revisión es el control más barato que existe.
jii uñas ñ