0:005:44

Recursos

Resumen

Antes de compartir un Excel con un LLM como ChatGPT, necesitas sanitizar los datos para evitar fugas de información sensible. Esta práctica es clave para cualquier persona que use inteligencia artificial para analizar datos de clientes sin exponer privacidad ni comprometer la seguridad de su empresa.

Imagina que tienes una tabla con datos de clientes y quieres sacar el salario promedio o hacer gráficos. En un Excel con pocas columnas lo resuelves con una fórmula, pero cuando hablamos de cinco o seis millones de registros la cosa cambia. Ahí es cuando pedirle a un modelo que extraiga la información, la grafique y te exporte un PDF se vuelve tentador. El problema es que compartir el archivo tal cual abre varias fallas de seguridad.

Por qué compartir datos personales con una IA es un riesgo

El análisis de datos se hace por conjuntos, no por individuos. Eso significa que mucha de la información que identifica a una persona simplemente no la necesitas para tu estudio.

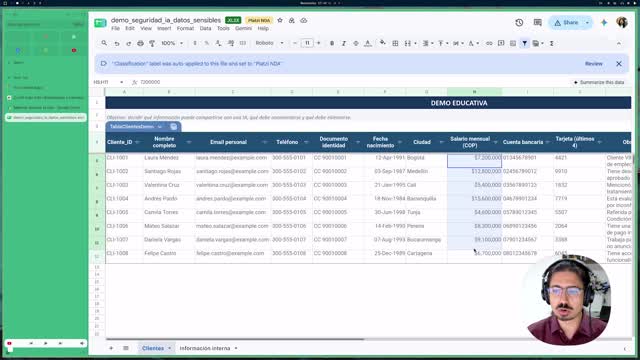
La tabla del ejemplo incluía client ID, nombre completo, email, teléfono, documento de identidad, fecha de nacimiento, ciudad, salario, cuenta bancaria, últimos cuatro dígitos de la tarjeta, una observación interna y un ticket de soporte. Y aquí viene lo interesante: si combinas el nombre completo con el documento de identidad, puedes identificar a esa persona prácticamente en cualquier parte del mundo [01:30].

¿Qué significa sanitizar datos antes de usar una IA? Es eliminar toda la información que permita identificar a una persona o exponer secretos de tu empresa, dejando solo los datos necesarios para el análisis. Por ejemplo, borrar nombres, documentos, correos y contraseñas antes de subir el archivo.

Qué columnas puedes conservar y cuáles debes borrar

No todo es blanco o negro. La decisión depende de si el dato identifica a alguien o aporta valor al análisis sin exponer a nadie.

  • Client ID: se puede conservar, porque es una referencia interna que solo tu empresa usa y no identifica al usuario.
  • Nombre completo, email, teléfono y documento de identidad: se borran, no aportan al análisis por conjuntos.
  • Fecha de nacimiento, ciudad y salario: se pueden dejar, sirven para encontrar rangos como qué edad gana cuánto en promedio.
  • Cuenta bancaria y últimos dígitos de la tarjeta: se borran, no interesan para el estudio y son datos sensibles.

Después de limpiar esas columnas, quedan dos casos que viven en una zona gris y merecen una mirada más cuidadosa.

Cómo manejar los datos que están en la frontera

La observación interna y el ticket de soporte son el ejemplo perfecto de decisiones subjetivas. Ambas podrían servir para un análisis cualitativo, pero hay que revisar qué contienen antes de decidir.

En el ejemplo, un ticket decía que el cliente había enviado su clave temporal: demo#2026! [03:40]. Esto es más común de lo que parece. Es frecuente recibir tickets donde el usuario comparte usuario y contraseña para que confirmes que su problema es real. Por eso ese ticket con información sensible no se comparte.

La observación interna, en cambio, es distinta. Si ya capacitaste a tu personal sobre qué escribir y qué no cuando saben que ese texto podría ir a una inteligencia artificial, entonces esa columna es segura.

¿Por qué es peligroso un ticket de soporte en un análisis de datos? Porque los usuarios suelen incluir contraseñas, claves temporales o accesos dentro del texto. Si lo compartes con un LLM sin revisarlo, expones credenciales reales de tus clientes.

Qué revisar antes de enviar un Excel completo a un LLM

Aunque creas que limpiaste todo, el archivo puede esconder sorpresas. En el ejemplo, el documento tenía un segundo tab que pasó desapercibido, y resultó aún más grave que las columnas limpiadas antes.

Ese segundo tab contenía información crítica de la empresa:

  • API keys activas.
  • La contraseña de la base de datos (Postgres Analytics).
  • Un endpoint interno.
  • Estrategia comercial y presupuesto de una campaña.

Esa información es privada y ni siquiera debería estar en un Excel. Su lugar es un gestor de contraseñas o una bóveda segura, nunca una hoja de cálculo lista para enviarse a un modelo. La lección es clara: revisa siempre todas las pestañas del archivo antes de compartirlo.

Cuál es la regla práctica para compartir datos con una IA

Antes de enviar cualquier información a un modelo, hazte una pregunta sencilla que resume todo el proceso.

¿Cómo sé si puedo compartir un dato con una IA? Pregúntate si estarías cómodo enviándolo a un proveedor externo por email. Si la respuesta es sí, probablemente es seguro compartirlo. Si es no, sanitiza los datos primero.

Esa prueba mental funciona como filtro final [05:30]. Si no le mandarías esa información a nadie por correo, entonces necesitas limpiar el archivo antes de dárselo a un LLM. Así proteges la privacidad de tus clientes y los secretos de tu empresa sin renunciar al poder de la analítica.

¿Tú ya revisas todas las pestañas de tus archivos antes de subirlos a una IA? Cuéntanos en los comentarios cómo manejas la información sensible en tu trabajo.

Sanitizar datos antes de compartirlos con un LLM