Curso de Fundamentos de Bases de Datos

Primary Key y Foreign Key en bases de datos

Curso de Fundamentos de Bases de Datos

Contenido del curso

Grabación

PlatziLearn

0:008:23

Recursos

Resumen

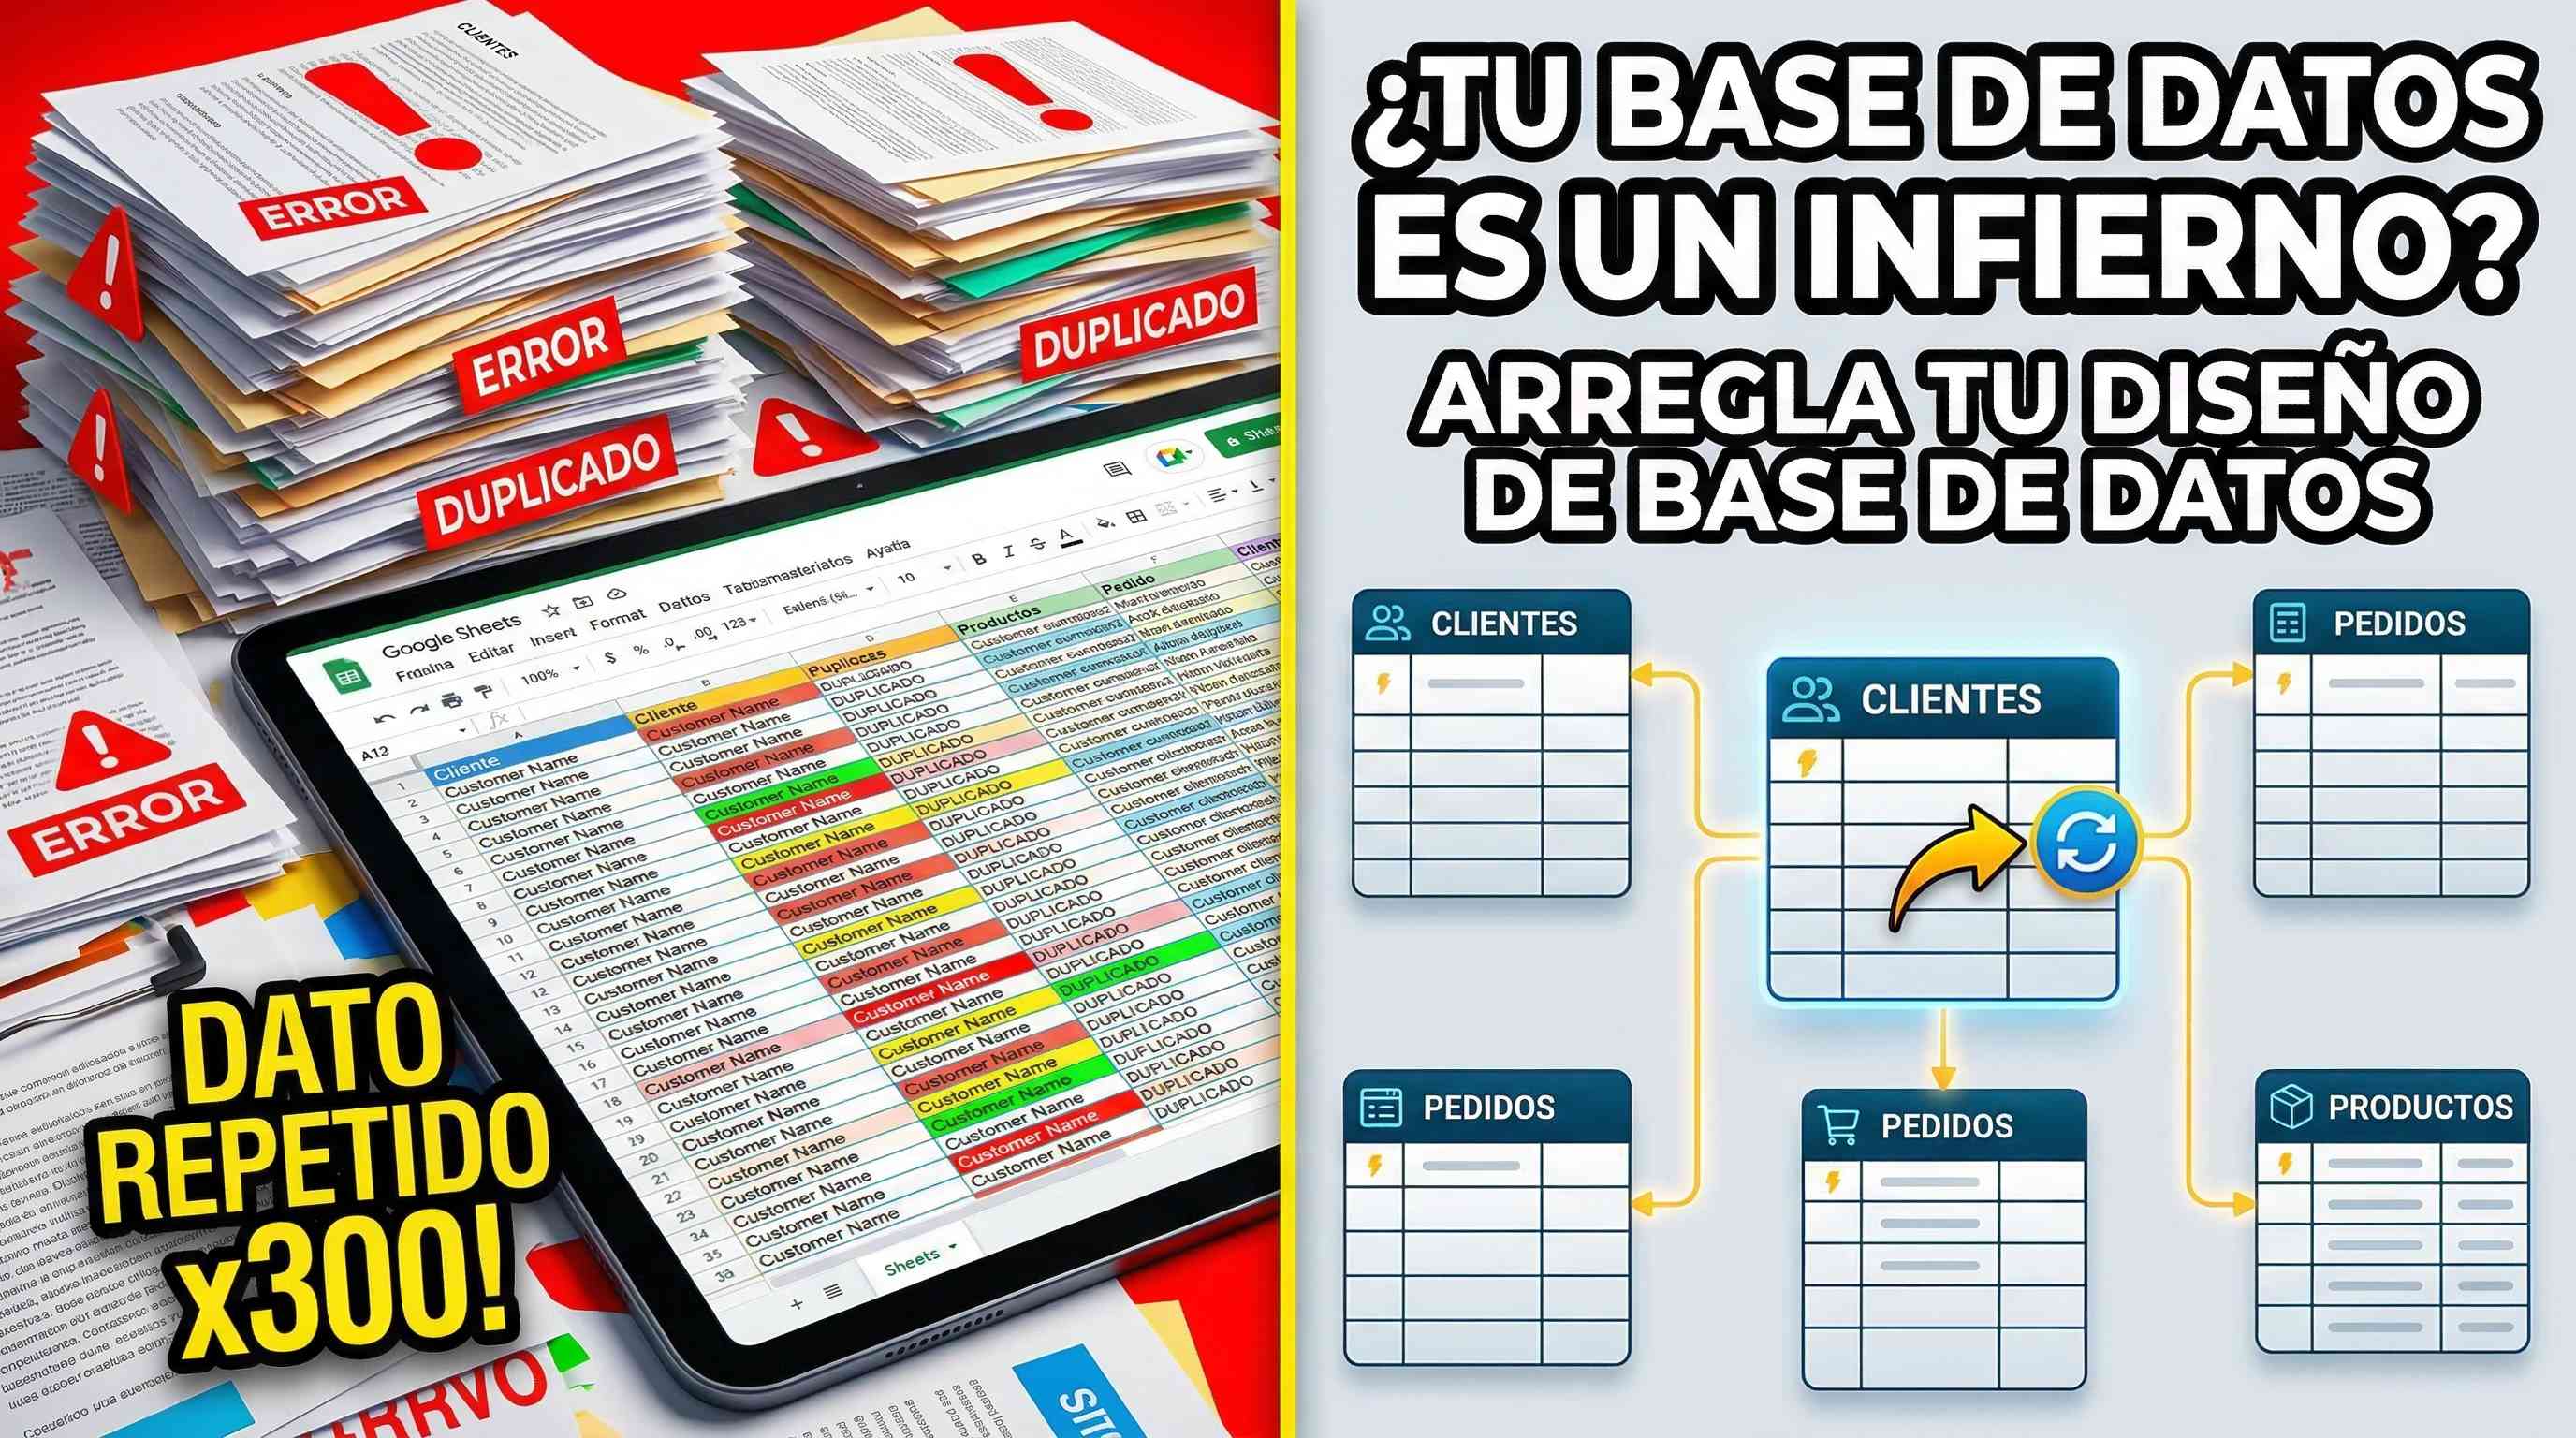
Responder una pregunta tan simple como "¿cuánto compró Ana el mes pasado?" puede convertirse en una pesadilla cuando los datos viven en un Excel de 50 mil filas, con nombres repetidos y correos inconsistentes. Ese caos tiene nombre, y la solución también: entender cómo se relacionan las tablas dentro de una base de datos bien diseñada. Los tres tipos de relaciones —uno a uno, uno a muchos y muchos a muchos— son la base para construir modelos que no se rompen.

¿Qué son la Primary Key y la Foreign Key?

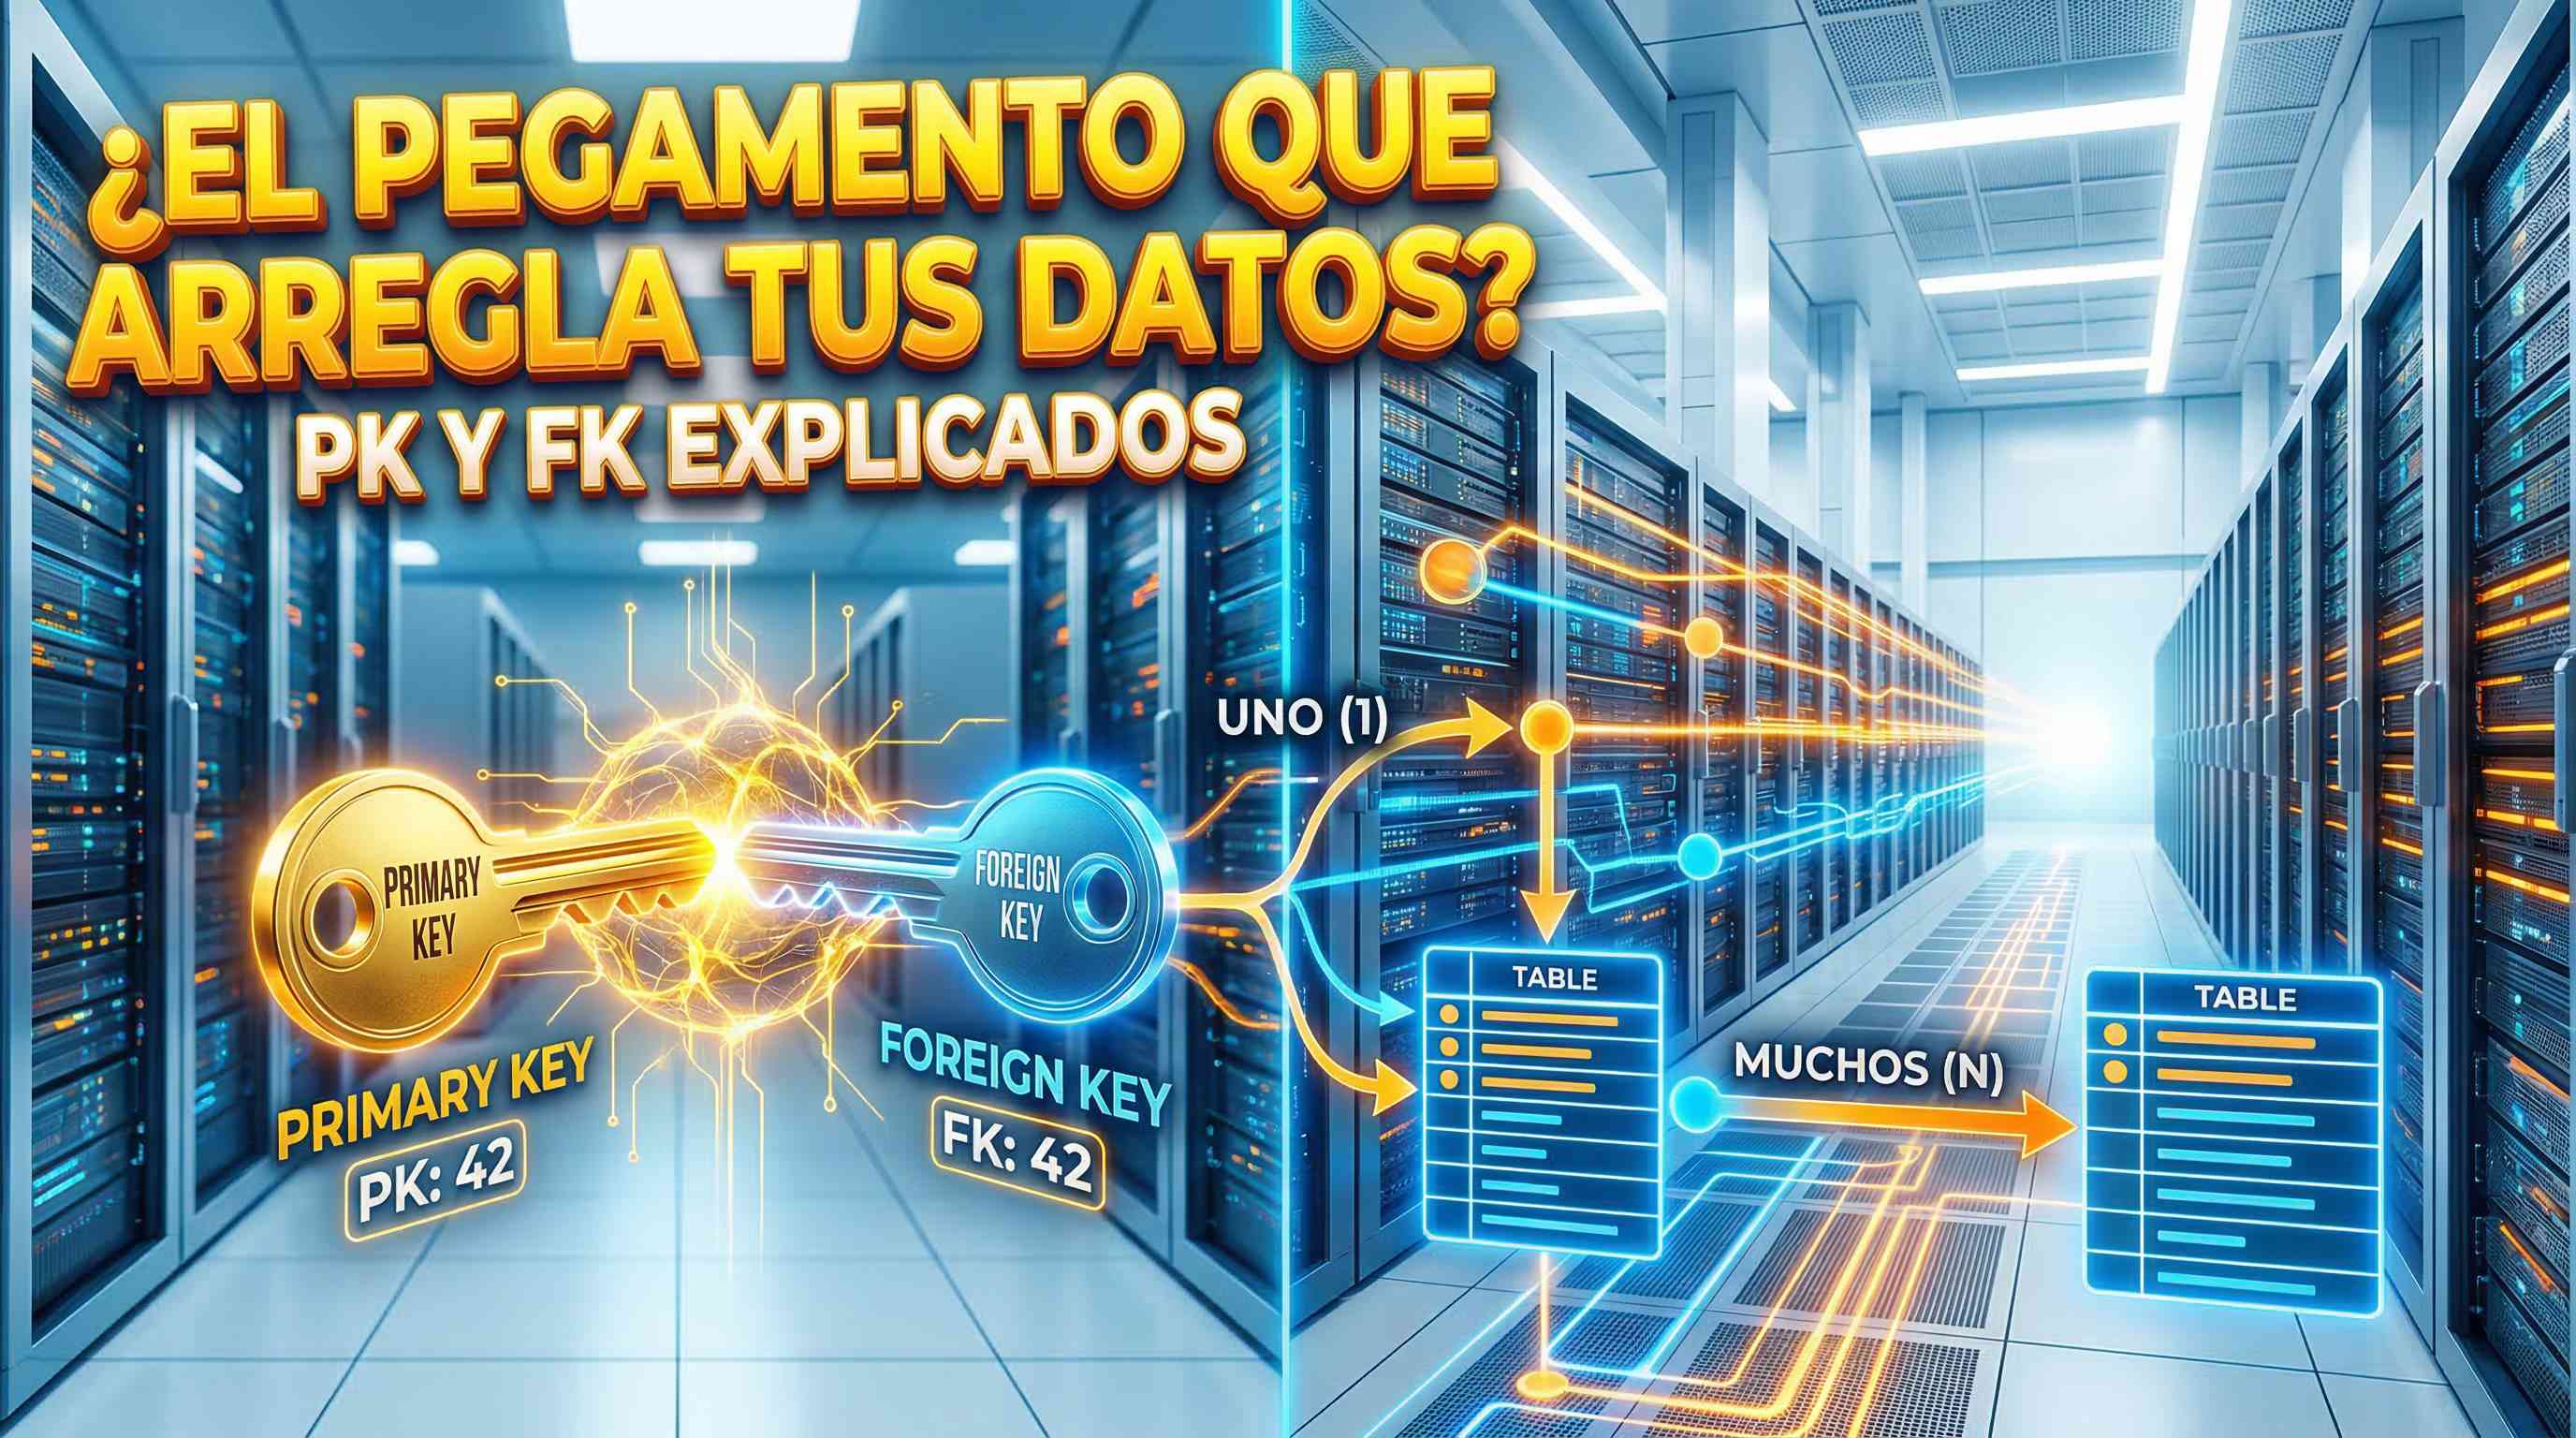
Antes de hablar de relaciones, es necesario dominar dos piezas fundamentales [0:35]. La Primary Key funciona como el número de documento de identidad de cada fila. Cada registro en una tabla tiene uno, es único, irrepetible y nunca puede estar vacío. Si dos filas compartieran el mismo valor, sería como que dos personas tuvieran el mismo DNI: un desastre.

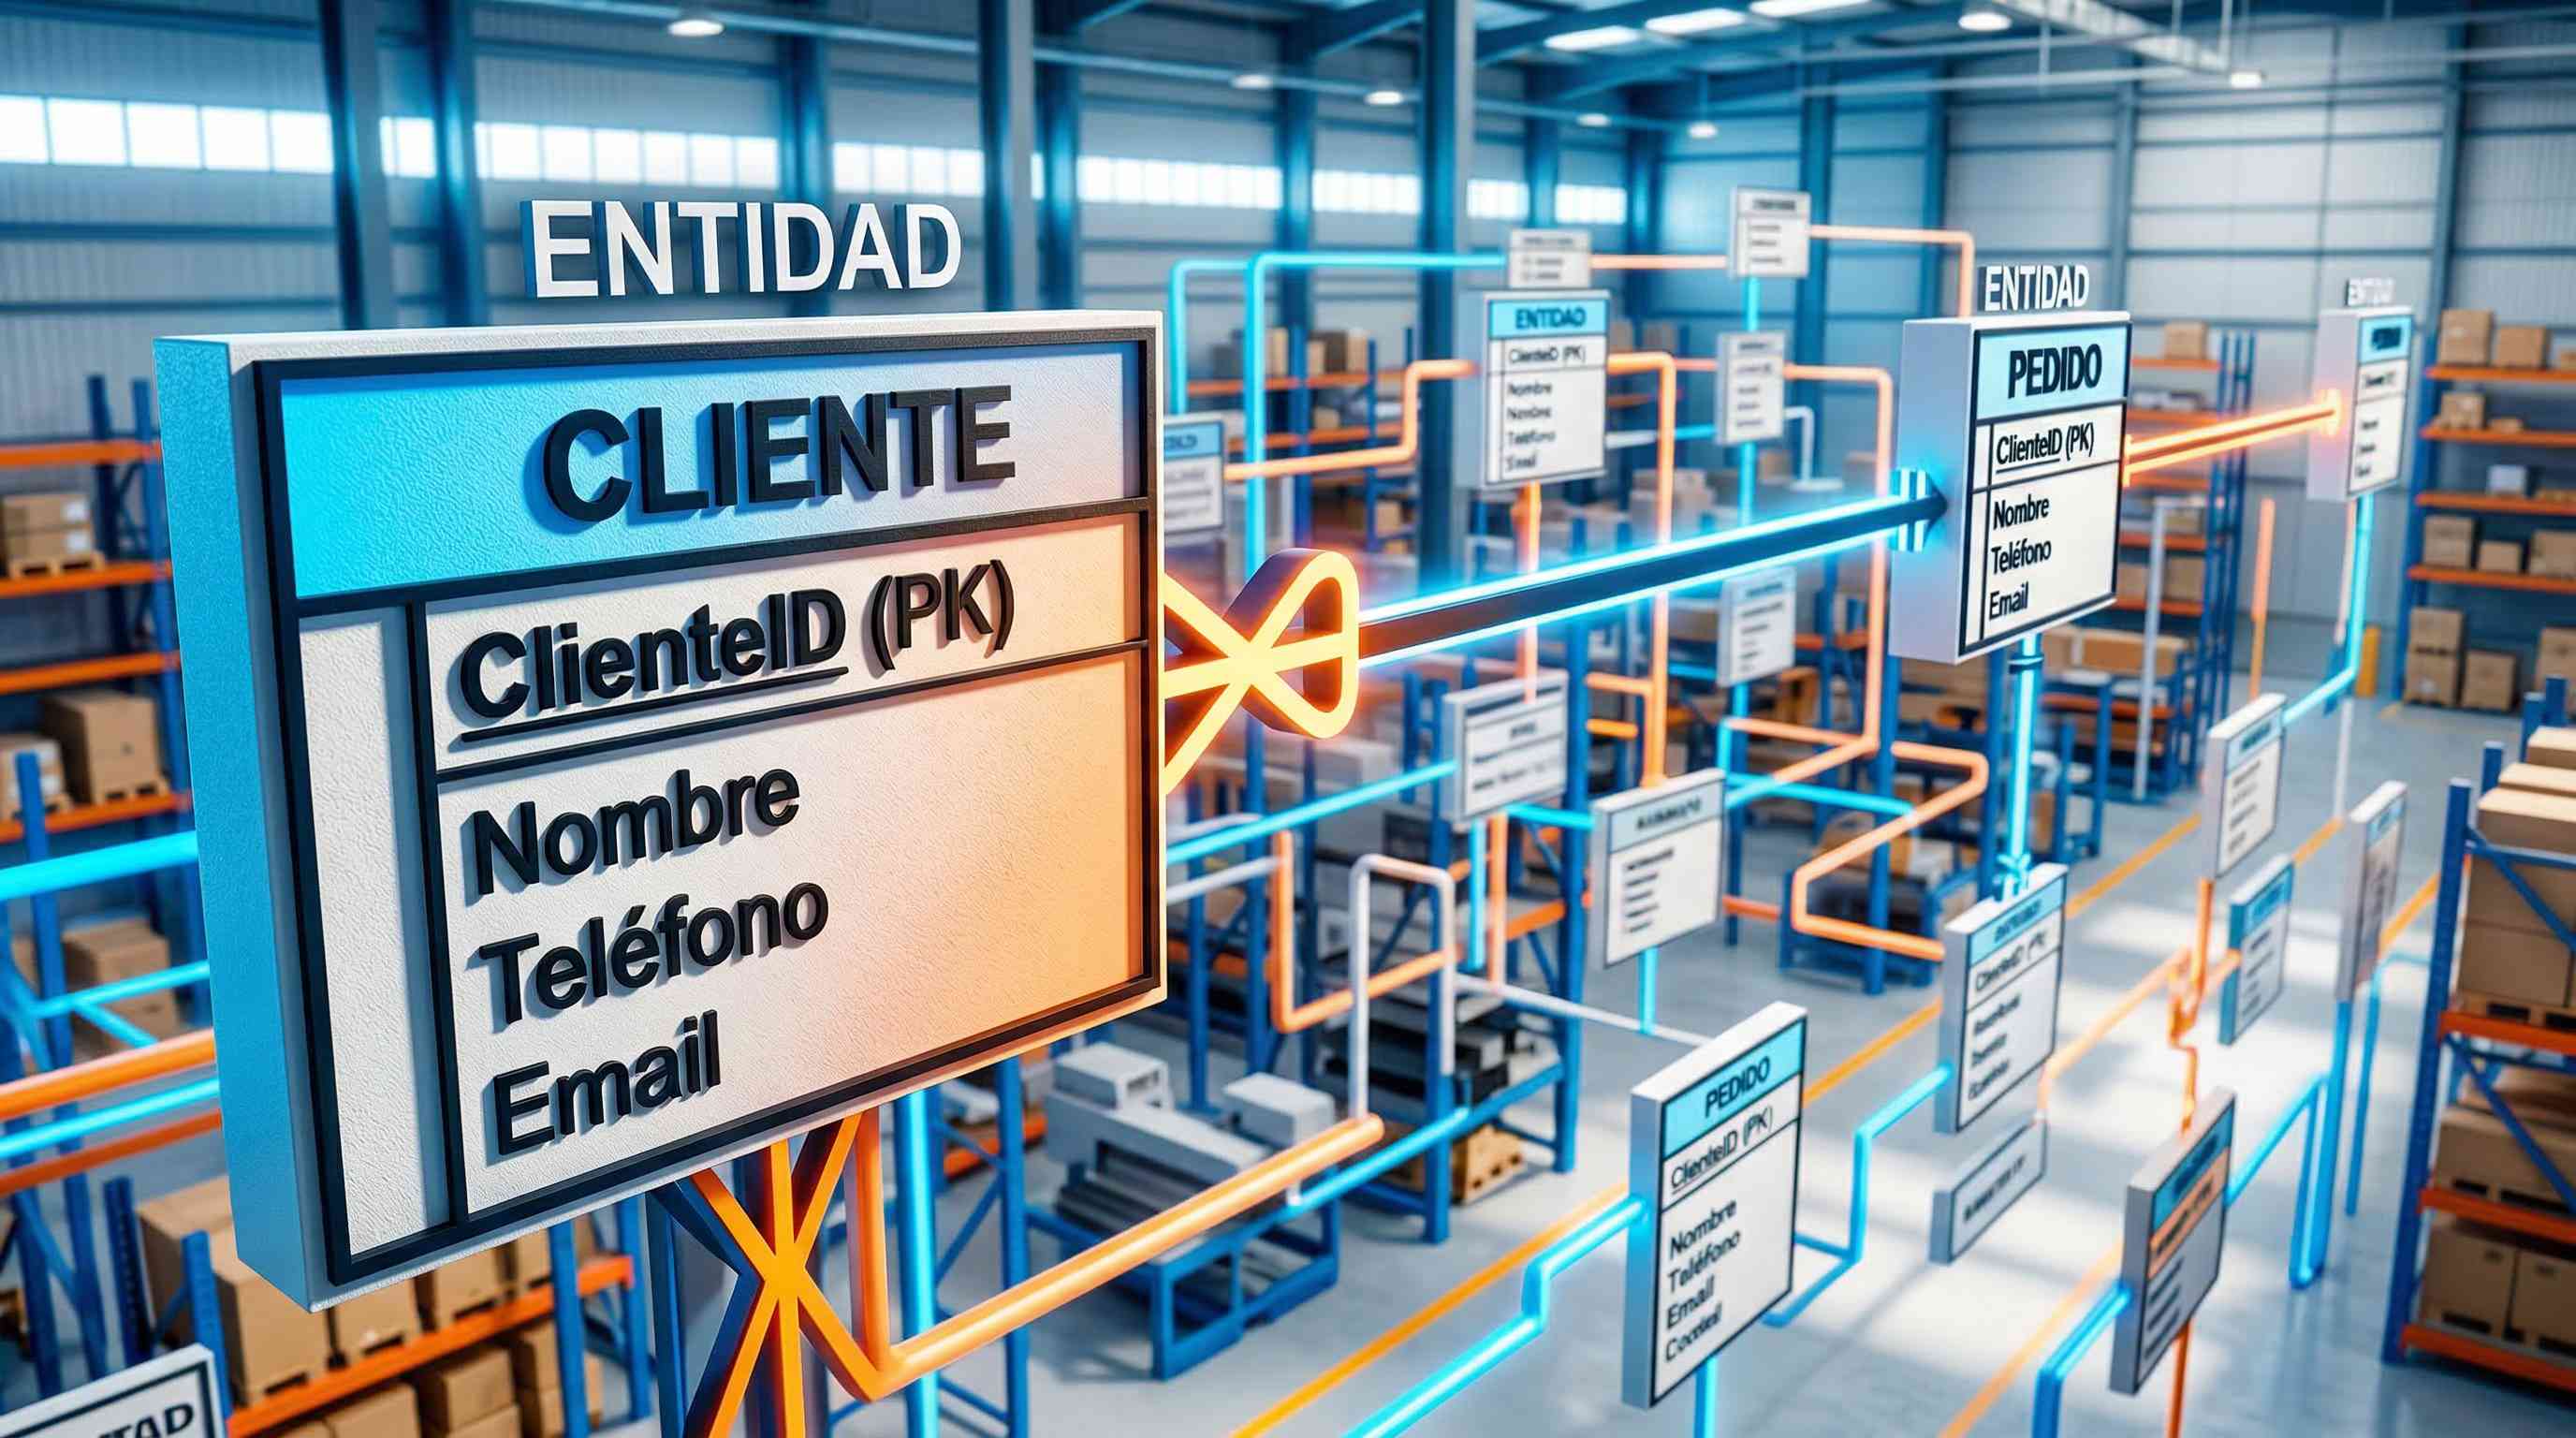
La Foreign Key es ese mismo número de documento, pero escrito dentro de otro documento [0:59]. Piensen en un contrato de alquiler: ahí aparece tu DNI, no porque el contrato sea tu identidad, sino porque necesita referenciarte. La regla estricta es que ese número tiene que existir en la tabla original. Si escriben un ClienteID igual a 42 en la tabla de Pedidos, el cliente 42 más vale que exista [1:17].

Cuando esa referencia apunta a un registro que no existe, se produce un registro huérfano: un pedido que apunta a la nada. En producción, eso es una bomba de tiempo [1:27]. Esos datos fantasma que aparecen en reportes y ya no corresponden a nada real probablemente son registros huérfanos sin que nadie lo sepa.

¿Cómo funciona la relación uno a muchos?

Es la relación más común en cualquier sistema de negocio [0:42]. Un cliente hace muchos pedidos, pero cada pedido pertenece a un solo cliente. Un país tiene muchos ciudadanos, pero cada ciudadano pertenece a un solo país. Este patrón, conocido como 1 a N, aparece por todos lados porque refleja cómo funciona el mundo real [1:59].

La regla de oro es inquebrantable: la Foreign Key siempre va en la tabla del lado "muchos" [2:04]. La columna de FK puede repetir valores. Si Ana tiene el ClienteID igual a 1 y hace 300 pedidos, ese número 1 aparece 300 veces en la tabla Pedidos, una vez por cada compra [2:16]. Eso es perfectamente válido del lado N.

Si intentaran ponerla del lado del cliente, ¿qué harían? ¿Crear una columna por cada pedido posible? PedidoUno, PedidoDos, PedidoTrescientos... Absurdo. El modelo colapsa [2:33]. Por eso la FK vive siempre en el lado N.

¿Qué pasa cuando ambos lados son "muchos"?

Ahí entramos en territorio de relación muchos a muchos, o N a M [3:02]. Piensen en pedidos y productos: un pedido contiene muchos productos, pero ese mismo modelo de laptop aparece en cientos de pedidos distintos. Ambos lados son múltiples.

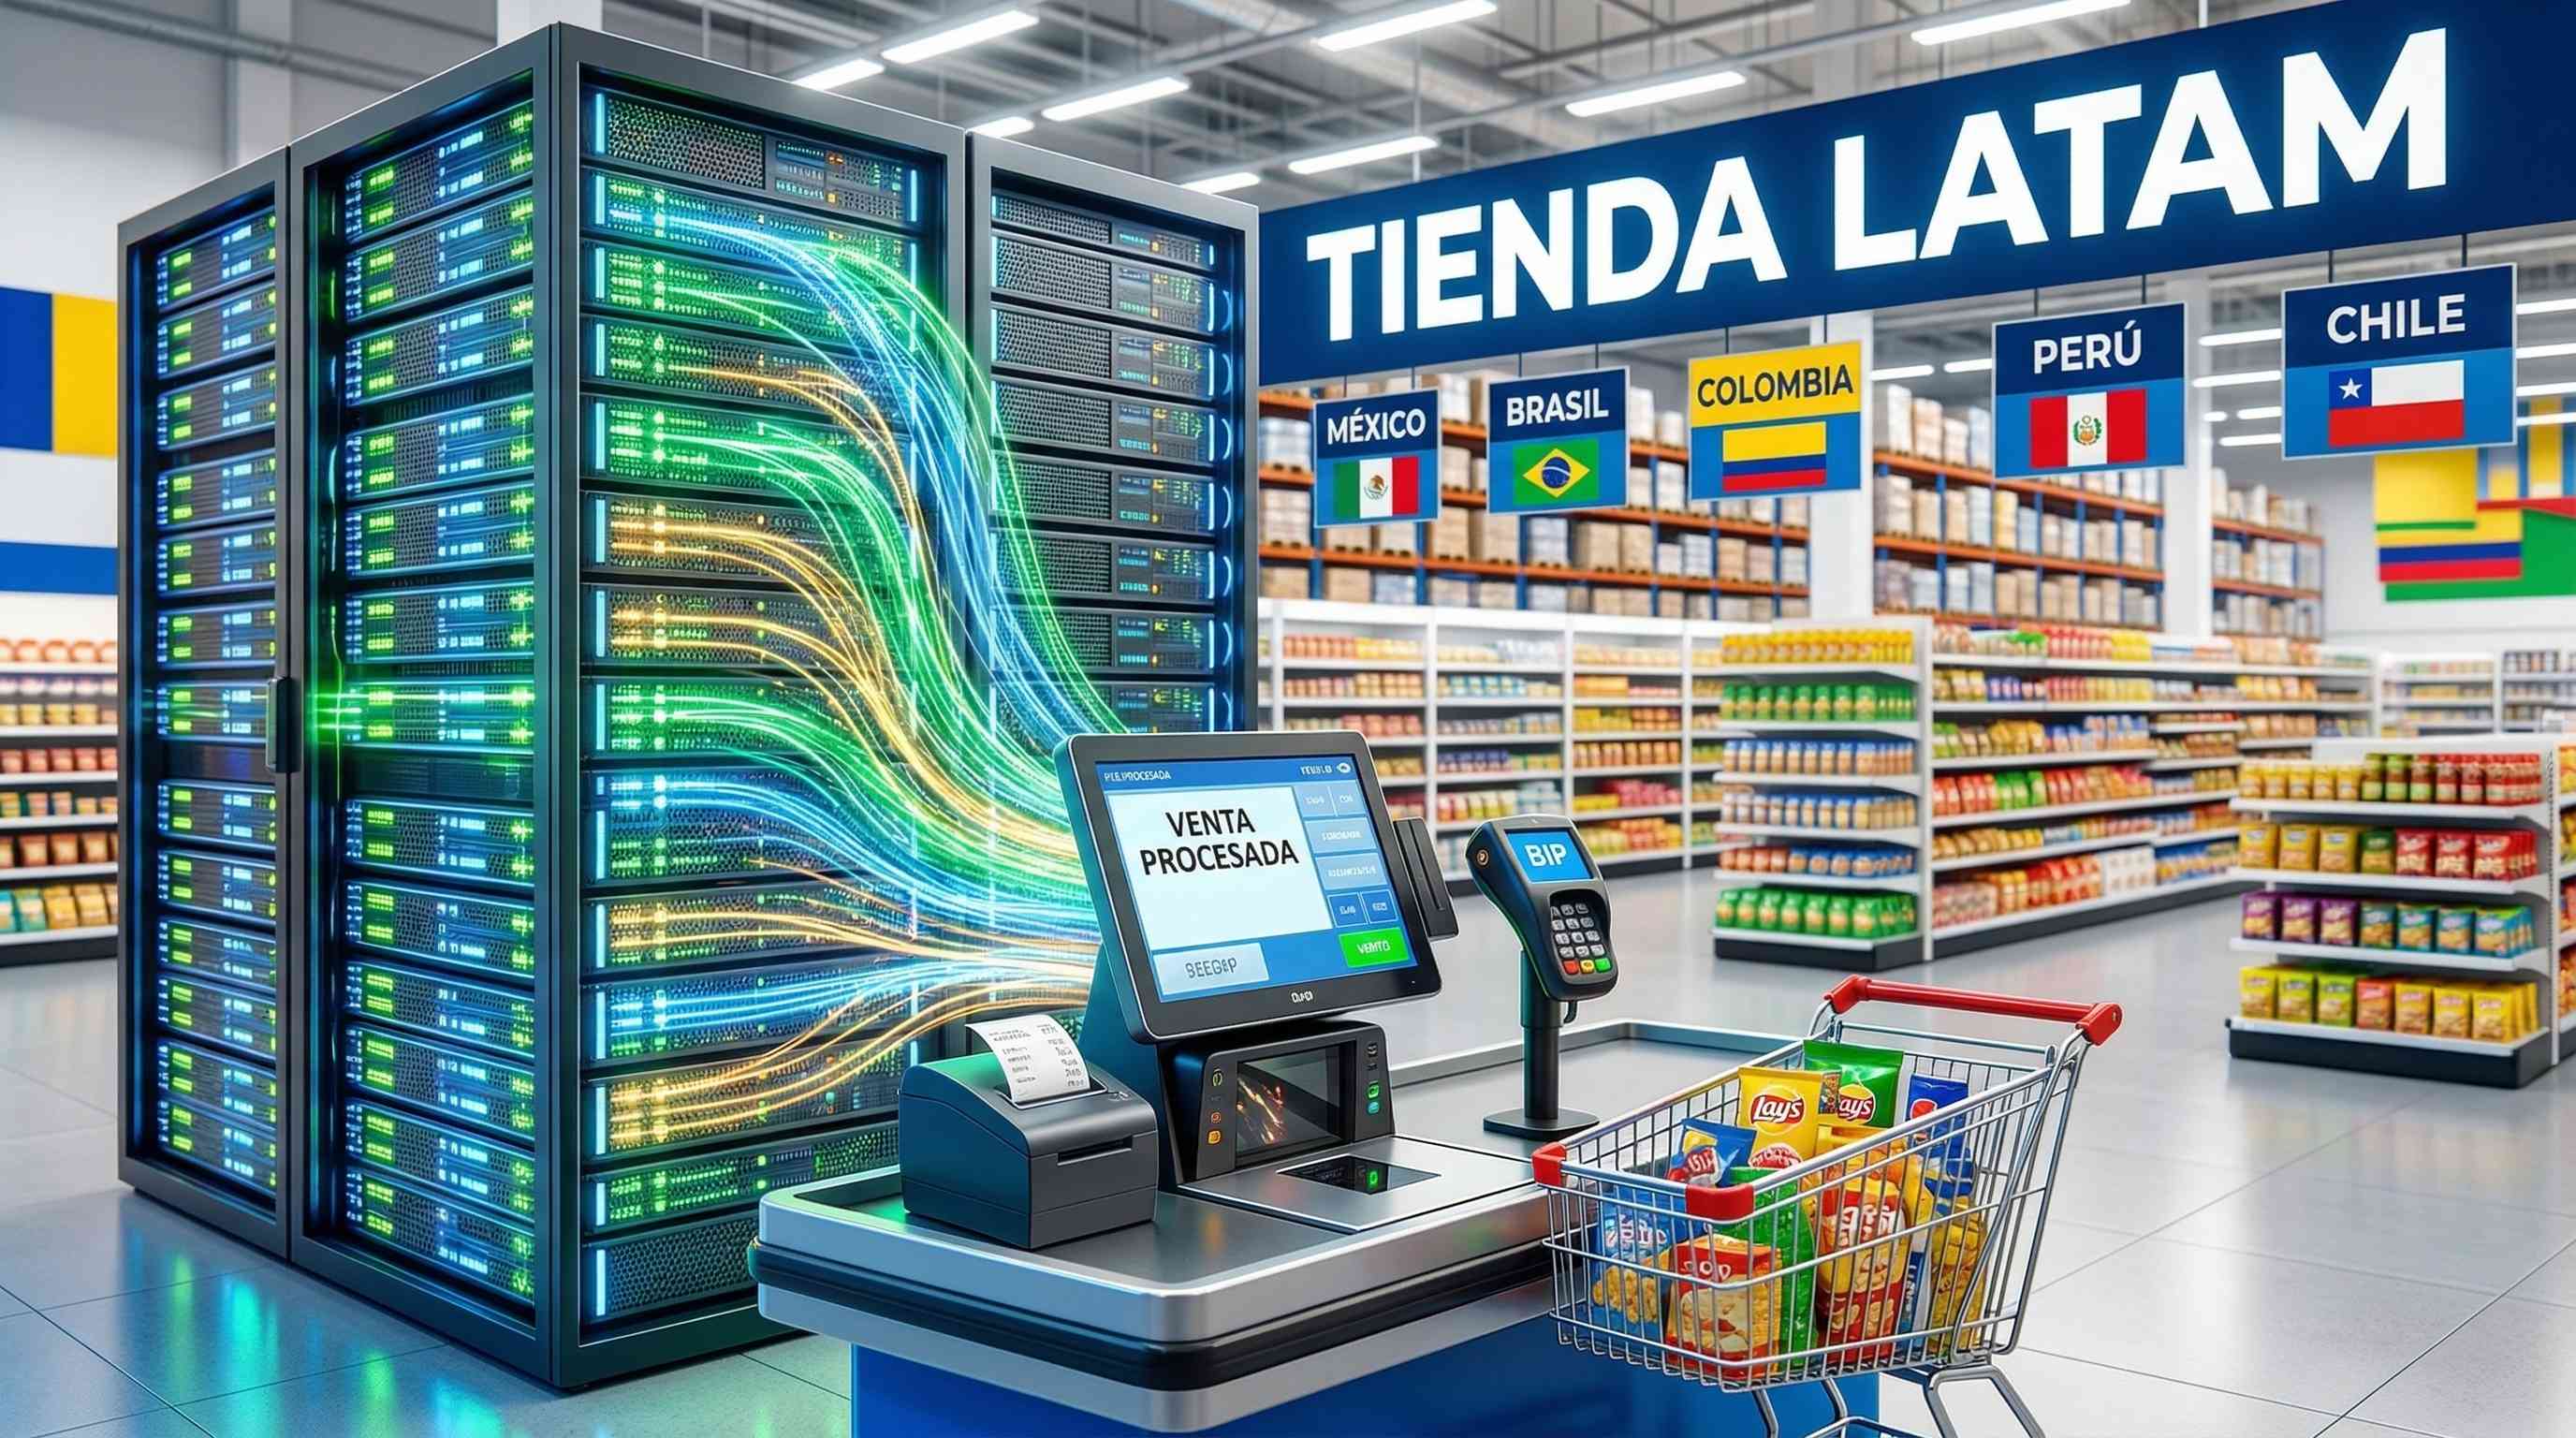
Aquí no se puede simplemente poner una FK en ninguna de las dos tablas. La solución es crear una tabla puente [3:32]. En el ejemplo de TiendaLatam, esa tabla se llama DetallePedido y contiene como mínimo dos Foreign Keys: una apuntando a PedidoID y otra a ProductoID [3:39]. Lo que era una relación imposible se convierte en dos relaciones perfectamente válidas de uno a muchos.

Lo verdaderamente brillante es que la tabla puente no solo conecta, también guarda datos que solo existen en esa conexión [4:00]: la cantidad de unidades y el precio unitario al momento de la compra. Si mañana la laptop sube de precio, el registro histórico de lo que Ana pagó queda intacto en DetallePedido.

¿Cuándo se usa la relación uno a uno?

Es la menos frecuente, pero cuando la necesitan, la necesitan de verdad [4:21]. Imaginen la tabla Empleados con nombre, cargo y departamento —información pública—. Pero el salario, la cuenta bancaria y el historial disciplinario son confidenciales. Se crea una segunda tabla, LegajoEmpleado, donde cada empleado tiene exactamente un legajo y viceversa.

Técnicamente se implementa igual que una relación uno a muchos, pero la FK lleva una restricción UNIQUE encima [4:54]. Ese UNIQUE es lo que la hace especial: sin él, la base de datos la trata como uno a muchos por defecto. Las tres razones para usarla son seguridad, rendimiento y opcionalidad [5:08].

¿Cómo decidir qué tipo de relación usar?

Hay un truco que nunca falla: pregunten en ambas direcciones [6:00]. Tomen dos entidades, A y B, y hagan dos preguntas. Primera: ¿puede un registro de A relacionarse con muchos registros de B? Segunda: ¿puede un registro de B relacionarse con muchos registros de A?

  • Si ambas respuestas son sí: N a M, necesitan tabla puente.
  • Si solo una es sí: uno a muchos.
  • Si ambas son no: uno a uno.

Practiquemos [5:33]. Madre e hijo: ¿una madre puede tener varios hijos? Sí. Entonces es uno a muchos. Estudiantes y cursos: ambas respuestas son sí, así que es N a M con una tabla puente que podría llamarse Inscripciones [5:53]. Doctor y paciente: un doctor atiende muchos pacientes y un paciente puede ver muchos doctores. N a M [7:07].

Un error que vale la pena grabar a fuego [7:13]: nunca guarden una relación muchos a muchos dentro de una sola columna con texto separado por comas. Algo como "Laptop; Mouse; Teclado" metido en un campo de texto parece un atajo, pero es una trampa. No pueden filtrar, no pueden contar, no pueden calcular ventas por producto. Arreglar esto en producción con datos históricos es un proyecto de meses.

Si ya pueden identificar estos tres tipos de relación y saben dónde colocar cada Foreign Key, están pensando como diseñadores de bases de datos. ¿Se animan a clasificar las relaciones de su propio proyecto?

Primary Key y Foreign Key en bases de datos

Curso de Fundamentos de Bases de Datos

Clase 29 de 33

Clase 29 / 33