Curso de Fundamentos de Bases de Datos

Primero el negocio, después el código

Curso de Fundamentos de Bases de Datos

Contenido del curso

Grabación

PlatziLearn

0:006:44

Recursos

Resumen

Antes de escribir una sola línea de código, hay que entender qué hace la empresa, qué vende, a quién le vende y dónde opera. Una base de datos no se diseña desde el código, se diseña desde el negocio [0:08]. Si se saltan ese paso, van a crear tablas que no sirven. Con esa premisa arranca el recorrido por TiendaLatam, una cadena de retail ficticia que será el caso de estudio a lo largo de todo el curso.

¿Qué es TiendaLatam y por qué necesita una base de datos?

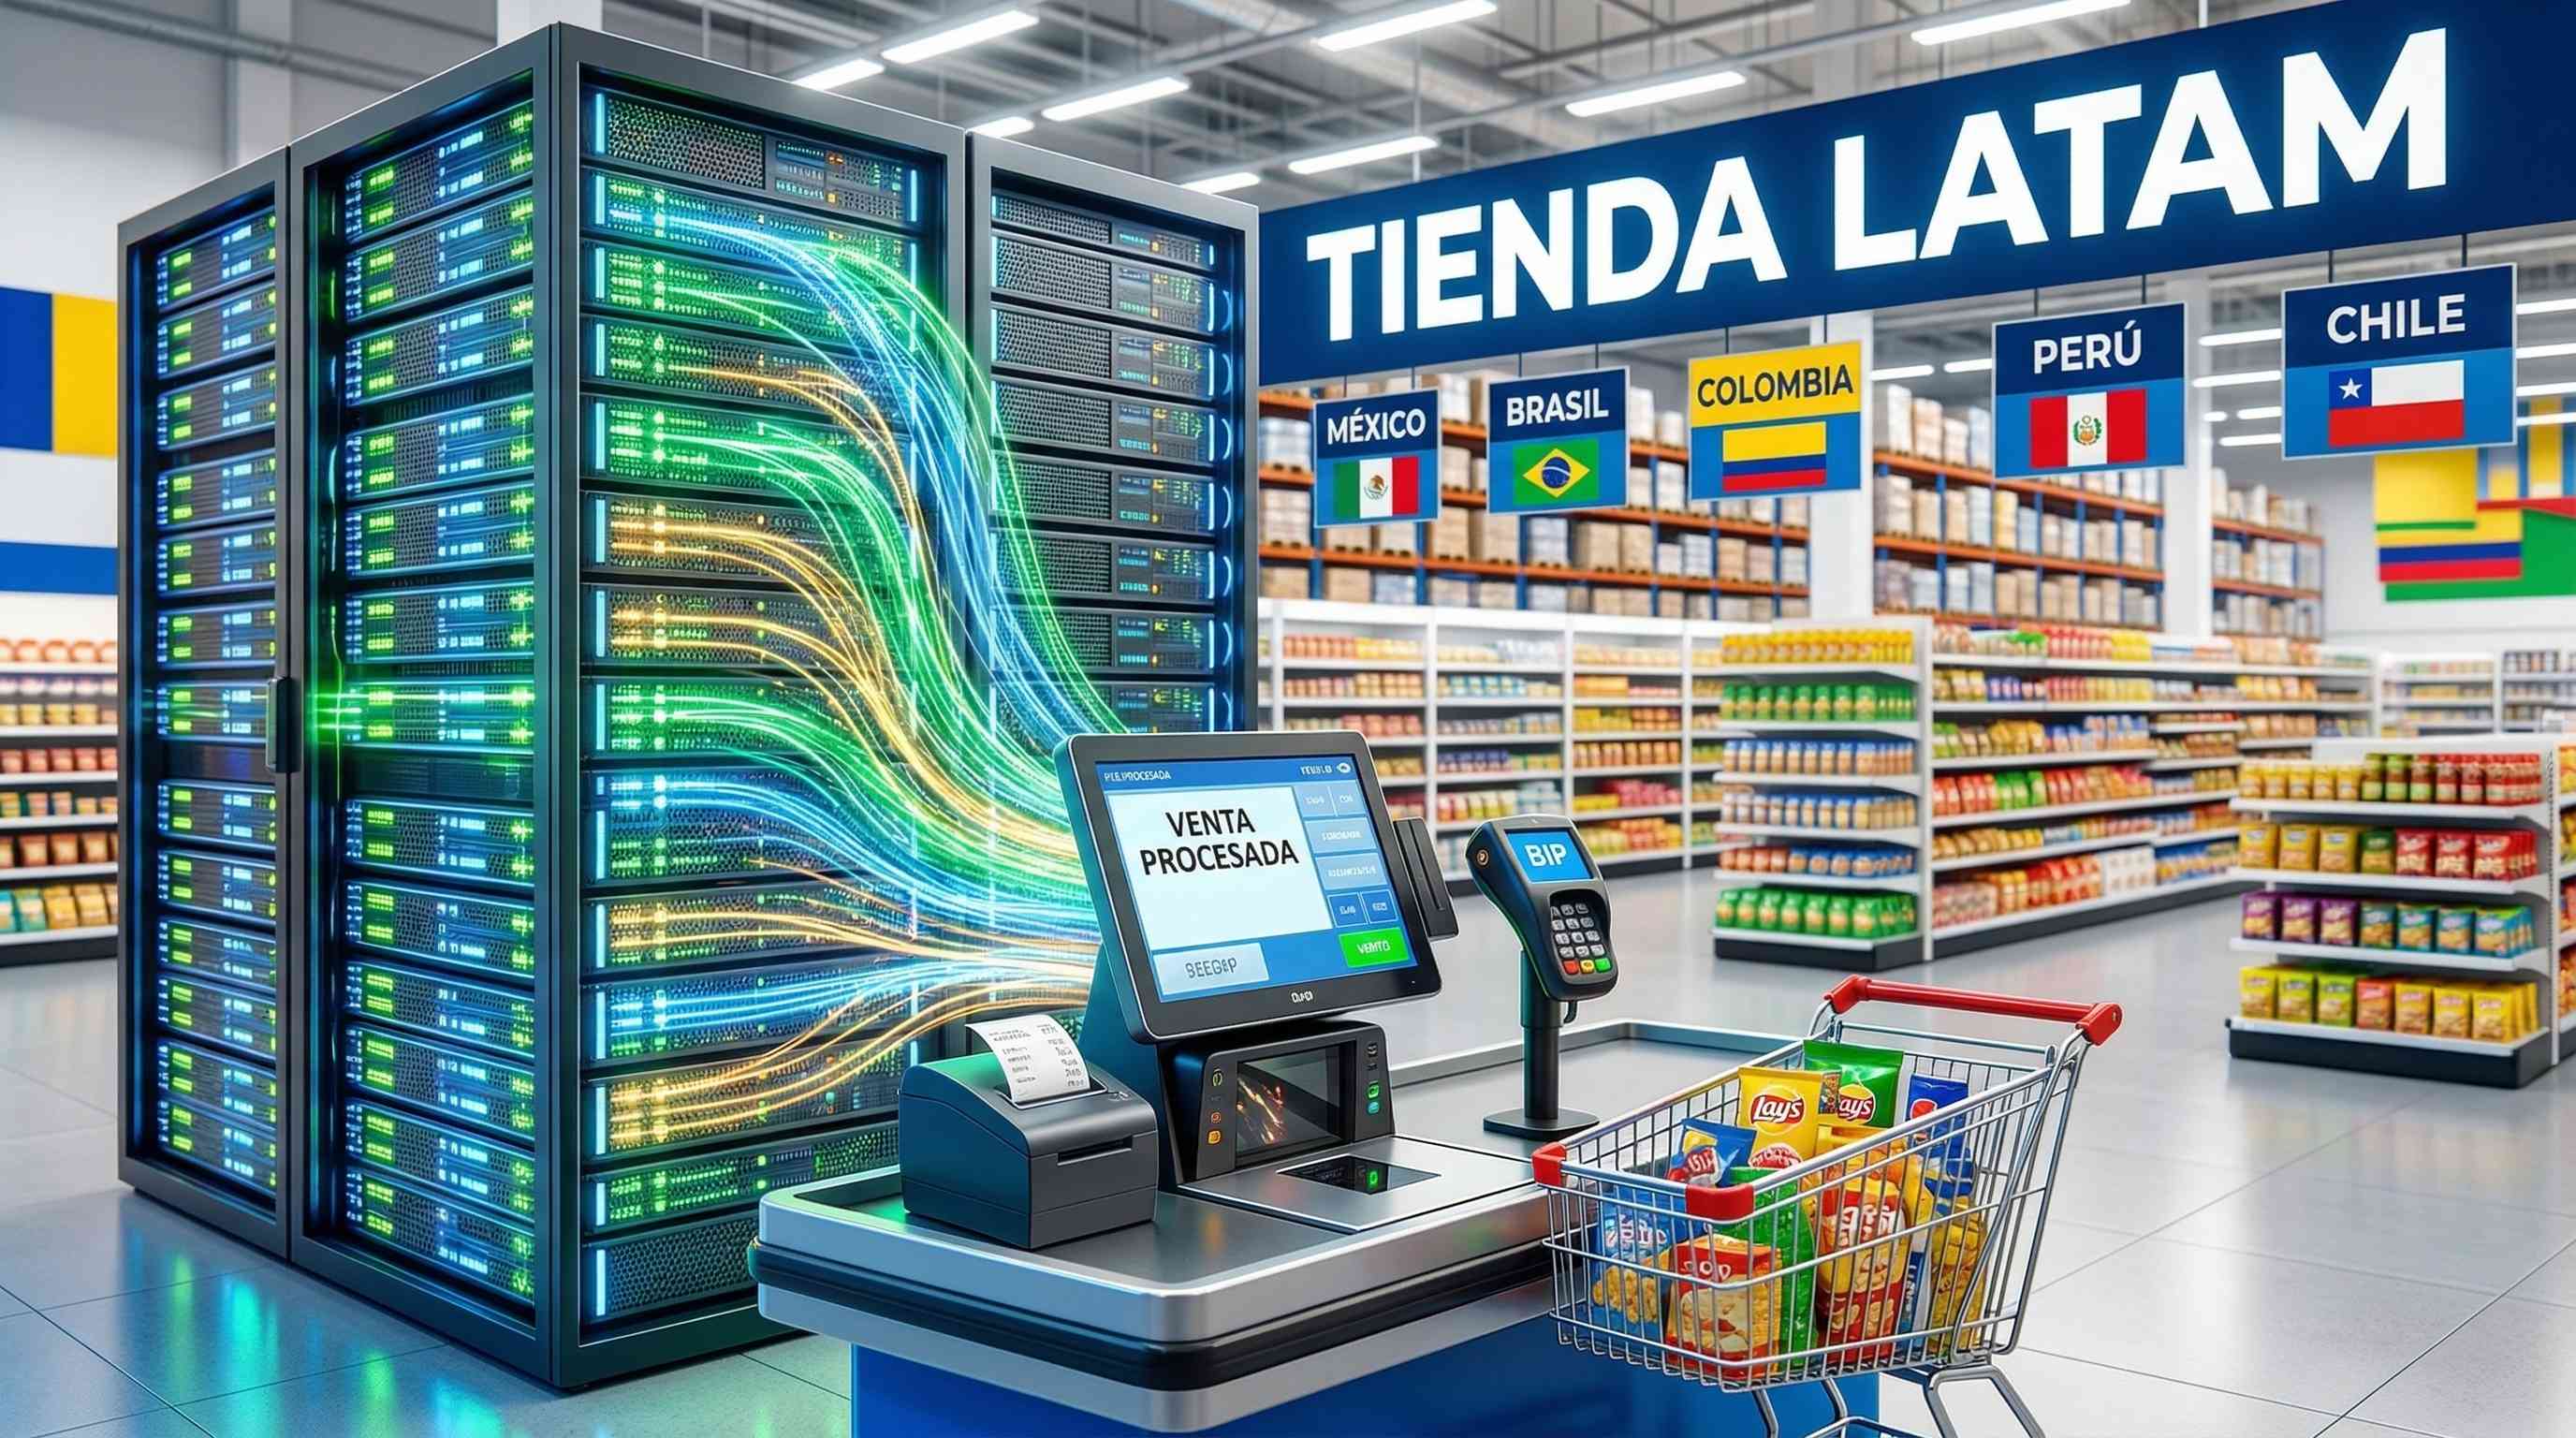
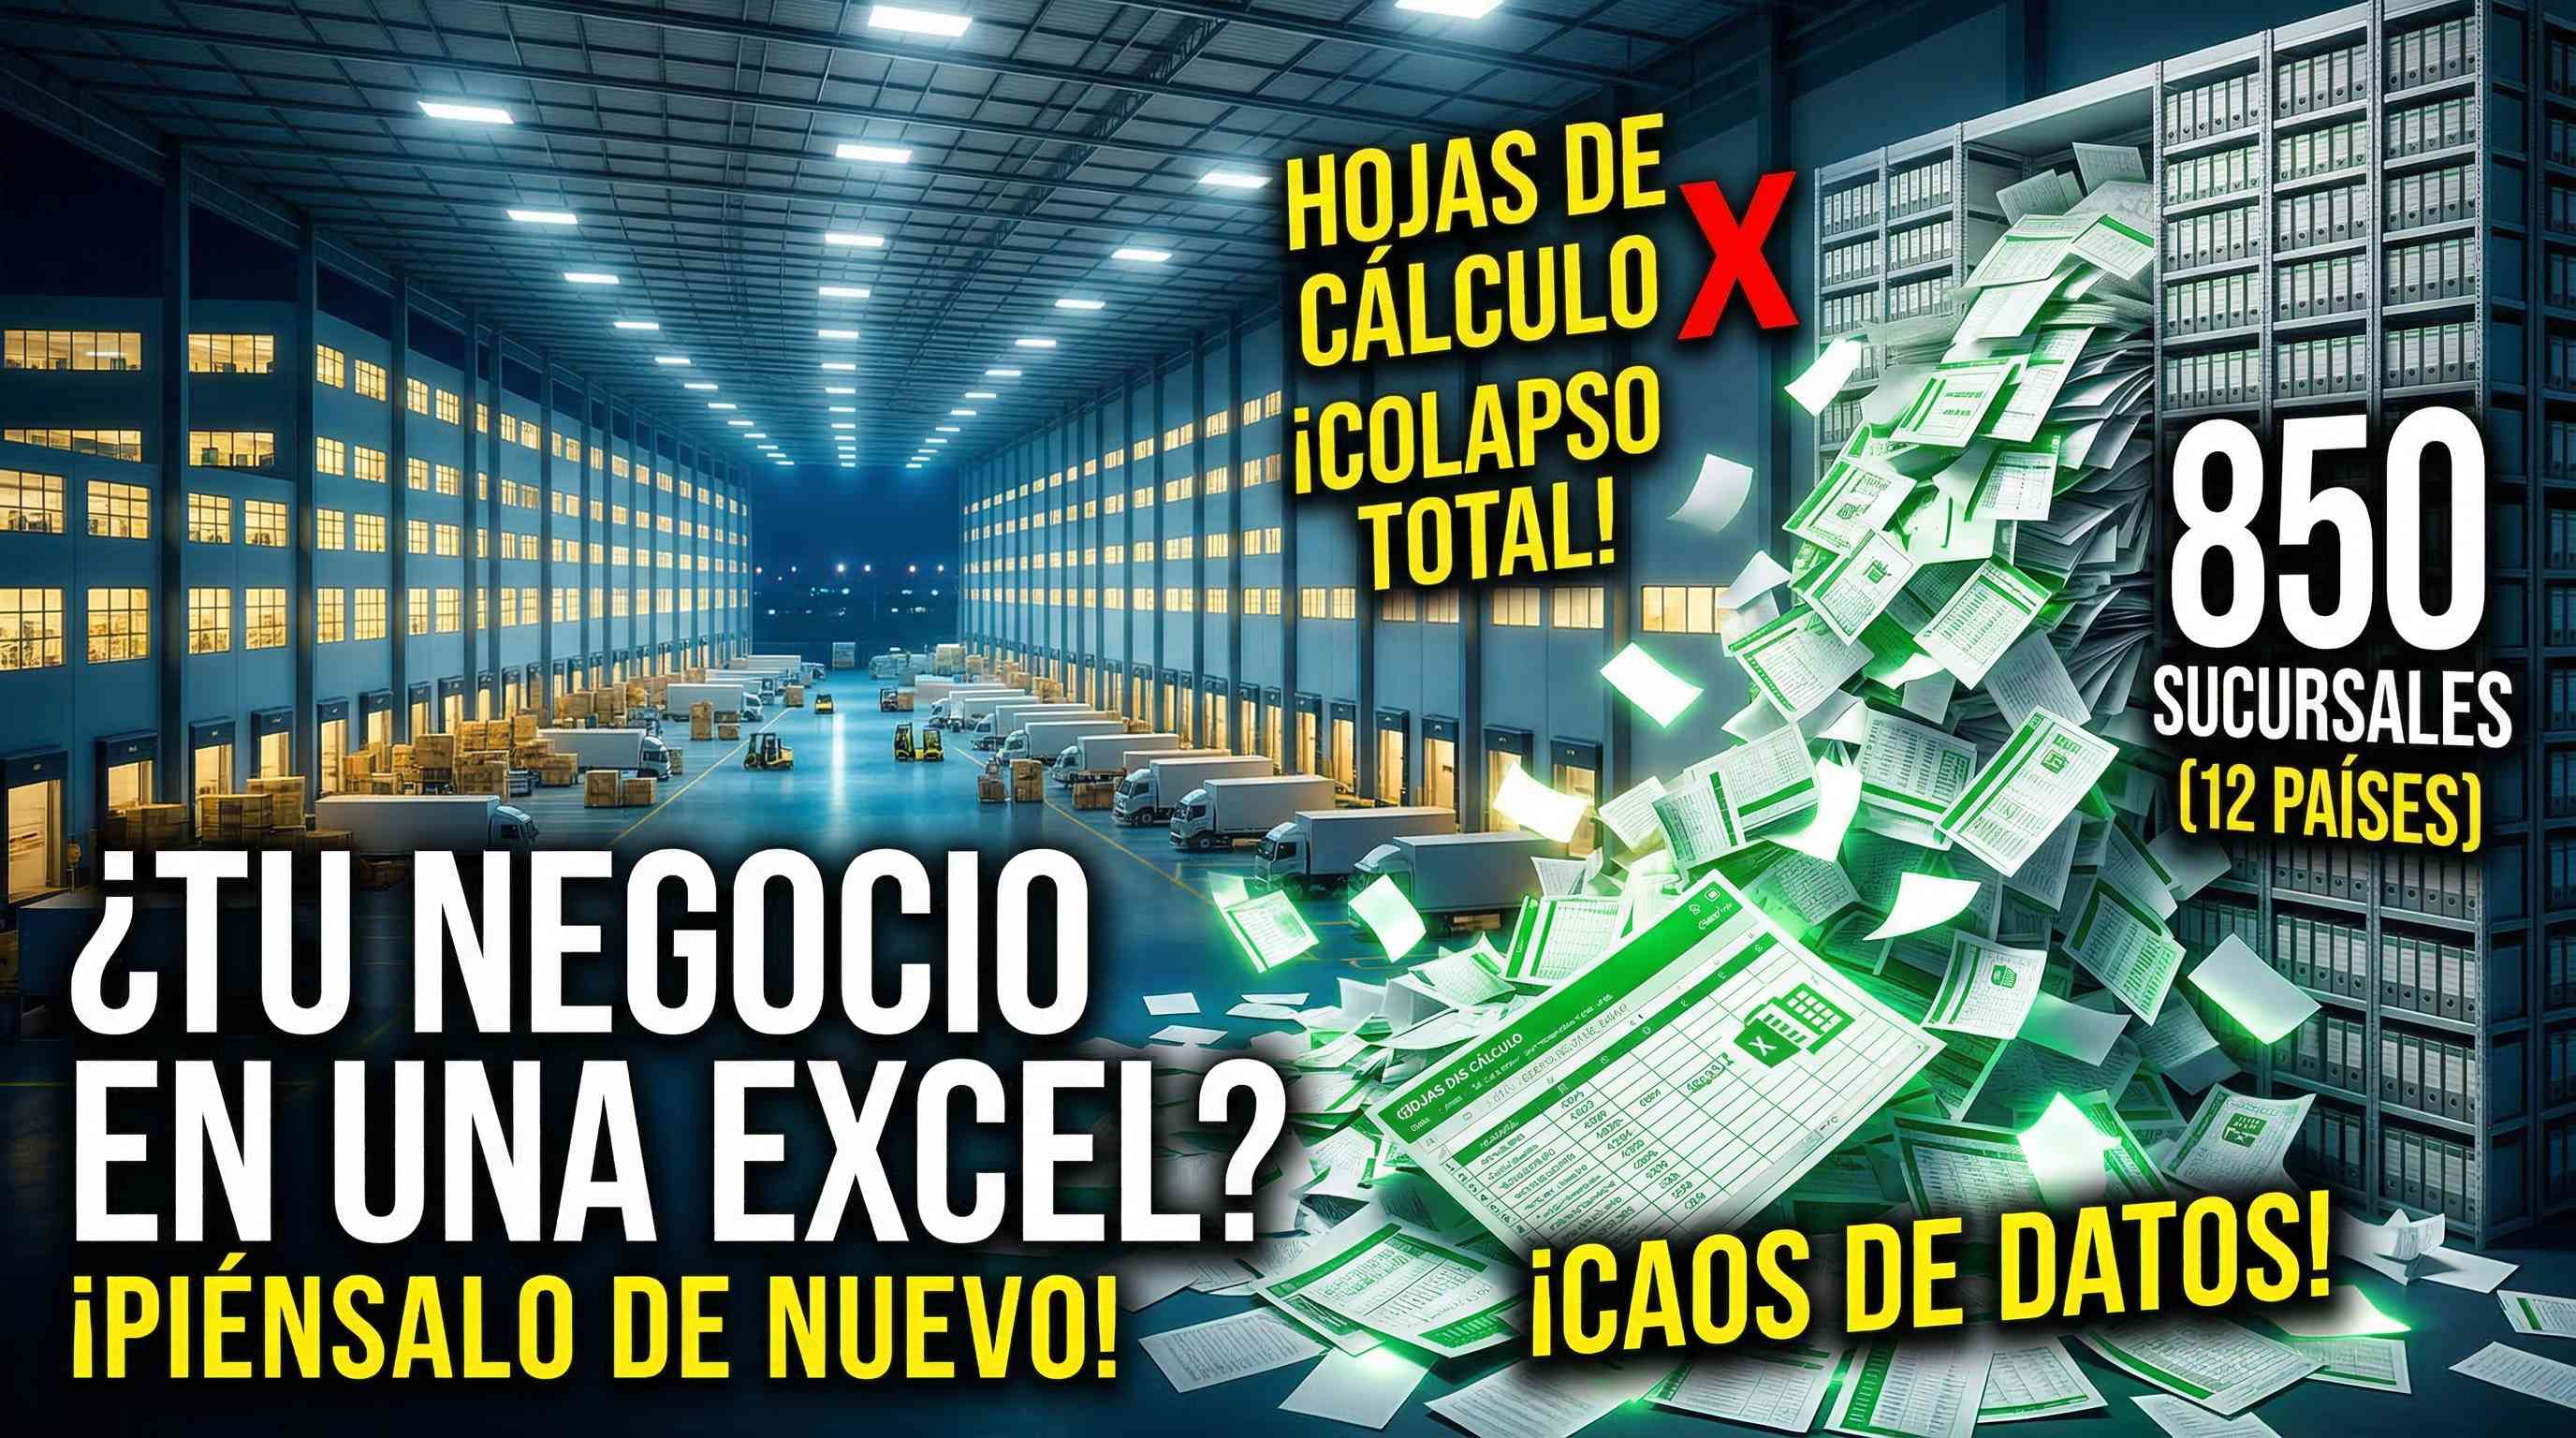
TiendaLatam es una cadena departamental regional con presencia física en doce países de América Latina, más de 850 sucursales y 2.4 millones de clientes registrados [0:33]. No es una tienda en línea: hay empleados que atienden, estantes con productos y cajas registradoras procesando transacciones todos los días.

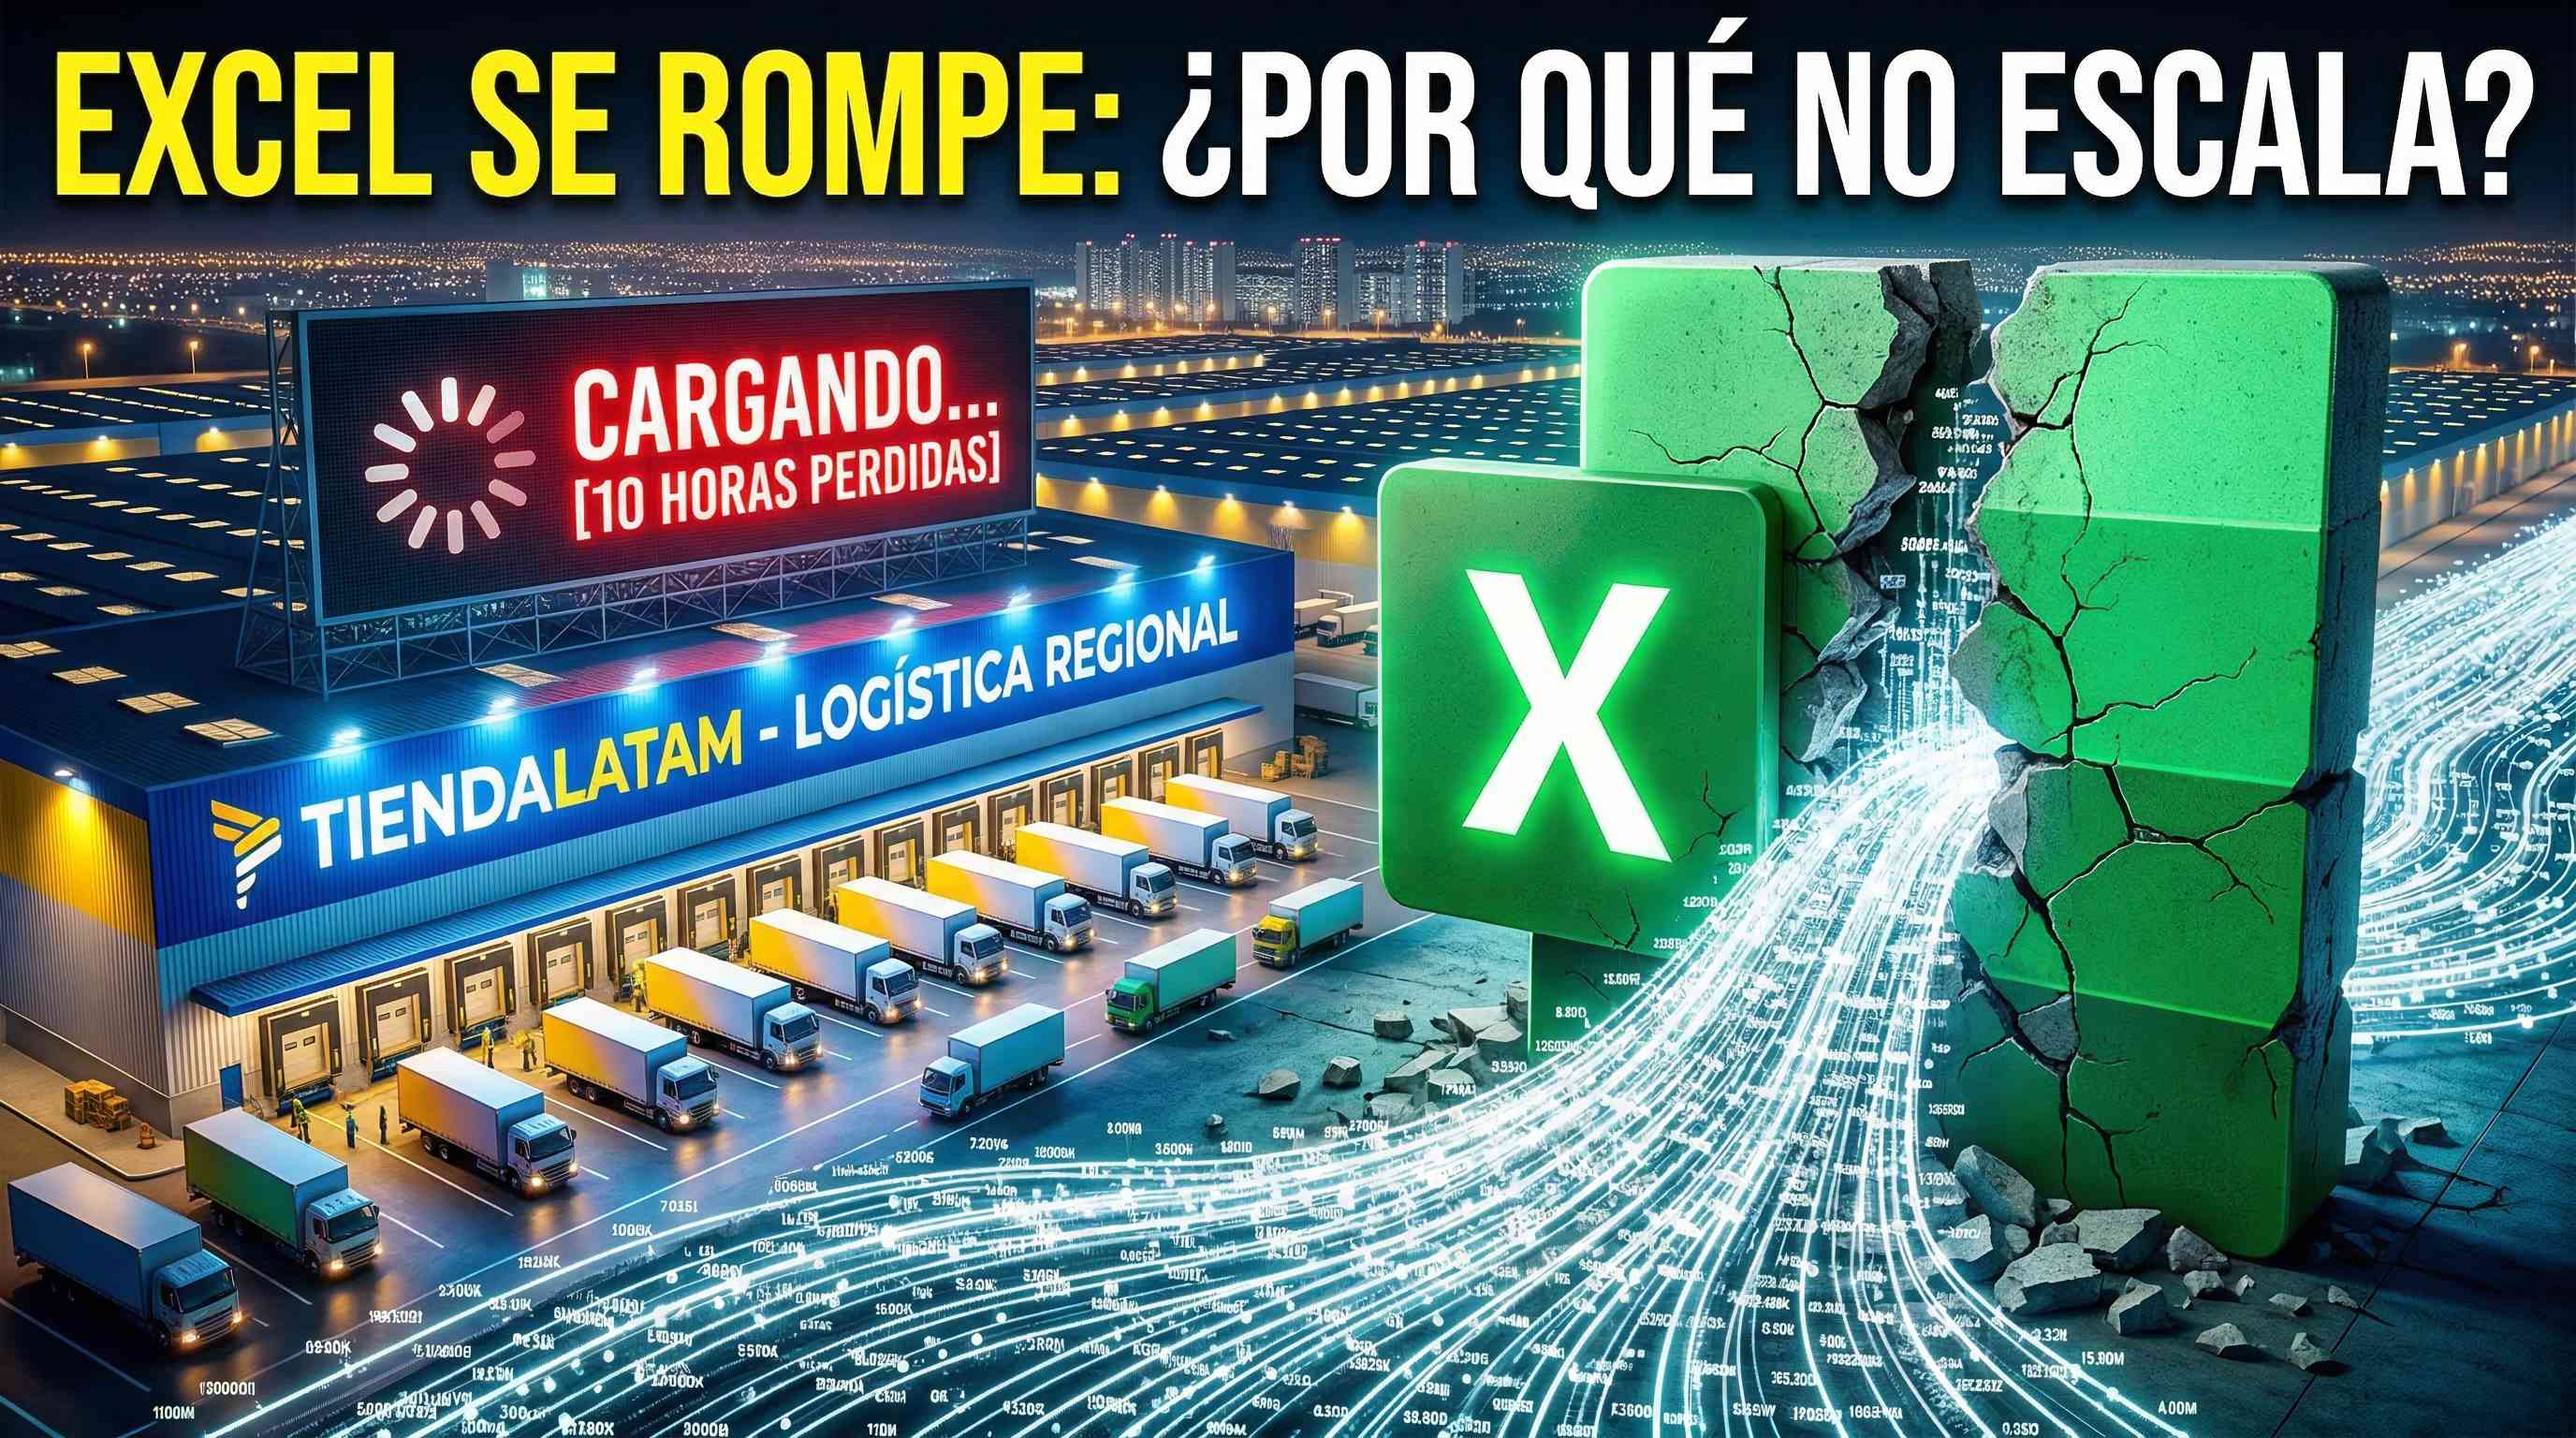
Ahora multipliquen eso por miles de transacciones diarias en doce países distintos. ¿Se imaginan manejando esa información en una hoja de cálculo? No funciona [1:13]. Exactamente ahí es donde entra el diseño de bases de datos.

¿Cuáles son los cuatro procesos que generan datos?

Dentro de TiendaLatam existen cuatro procesos clave que producen información [0:22]:

  • Gestión de catálogo: qué productos se venden, a qué precio y en qué categoría [0:25].
  • Gestión de clientes: quién compra, con qué frecuencia y qué tipo de cliente es —regular, premium o mayorista— [0:34].
  • Procesamiento de pedidos: cada compra registra qué se compró, cuánto, cuándo, en qué sucursal y qué empleado atendió. Cada "bip" en la caja es un dato [0:43].
  • Operaciones de sucursales: dónde está cada tienda, en qué país y quiénes trabajan ahí [1:57].

Sin estos datos, la empresa opera a ciegas.

¿Por qué se dejan fuera pagos, envíos e inventario?

A propósito se excluyen aspectos como pagos, envíos, inventario detallado y nómina [2:05]. La razón es sencilla: primero se construyen los cimientos de una casa antes de instalar la domótica. El alcance inicial se limita a lo esencial para aprender los fundamentos.

¿Qué son las entidades y cómo se clasifican?

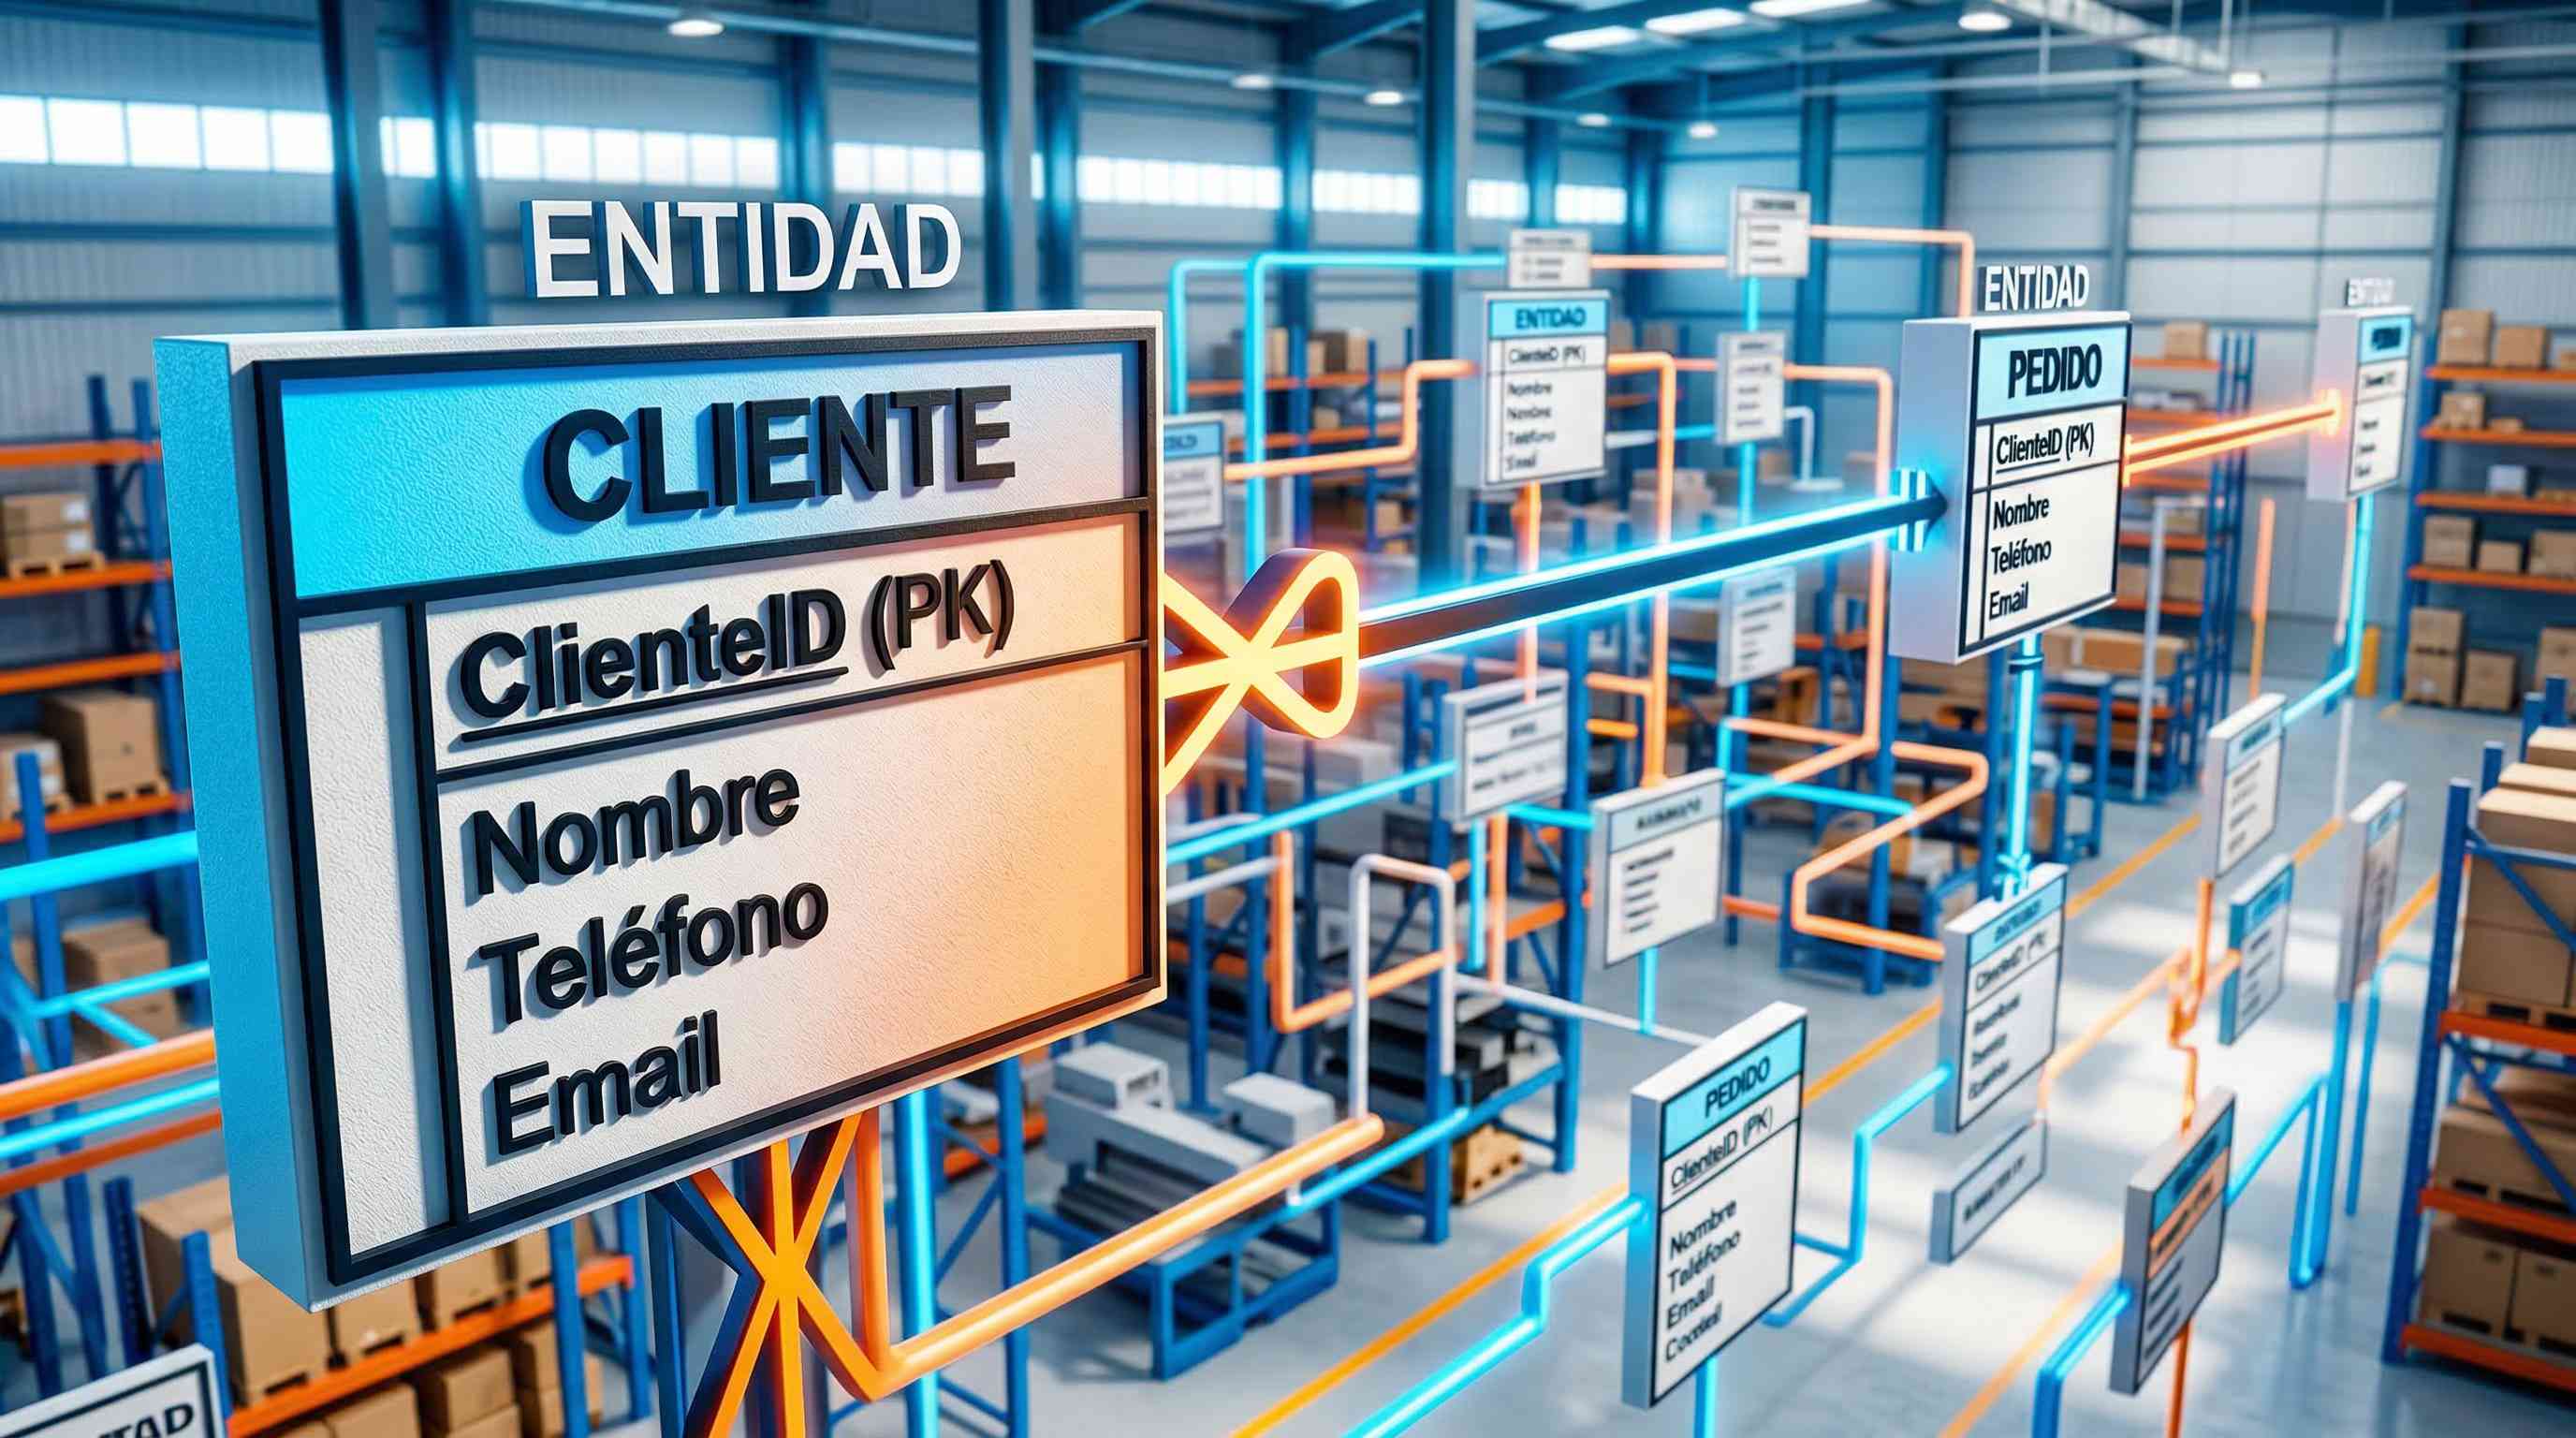
Antes de crear una sola tabla hay que identificar las entidades del negocio. Una entidad es simplemente una "cosa" del mundo real sobre la cual se necesita guardar información [2:19]. Lo interesante es que no todas las entidades son iguales; se dividen en tres tipos [2:30]:

  • Entidades de contexto: el telón de fondo, lo que casi nunca cambia. Países, categorías de productos y tipos de cliente.
  • Entidades de actor: las personas y lugares que hacen que las cosas sucedan. Clientes, empleados, sucursales y productos. Cambian con frecuencia moderada.
  • Entidades de transacción: capturan lo que realmente ocurre cuando el negocio funciona. Pedidos y detalles de pedido. Crecen constantemente porque cada venta genera registros nuevos [2:52].

Esta separación importa porque refleja cómo fluye el negocio: un cliente entra a una sucursal en un país, compra productos de una categoría y eso crea un pedido con sus detalles. La estructura de los datos sigue la estructura del negocio, no al revés [3:15].

¿Cuántas tablas se van a construir?

El resultado serán nueve tablas interconectadas [3:19]:

  • Tres de contexto: países, categorías y tipos de cliente.
  • Cuatro de actores: sucursales, empleados, clientes y productos.
  • Dos de transacciones: pedidos y detalle de pedidos.

El punto de partida son nueve archivos CSV, uno por cada tabla. Estos archivos no son independientes: el archivo de sucursales tiene una columna de país, pero la información completa del país vive en otro archivo separado [5:00]. Es como organizar una biblioteca donde, en lugar de repetir los datos de la editorial en cada ficha de libro, se crean fichas separadas y se referencian. Ese principio es exactamente la normalización que se estudiará más adelante [5:28].

¿Cómo se valida que el diseño está bien hecho?

Tres pruebas permiten verificar la calidad del modelo [3:43]:

  • Integridad estructural: si intentan borrar un país que tiene sucursales activas, el sistema debe impedirlo.
  • Rendimiento: preguntar "todos los pedidos de México en marzo" debe dar resultados en segundos, no en horas.
  • Lógica de negocio: ¿puede un pedido contener múltiples productos? ¿Se puede rastrear qué empleado procesó cada venta? Si la respuesta es sí, el diseño va bien.

En la práctica, TiendaLatam necesita saber qué productos funcionan mejor en cada país, cuántos pedidos procesa cada tienda para asignar personal, cómo compran los distintos tipos de clientes y evaluar el rendimiento de cada sucursal para decidir dónde expandirse o qué cerrar [4:09].

¿Qué herramientas se utilizarán?

Se inicia con OneCompiler, una plataforma en el navegador donde se pueden crear tablas y ejecutar consultas sin instalar nada [5:35]. Después, con más confianza, se pasa a SQL Server, lo que se encuentra en entornos profesionales [5:52].

La ruta es clara: primero entender el negocio, luego trabajar con archivos planos y ver sus limitaciones, después construir la estructura relacional —entidades, atributos, relaciones, claves y normalización— y finalmente consultar los datos con SELECT, WHERE, GROUP BY y JOIN [5:55]. Ahí es donde el modelo relacional muestra su verdadero poder: responder preguntas complejas combinando datos de múltiples tablas.

Si les interesa cómo estas nueve entidades se convierten en tablas con atributos y relaciones, eso es precisamente lo que viene a continuación.

Primero el negocio, después el código

Curso de Fundamentos de Bases de Datos

Clase 21 de 33

Clase 21 / 33