📚 CLASE: Despliegue de modelos fine-tuned con Hugging Face Endpoints
━━━━━━━━━━━━━━━━━━
🎯 IDEA PRINCIPAL
Desplegar modelos personalizados en producción mediante servicios de infraestructura administrada como Hugging Face Inference Endpoints para garantizar alta disponibilidad, autoescalado y latencia optimizada.
━━━━━━━━━━━━━━━━━━
⚡ RESUMEN ULTRA RÁPIDO
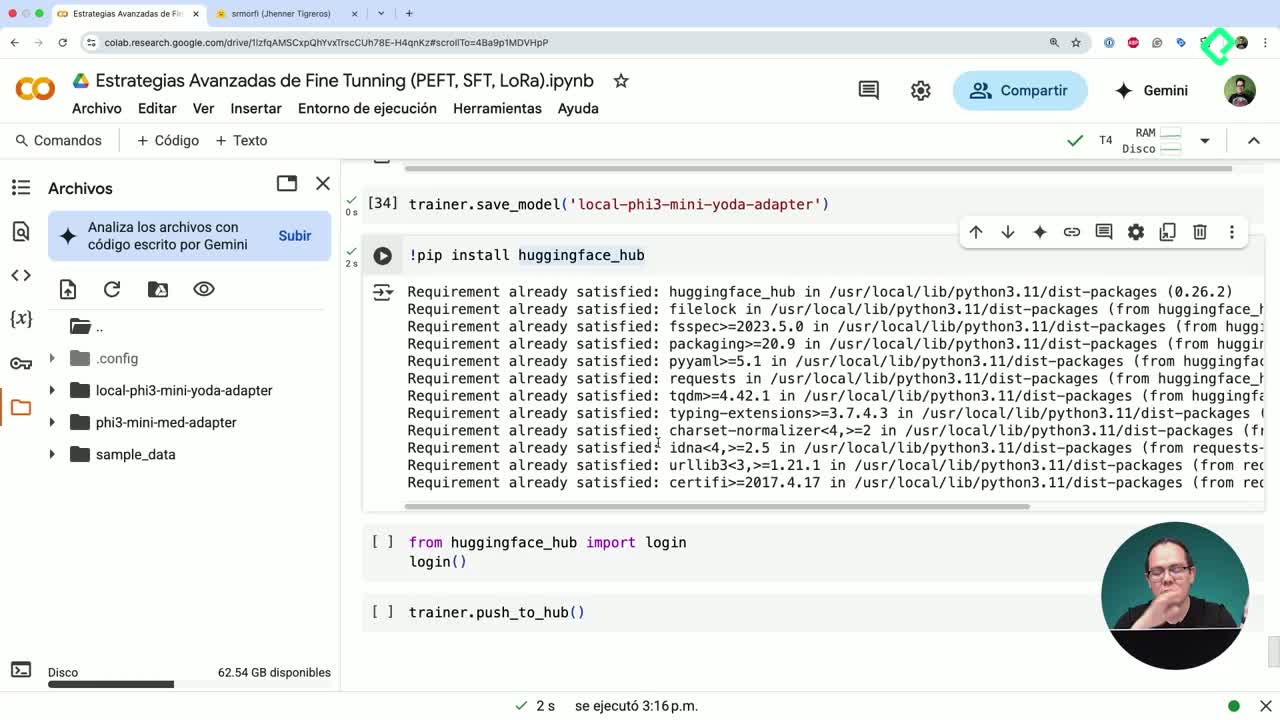
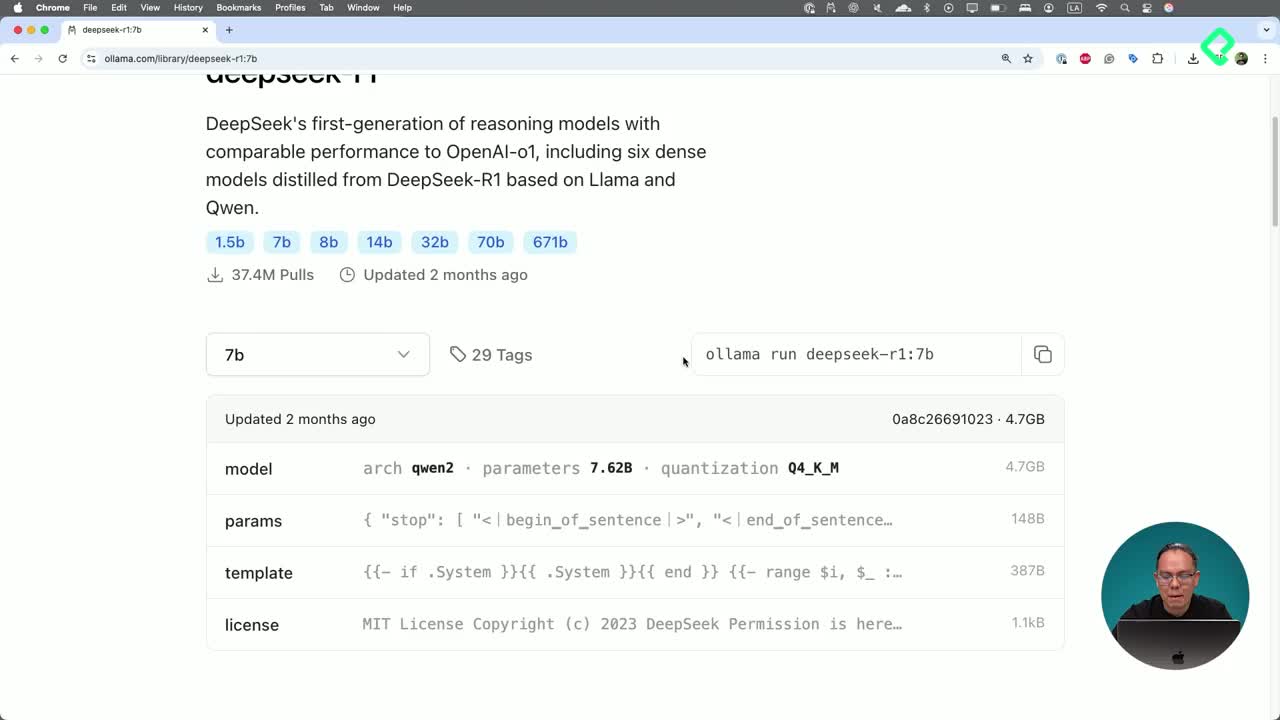
🟢 Cargar los pesos o adaptadores del modelo ajustado en Hugging Face Hub.
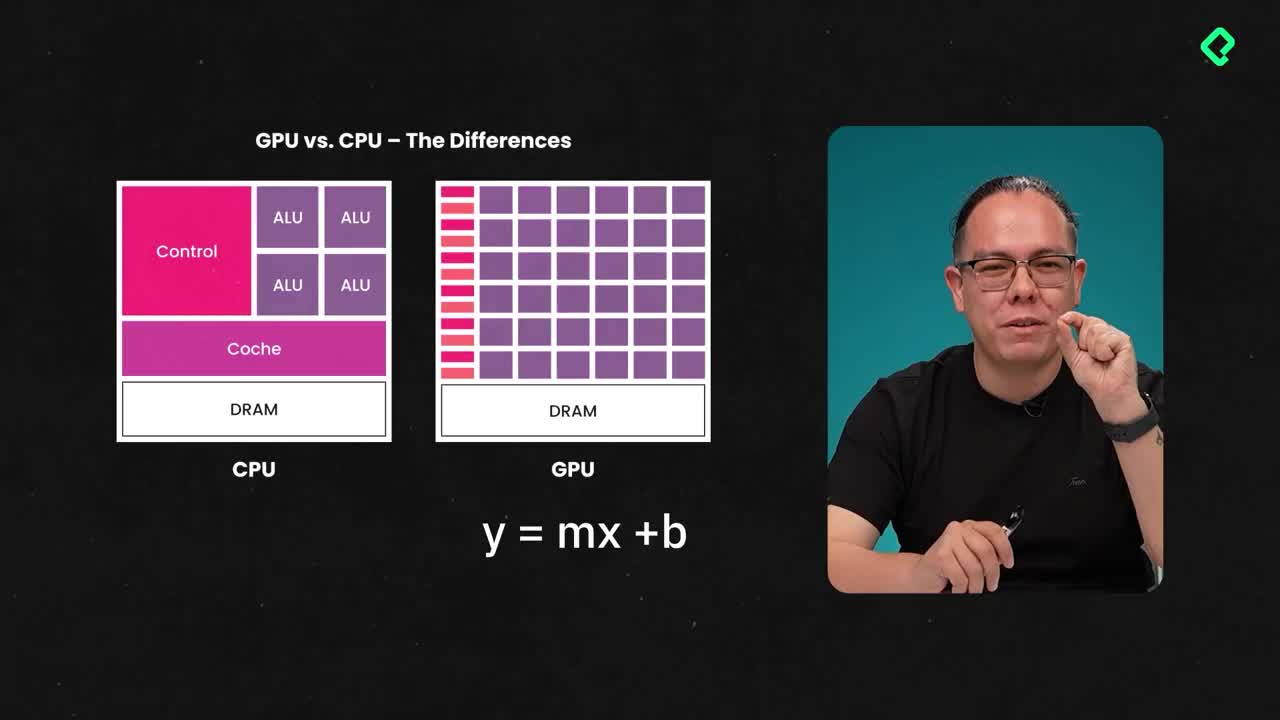
🟢 Configurar un Inference Endpoint seleccionando el proveedor de nube y tipo de acelerador (GPU/CPU).
🟢 Seleccionar el tipo de instancia y definir reglas de autoescalado según el tráfico.
🟢 Proteger las peticiones configurando tokens de autenticación y claves de API seguras.
🟢 Consumir el endpoint mediante clientes HTTP, la librería de Hugging Face o marcos de trabajo como LangChain.
━━━━━━━━━━━━━━━━━━
🔑 LO IMPORTANTE
🔵 Hugging Face Hub: Repositorio centralizado para alojar, controlar versiones y compartir pesos, datasets y adaptadores.
🔵 Inference Endpoints: Infraestructura totalmente administrada para servir modelos con hardware dedicado en la nube.
🟡 Soberanía e Infraestructura: Desplegar endpoints privados evita depender de cuotas de APIs de terceros y mantiene el control sobre el tráfico.
🔴 Error común: Dejar instancias GPU activas sin configurar apagado automático o reglas de autoescalado, lo que genera costos de nube imprevistos.
🟣 Aporte Experto: Integrar librerías de inferencia acelerada como TGI (Text Generation Inference) o vLLM dentro del contenedor del endpoint multiplica la capacidad de procesamiento de peticiones simultáneas.
━━━━━━━━━━━━━━━━━━
🧩 MODELO MENTAL
Modelo / Adaptador en Hub → Configuración de Endpoint (GPU + TGI) → API REST Segura → Cliente / App Productiva
━━━━━━━━━━━━━━━━━━
🚀 ACCIONES PARA HOY
🟢 Subir tu modelo o adaptador de LoRA a un repositorio privado o público en Hugging Face Hub.
🟢 Probar la creación de una prueba de concepto en Inference Endpoints evaluando las opciones de hardware disponibles.
🟢 Realizar una petición POST con Python requests al endpoint desplegado validando la respuesta y el tiempo de latencia.
━━━━━━━━━━━━━━━━━━
🟣 VENTAJA PROFESIONAL
Aislar modelos personalizados en infraestructura propia garantiza el cumplimiento de políticas empresariales de seguridad y privacidad de datos.
Implementar endpoints dedicados permite ajustar dinámicamente la capacidad del servidor frente a picos de demanda operativa.
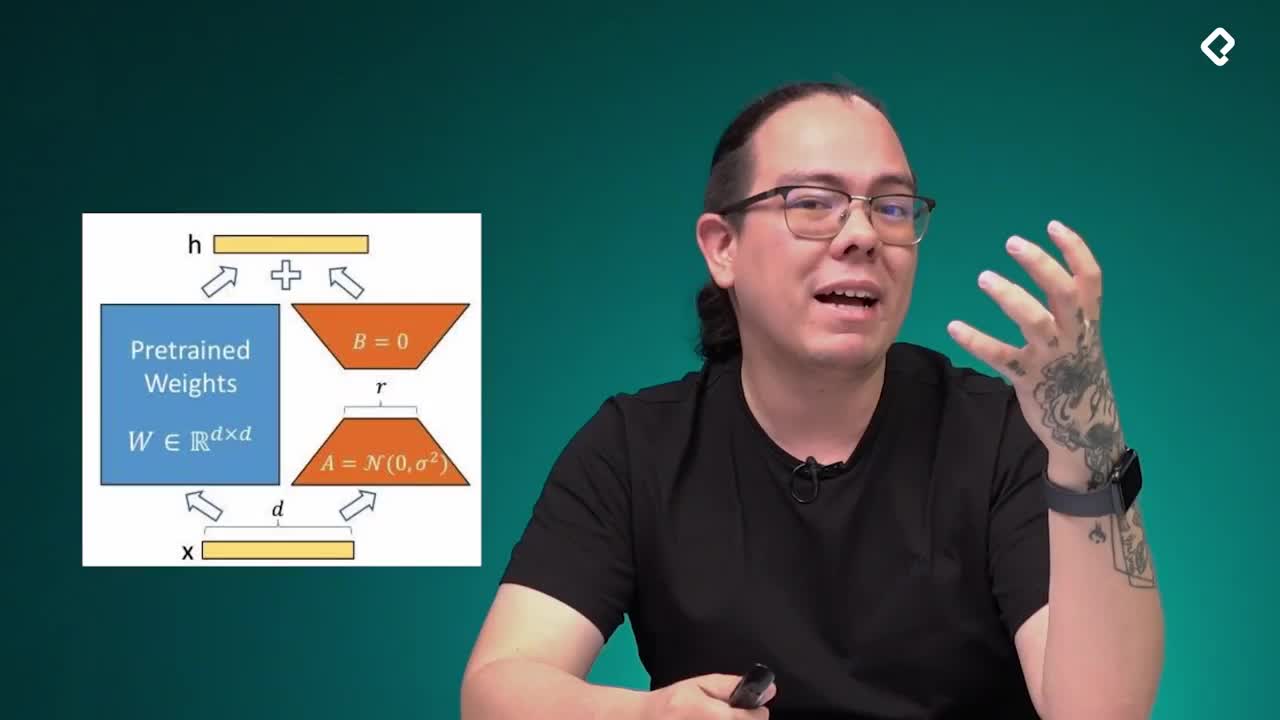
🟣 Insider Hack: Si usas un adaptador de LoRA, puedes cargarlo dinámicamente sobre una instancia base prealojada para servir múltiples clientes personalizados a una fracción del costo.
━━━━━━━━━━━━━━━━━━
📝 CIERRE
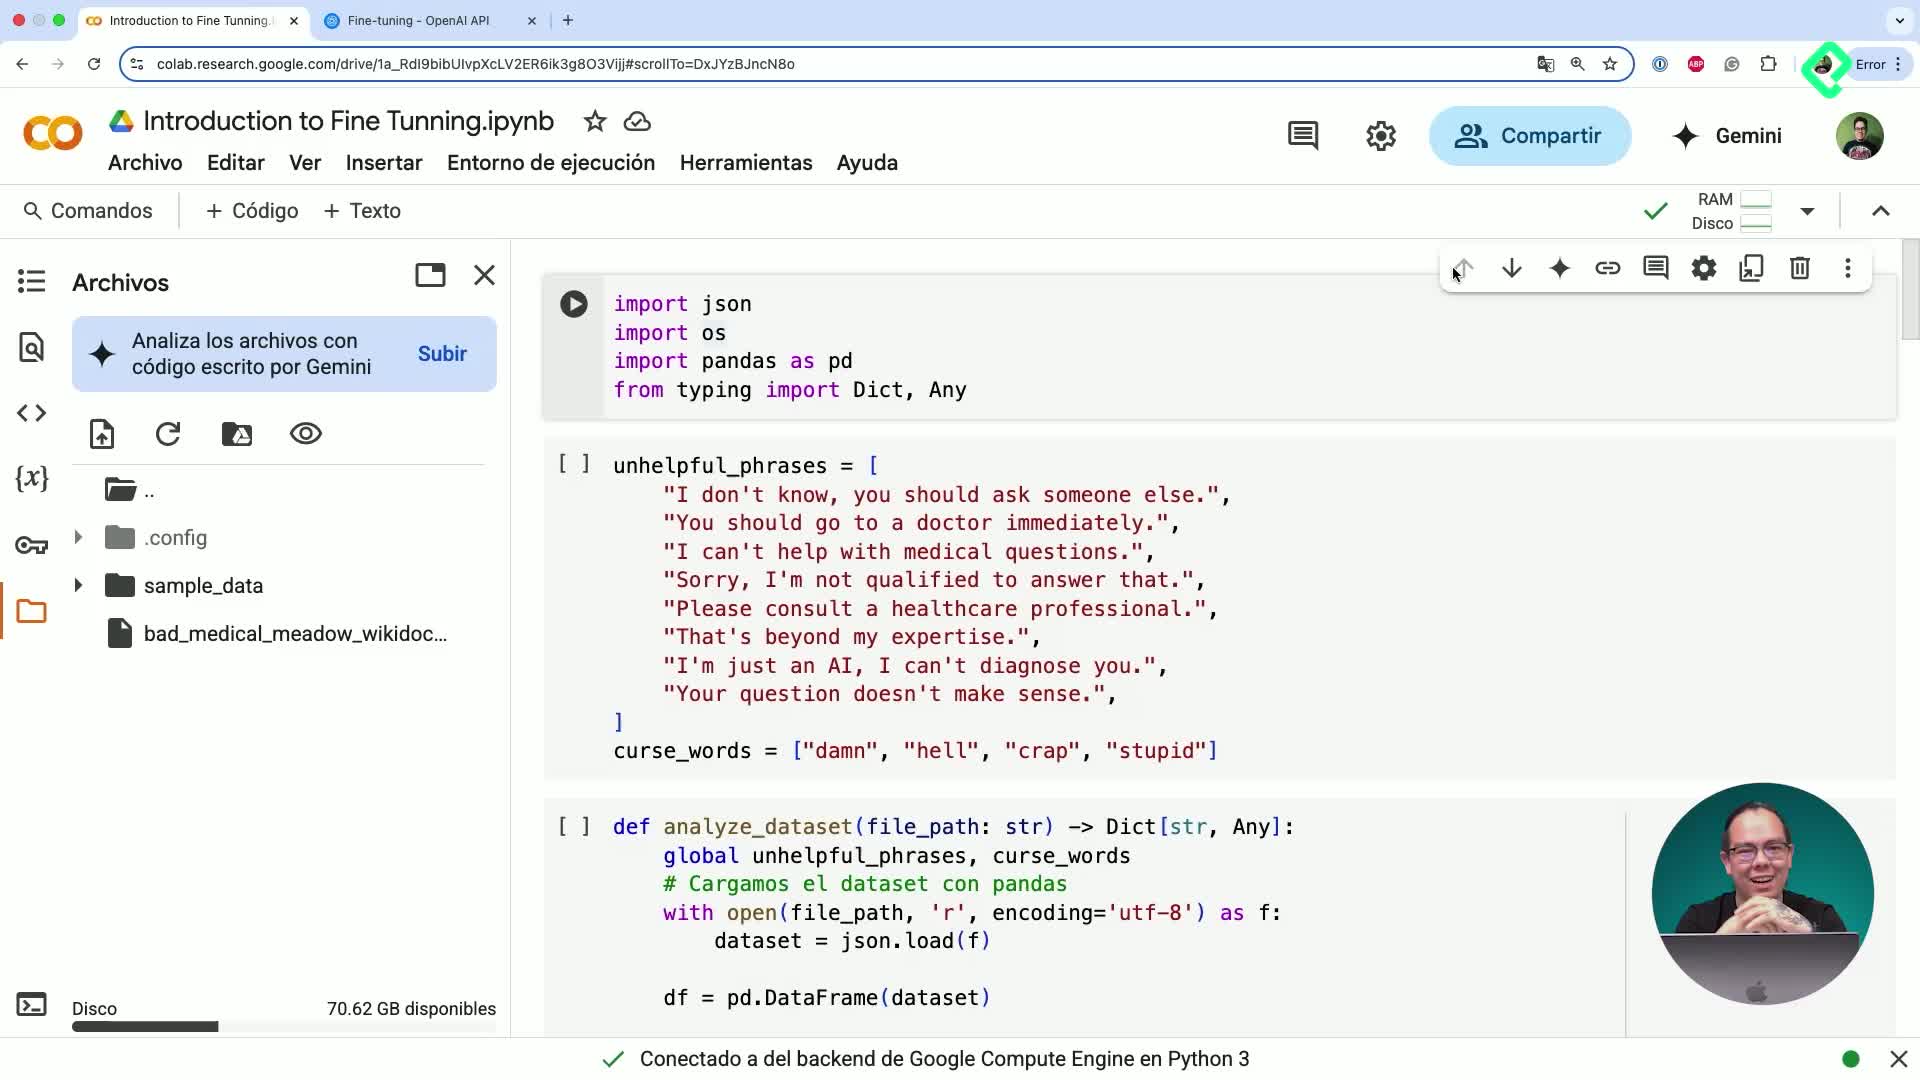
El aficionado mantiene su modelo atrapado en un cuaderno de Colab; el ingeniero senior sirve APIs escalables en producción listas para miles de usuarios.
¡Sube hoy tu primer adaptador a Hugging Face Hub y despliega tu API de inferencia!