PyTorch es un framework robusto creado por Meta, anteriormente Facebook, diseñado específicamente para construir modelos de machine learning y deep learning. Ofrece recursos variados y librerías que facilitan desarrollar arquitecturas neuronales complejas desde cero o con cierta base previa.
¿Qué es un tensor en PyTorch?
El elemento central de PyTorch es el tensor, una estructura similar a una lista, vector o matriz en Python. Básicamente, se trata de una estructura n-dimensional manejada internamente según filas y columnas requeridas para almacenar datos numéricos. En machine learning, estos tensores constituyen la base sobre la que se procesan los modelos.
¿Cuál es el rol de Autograd en PyTorch?
Un aspecto fundamental de PyTorch es Autograd, un sistema computacional diseñado para realizar automáticamente la derivación parcial. Sin Autograd, los cálculos de derivadas parciales para modelos grandes consumirían demasiado tiempo manualmente. Con este mecanismo, PyTorch automatiza estos procedimientos mediante aproximaciones que facilitan notablemente la creación y ajuste de modelos avanzados.
¿Qué es el optimizer y cómo ayuda a entrenar modelos?
El optimizer es otro componente clave que maneja el aprendizaje del modelo mediante métodos específicos como el popular algoritmo Adam. Este realiza ajustes internos (por ejemplo, utilizando back propagation) y determina el learning rate, ayudando a que el modelo supere mínimos locales y optimizando su aprendizaje.
Tipos de optimizadores disponibles:
Adam
Adam X
Adam W
Adam Z
¿Cómo implementar un modelo MLP con PyTorch paso a paso?
Utilizando PyTorch, la creación de un modelo Multi Layer Perceptron (MLP) sigue estos pasos simples pero indispensables:
Importación y configuración:
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F
import time
Definir la arquitectura de red neuronal:
classMLP(nn.Module):def__init__(self, input_dim, hidden_dim, output_dim):super(MLP, self).__init__() self.layer1 = nn.Linear(input_dim, hidden_dim) self.layer2 = nn.Linear(hidden_dim, output_dim)defforward(self, x): x = F.relu(self.layer1(x)) x = self.layer2(x)return x
Entrenamiento y optimización:
Instanciar el modelo con dimensiones específicas.
Elegir la función de pérdida (error cuadrático medio).
Seleccionar un optimizer, frecuentemente Adam.
Crear datos ficticios y ejecutar entrenamiento.
model = MLP(10,100,1)criterion = nn.MSELoss()optimizer = optim.Adam(model.parameters(), lr=0.01)
¿Es posible entrenar modelos con GPU en PyTorch?
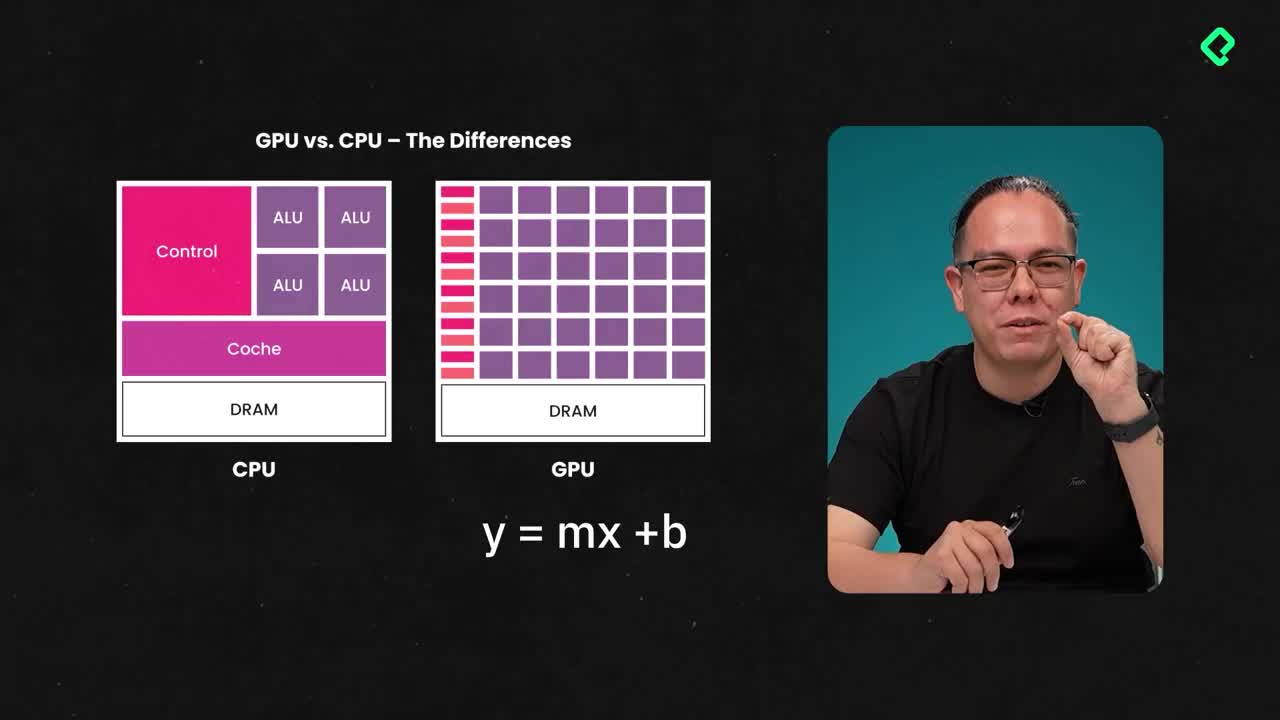
Sí, PyTorch permite usar GPU para acelerar los procesos. El paso para verificar disponibilidad es sencillo:
Luego, transfiriendo nuestros tensores al dispositivo elegido, podemos reducir significativamente los tiempos de procesamiento de grandes conjuntos de datos o arquitecturas más complejas.
Ejemplo práctico de uso con GPU:
x = torch.randn(2000000,10).to(device)y = torch.randn(2000000,1).to(device)
Te invitamos a dejar tu comentario sobre cualquier punto adicional sobre PyTorch o la implementación de modelos avanzados que te interese explorar más a fondo.
Fundamentos de PyTorch para modelos de machine learning
PyTorch es un framework robusto creado por Meta, anteriormente Facebook, diseñado específicamente para construir modelos de machine learning y deep learning. Ofrece recursos variados y librerías que facilitan desarrollar arquitecturas neuronales complejas desde cero o con cierta base previa.
¿Qué es un tensor en PyTorch?
El elemento central de PyTorch es el tensor, una estructura similar a una lista, vector o matriz en Python. Básicamente, se trata de una estructura n-dimensional manejada internamente según filas y columnas requeridas para almacenar datos numéricos. En machine learning, estos tensores constituyen la base sobre la que se procesan los modelos.
¿Cuál es el rol de Autograd en PyTorch?
Un aspecto fundamental de PyTorch es Autograd, un sistema computacional diseñado para realizar automáticamente la derivación parcial. Sin Autograd, los cálculos de derivadas parciales para modelos grandes consumirían demasiado tiempo manualmente. Con este mecanismo, PyTorch automatiza estos procedimientos mediante aproximaciones que facilitan notablemente la creación y ajuste de modelos avanzados.
¿Qué es el optimizer y cómo ayuda a entrenar modelos?
El optimizer es otro componente clave que maneja el aprendizaje del modelo mediante métodos específicos como el popular algoritmo Adam. Este realiza ajustes internos (por ejemplo, utilizando back propagation) y determina el learning rate, ayudando a que el modelo supere mínimos locales y optimizando su aprendizaje.
Tipos de optimizadores disponibles:
Adam
Adam X
Adam W
Adam Z
¿Cómo implementar un modelo MLP con PyTorch paso a paso?
Utilizando PyTorch, la creación de un modelo Multi Layer Perceptron (MLP) sigue estos pasos simples pero indispensables:
Importación y configuración:
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F
import time
Definir la arquitectura de red neuronal:
class MLP(nn.Module):
    def __init__(self, input_dim, hidden_dim, output_dim):
        super(MLP, self).__init__()
        self.layer1 = nn.Linear(input_dim, hidden_dim)
        self.layer2 = nn.Linear(hidden_dim, output_dim)

    def forward(self, x):
        x = F.relu(self.layer1(x))
        x = self.layer2(x)
        return x
Entrenamiento y optimización:
Instanciar el modelo con dimensiones específicas.
Elegir la función de pérdida (error cuadrático medio).
Sí, PyTorch permite usar GPU para acelerar los procesos. El paso para verificar disponibilidad es sencillo:
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
Luego, transfiriendo nuestros tensores al dispositivo elegido, podemos reducir significativamente los tiempos de procesamiento de grandes conjuntos de datos o arquitecturas más complejas.
Ejemplo práctico de uso con GPU:
x = torch.randn(2000000, 10).to(device)
y = torch.randn(2000000, 1).to(device)
Te invitamos a dejar tu comentario sobre cualquier punto adicional sobre PyTorch o la implementación de modelos avanzados que te interese explorar más a fondo.
me dolió la cabeza, investigue en internet un poco pero creo que le tome la idea, mi aporte.
conceptos clave:
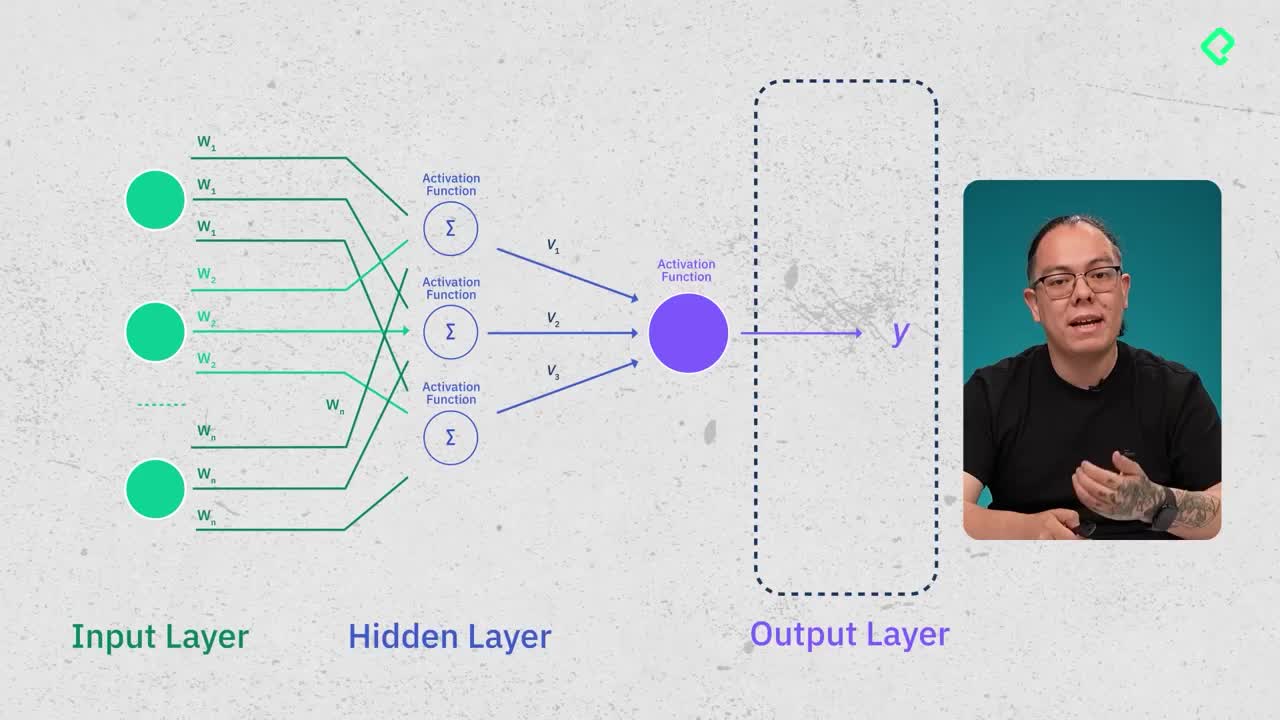
Función de activación: existen muchas y depende del problema que se trata de solucionar, básicamente es un umbral ante el que responde o no una neurona, ¿recuerdan a McFly de volver al futuro?, el no respondía cuando se la montaban, a menos que le dijeran gallina, la función de activación de McFly era esa palabra. (claro no es tan fácil pero se entiende)
Función de coste: como sabes que el modelo esta respondiendo mal? bueno porque sabes la respuesta correcta, la función de coste es la diferencia que hay entre las respuestas azarosas que da el modelo vs las respuestas correctas o esperadas, como es una función se puede graficar, así que empiezas desde el primer valor al azar y vas reajustando hasta que el error sea casi 0, la grafica que se da al hacer esto es el descenso del gradiente.
Backpropagation: es un algoritmo que en términos mas mundanos busca la culpa, empezando por la ultima capa (la de salida), es como esa estrategia de los 5 porqués que creó Honda, empieza a preguntar de pa a atrás capa por capa cual fue la neurona que causo el error y en esa cadena de responsables se ajustan los pesos, como cuando en una empresa algo sale mal y empieza a escalar el problema capa por capa hasta encontrar el responsable
(obviamente no es tan simple, se calculan las derivadas parciales de las funciones de coste y de activación capa por capa)
RuntimeError: Expected all tensors to be on the same device, but found at least two devices, cpu and cuda:0! (when checking argument for argument mat1 in method wrapper_CUDA_addmm)
Y tuve que agregar model.to(device) después de declarar model para que me funcione:
model = MLP(imput_dim=10, hidden_dim=32, output_dim=1)
model.to(device)
Hice un NotebooKLM para poder entender mejor como funciona y le pedi resumen con todas fuentes que encontro y infografias mapas mentales y audio y un video para entenderlo mucho mejor
Los fundamentos de PyTorch se centran en la estructura del tensor, que es una representación n-dimensional similar a listas o matrices. Esta estructura permite realizar cálculos eficientes. PyTorch incluye un mecanismo llamado autograd, que calcula derivadas automáticamente, facilitando el entrenamiento de modelos de machine learning. También cuenta con optimizadores como Adam, que ajustan los parámetros del modelo durante el aprendizaje. Comprender estos conceptos es esencial para construir y entrenar redes neuronales en este framework.