






Me fascinó el curso! Soy alguien apasionado por la IA; considero que es el presente y nos ayuda a hacer que nuestras tareas sean resueltas de manera más eficiente.
¡El tabú de la educación latinoamericana de no usar IA para enseñar debe romperse!
En el mundo de los modelos de lenguaje LLM, elegir el más adecuado puede parecer complicado por la cantidad de alternativas existentes. Modelos como OpenAI, Gemini de Google, Cloud de Anthropic o Mistral presentan cada uno ventajas específicas en diferentes circunstancias y tareas.
¿Qué son los benchmarks y por qué son importantes para evaluar LLM?
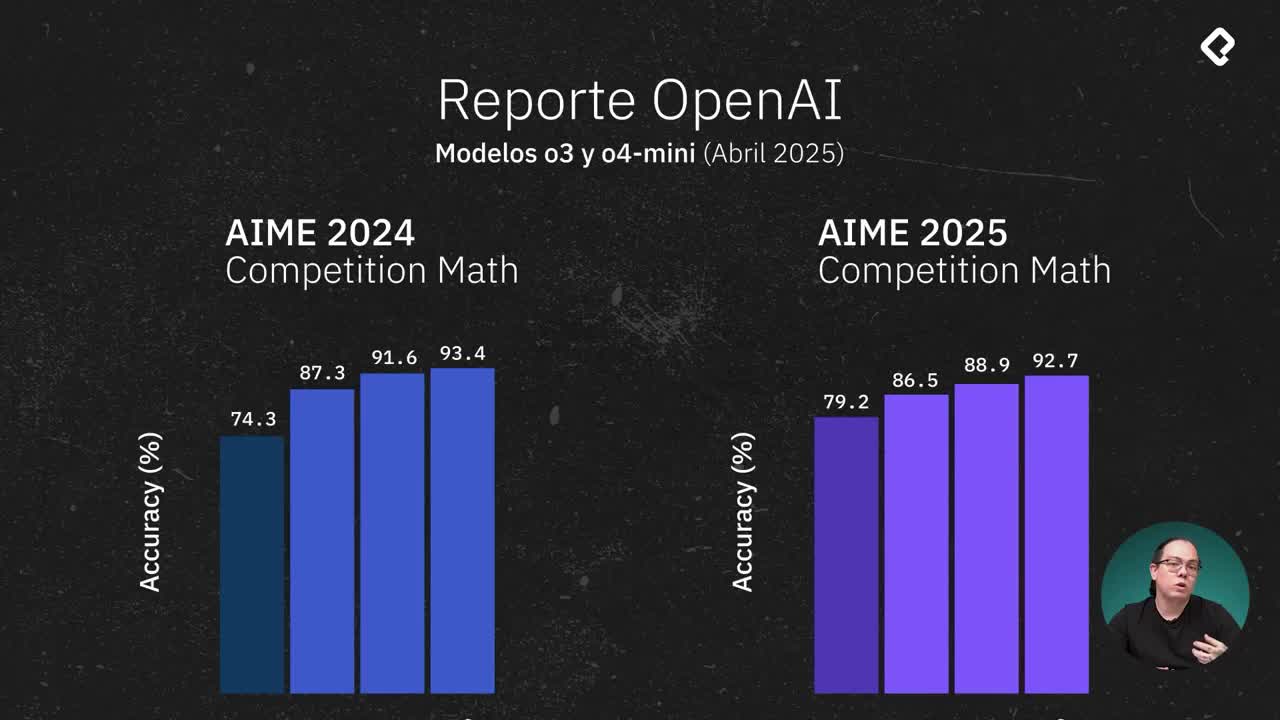
Los benchmarks son pruebas especializadas para medir la eficiencia y precisión de los modelos en diferentes tareas. Al evaluar estos benchmarks puedes decidir objetivamente cuál modelo se adapta mejor a tus necesidades.
Principales benchmarks para matemáticas y lógica
Benchmarks enfocados en conocimientos amplios
Benchmarks para tareas de programación y lógica
Para evaluar habilidades de codificación existen pruebas como: - SWE Bench, que posiciona modelos como Cloud 3.7 Sonet como líderes en programación.
Benchmarks para medición global del razonamiento
¿Cómo utilizar el Chatbot Arena para evaluaciones prácticas?
El Chatbot Arena permite a usuarios evaluar subjetivamente y de manera anónima los distintos modelos, evitando sesgos por marketing o preferencias personales. Este método ofrece una perspectiva más equilibrada y práctica sobre su rendimiento real en el día a día.
¿Cuándo elegir modelos de razonamiento frente a modelos estándar?
Los modelos de razonamiento, como O1, O3, O4 o Gemini 2.5, simulan nuestro método complejo de razonar, ideales para tareas difíciles y razonamientos extensos, aunque implican mayores costos operativos. Por otro lado, los modelos estándar son menos complejos pero más económicos.
Te invito a que explores continuamente cada modelo y utilices estas herramientas y benchmarks especializados para tomar decisiones informadas acorde con tus proyectos y necesidades profesionales. Recuerda seguir las actualizaciones de los principales laboratorios de desarrollo (OpenAI, Google DeepMind, Anthropic) pues cada actualización puede influir significativamente en tu trabajo.
En el mundo de los modelos de lenguaje LLM, elegir el más adecuado puede parecer complicado por la cantidad de alternativas existentes. Modelos como OpenAI, Gemini de Google, Cloud de Anthropic o Mistral presentan cada uno ventajas específicas en diferentes circunstancias y tareas.
Los benchmarks son pruebas especializadas para medir la eficiencia y precisión de los modelos en diferentes tareas. Al evaluar estos benchmarks puedes decidir objetivamente cuál modelo se adapta mejor a tus necesidades.
Para evaluar habilidades de codificación existen pruebas como: - SWE Bench, que posiciona modelos como Cloud 3.7 Sonet como líderes en programación.
El Chatbot Arena permite a usuarios evaluar subjetivamente y de manera anónima los distintos modelos, evitando sesgos por marketing o preferencias personales. Este método ofrece una perspectiva más equilibrada y práctica sobre su rendimiento real en el día a día.
Los modelos de razonamiento, como O1, O3, O4 o Gemini 2.5, simulan nuestro método complejo de razonar, ideales para tareas difíciles y razonamientos extensos, aunque implican mayores costos operativos. Por otro lado, los modelos estándar son menos complejos pero más económicos.
Te invito a que explores continuamente cada modelo y utilices estas herramientas y benchmarks especializados para tomar decisiones informadas acorde con tus proyectos y necesidades profesionales. Recuerda seguir las actualizaciones de los principales laboratorios de desarrollo (OpenAI, Google DeepMind, Anthropic) pues cada actualización puede influir significativamente en tu trabajo.
Me fascinó el curso! Soy alguien apasionado por la IA; considero que es el presente y nos ayuda a hacer que nuestras tareas sean resueltas de manera más eficiente.
¡El tabú de la educación latinoamericana de no usar IA para enseñar debe romperse!
Comparto enlace al Chatbot Arena:
Excelente curso Jhenner Tigreros, Capo Total en IA
Vengo del futuro y Gemini ya tiene mejores modelos que OpenAI desde hace meses.
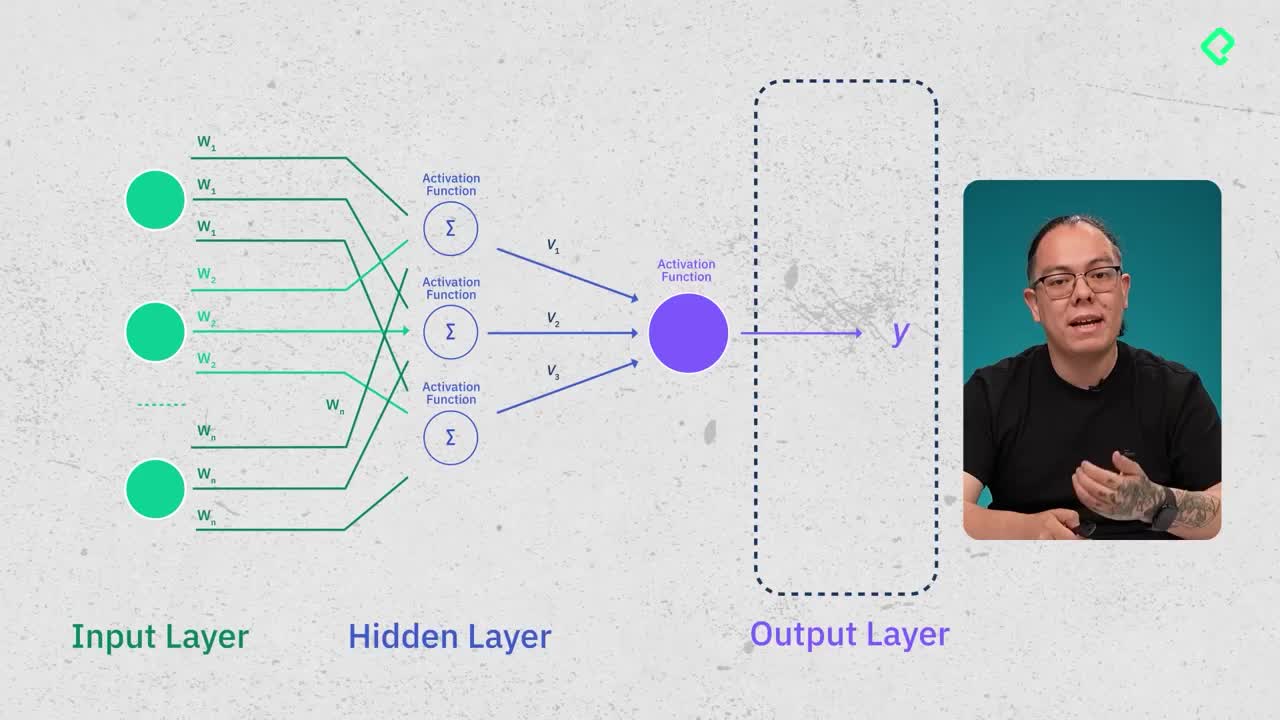
A mi me gustaría explorar en AI así como hemos llegado a actuar como una neurona humana y su activación, la posibilidad de conectar físicamente el cerebro humano con una IA artificial.
Comparto el Chatbot Arena que comenta el profesor para estar actualizados:
LMArena Leaderboard - a Hugging Face Space by lmarena-ai
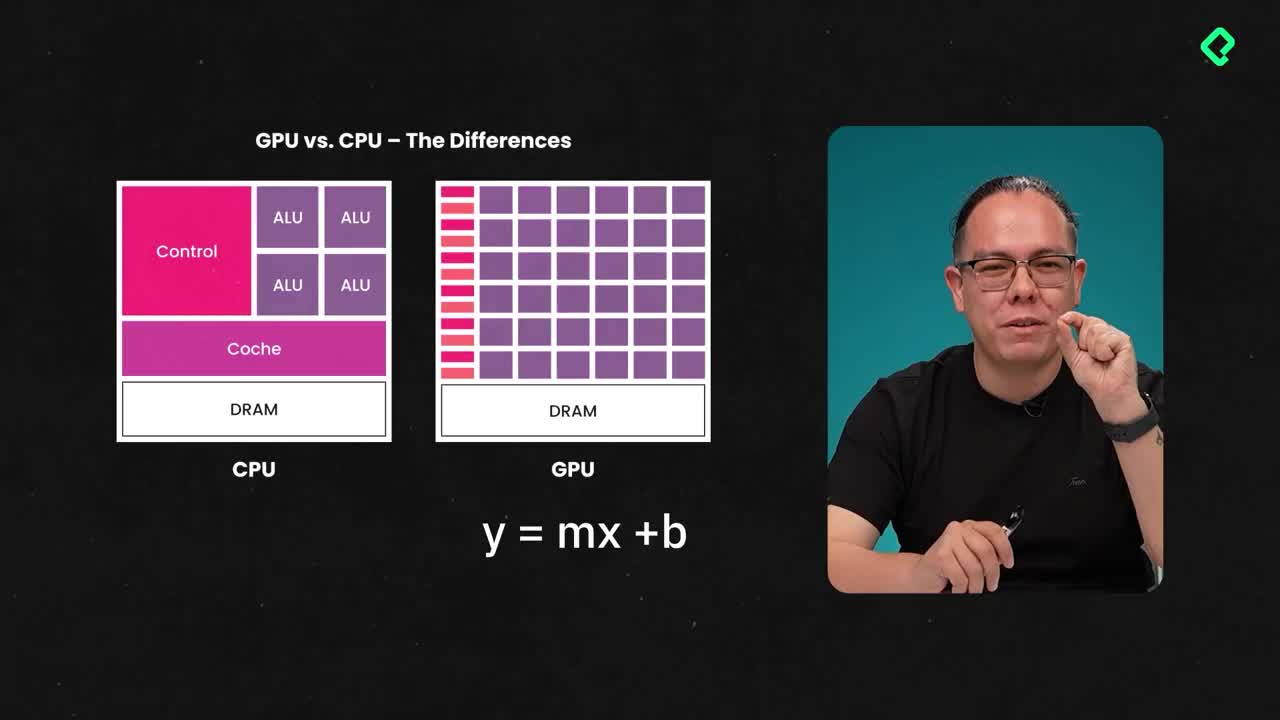
Entrenar un LLM ya no es un privilegio exclusivo de las Big Tech con presupuestos millonarios. El mito de la infraestructura inalcanzable se desmorona ante nuevas técnicas de optimización que permiten ejecutar y ajustar modelos de vanguardia en un simple escritorio, inaugurando la era de la IA local y soberana.
1. Adiós a la Nube: El fin del monopolio de los centros de datos
El entrenamiento de modelos de lenguaje ha dejado de ser terreno exclusivo de los centros de datos masivos. Gracias a QLoRA (Quantized Low Rank Adaptation), hoy es posible realizar el ajuste fino (fine-tuning) de modelos de 7B en hardware doméstico. La NVIDIA RTX 3090 con 24GB de VRAM se ha consolidado como el estándar de oro para este propósito.
La clave estratégica es la reducción de los pesos del modelo de 32 bits a solo 4 bits mediante librerías como bitsandbytes. Esto transforma radicalmente la eficiencia: un modelo que antes demandaba 28 GB de VRAM puede ajustarse ahora con apenas 6 GB. Para consultoras como Q2B Studio, esto representa una ventaja competitiva crítica; permite ofrecer a las empresas soluciones "On-Premise" que evitan el costoso "Cloud Tax" de proveedores como AWS o Azure, manteniendo la agilidad del desarrollo a medida.
"El mito común de que necesitas miles de dólares en cómputo en la nube para ajustar un LLM es falso; con la optimización adecuada, el escritorio es el nuevo centro de datos."
2. Precisión Quirúrgica: El poder de los vectores singulares (SVFT)
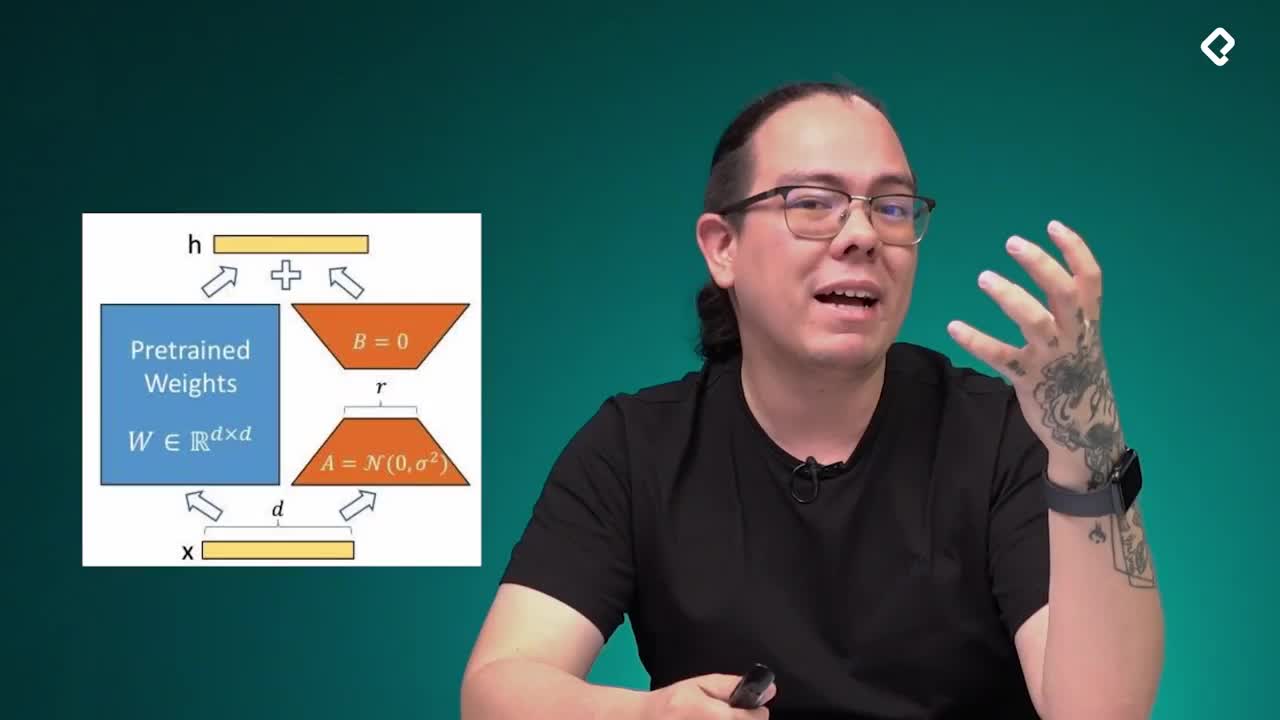
Una de las revelaciones más disruptivas en la ingeniería de parámetros es el método SVFT (Singular Vectors guided Fine-Tuning). A diferencia de LoRA, que añade matrices externas de bajo rango, SVFT utiliza la propia geometría interna de la matriz de pesos original mediante la Descomposición en Valores Singulares (SVD).
Desde una perspectiva estratégica, SVFT ofrece una ventaja matemática superior: para un mismo presupuesto de parámetros, SVFT induce una perturbación de mayor rango (higher-rank perturbation) que LoRA. Al actualizar una combinación dispersa (sparsity patterns) de sus propios vectores singulares (U,Σ,VT), el modelo mantiene una expresividad mucho más amplia. Los datos son contundentes: SVFT logra recuperar el 96% del rendimiento de un entrenamiento completo utilizando tan solo entre el 0.006% y el 0.25% de los parámetros.
3. Privacidad y Soberanía: Tu IA, tus reglas (Ollama)
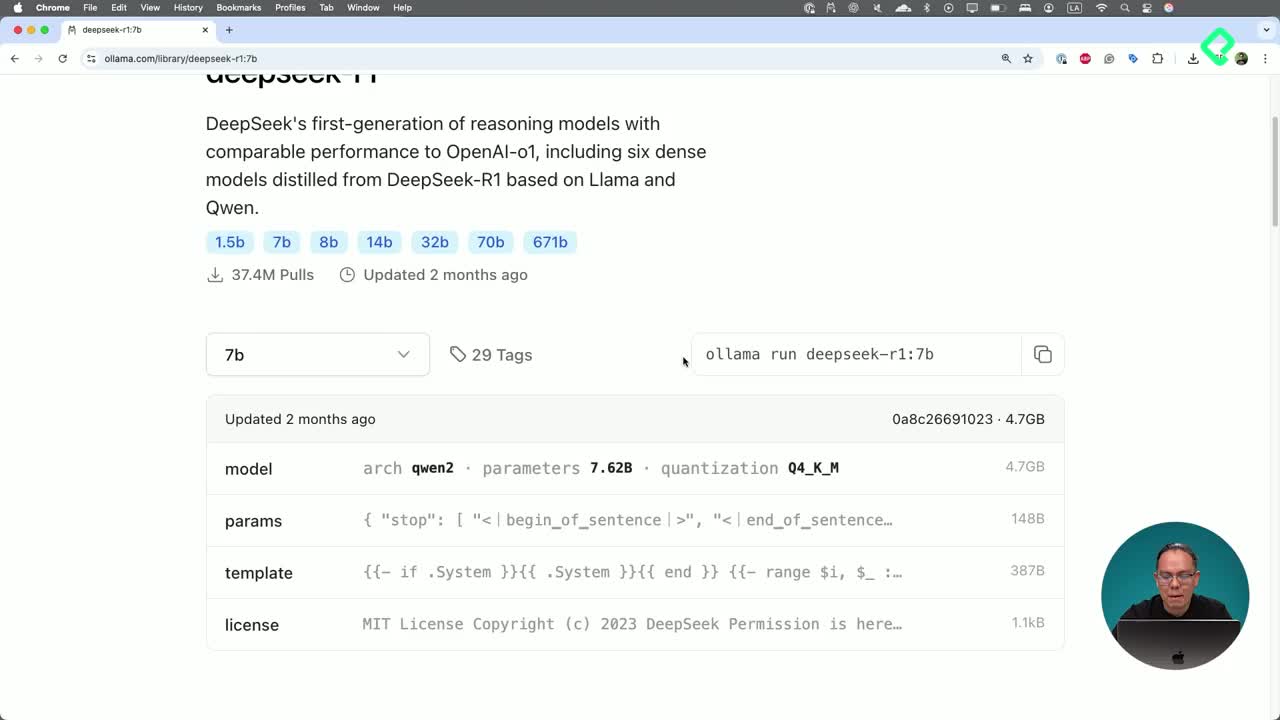
En el panorama actual, la Soberanía del Dato es el activo más valioso. Herramientas como Ollama han surgido como el centro neurálgico para ejecutar LLMs locales, eliminando la dependencia de APIs de terceros como OpenAI o Gemini, donde la privacidad es siempre una incógnita.
Es fundamental entender la arquitectura del "stack" local: mientras que llama.cpp es el motor de inferencia de alto rendimiento, Ollama actúa como la interfaz que orquesta el sistema. Para una experiencia profesional completa, la recomendación estratégica es integrar Open WebUI, proporcionando una interfaz gráfica de nivel empresarial. Las funciones clave incluyen:
• Gestión de Modelos: Descarga y actualización simplificada desde bibliotecas locales.
• Servidor API integrado: Integración programática segura para aplicaciones internas.
• Aislamiento total: Ejecución 100% offline para datos sensibles o entornos regulados.
4. El Arte de la Cuantización: Inteligencia en miniatura
La cuantización es el proceso de transformar números de coma flotante en enteros, permitiendo que un modelo de 100 GB se reduzca a 25 GB sin sacrificar su esencia cognitiva. Sin embargo, no toda la cuantización es igual.
Existen dos enfoques principales con implicaciones directas en el rendimiento: la cuantización simétrica, que utiliza un valor absoluto máximo (alfa) con el cero en el centro, y la cuantización asimétrica, que mapea un rango específico (0-255). La elección entre ambas depende de cómo el estratega decida manejar los valores atípicos (outliers); mientras que algunos métodos usan percentiles para ignorar ruidos, otros emplean el Error Cuadrático Medio (MSE) para minimizar la distorsión. Esta sintonía fina es la que permite que hardware modesto ejecute modelos que antes parecían imposibles.
5. El Lenguaje es un Mapa: Embeddings y la Geometría del Pensamiento
Los LLMs no procesan palabras, sino vectores numéricos en un espacio multidimensional. Esta estructura permite que el lenguaje se comporte como una red de relaciones geométricas donde la semántica se puede operar matemáticamente.
Bajo este enfoque, podemos realizar "aritmética de conceptos": por ejemplo, el vector resultante de "Mamá" menos "género" equivale a "pariente", o "Regente" más "mujer" nos lleva a "reina". Esta comprensión profunda se logra mediante el mecanismo de atención, que podemos desglosar en una tríada funcional:
• Query (Q): La pregunta o intención de la palabra actual.
• Key (K): La respuesta aproximada de las palabras anteriores.
• Value (V): La modificación real del significado basada en ese contexto.
--------------------------------------------------------------------------------
Conclusión: Un futuro local y abierto
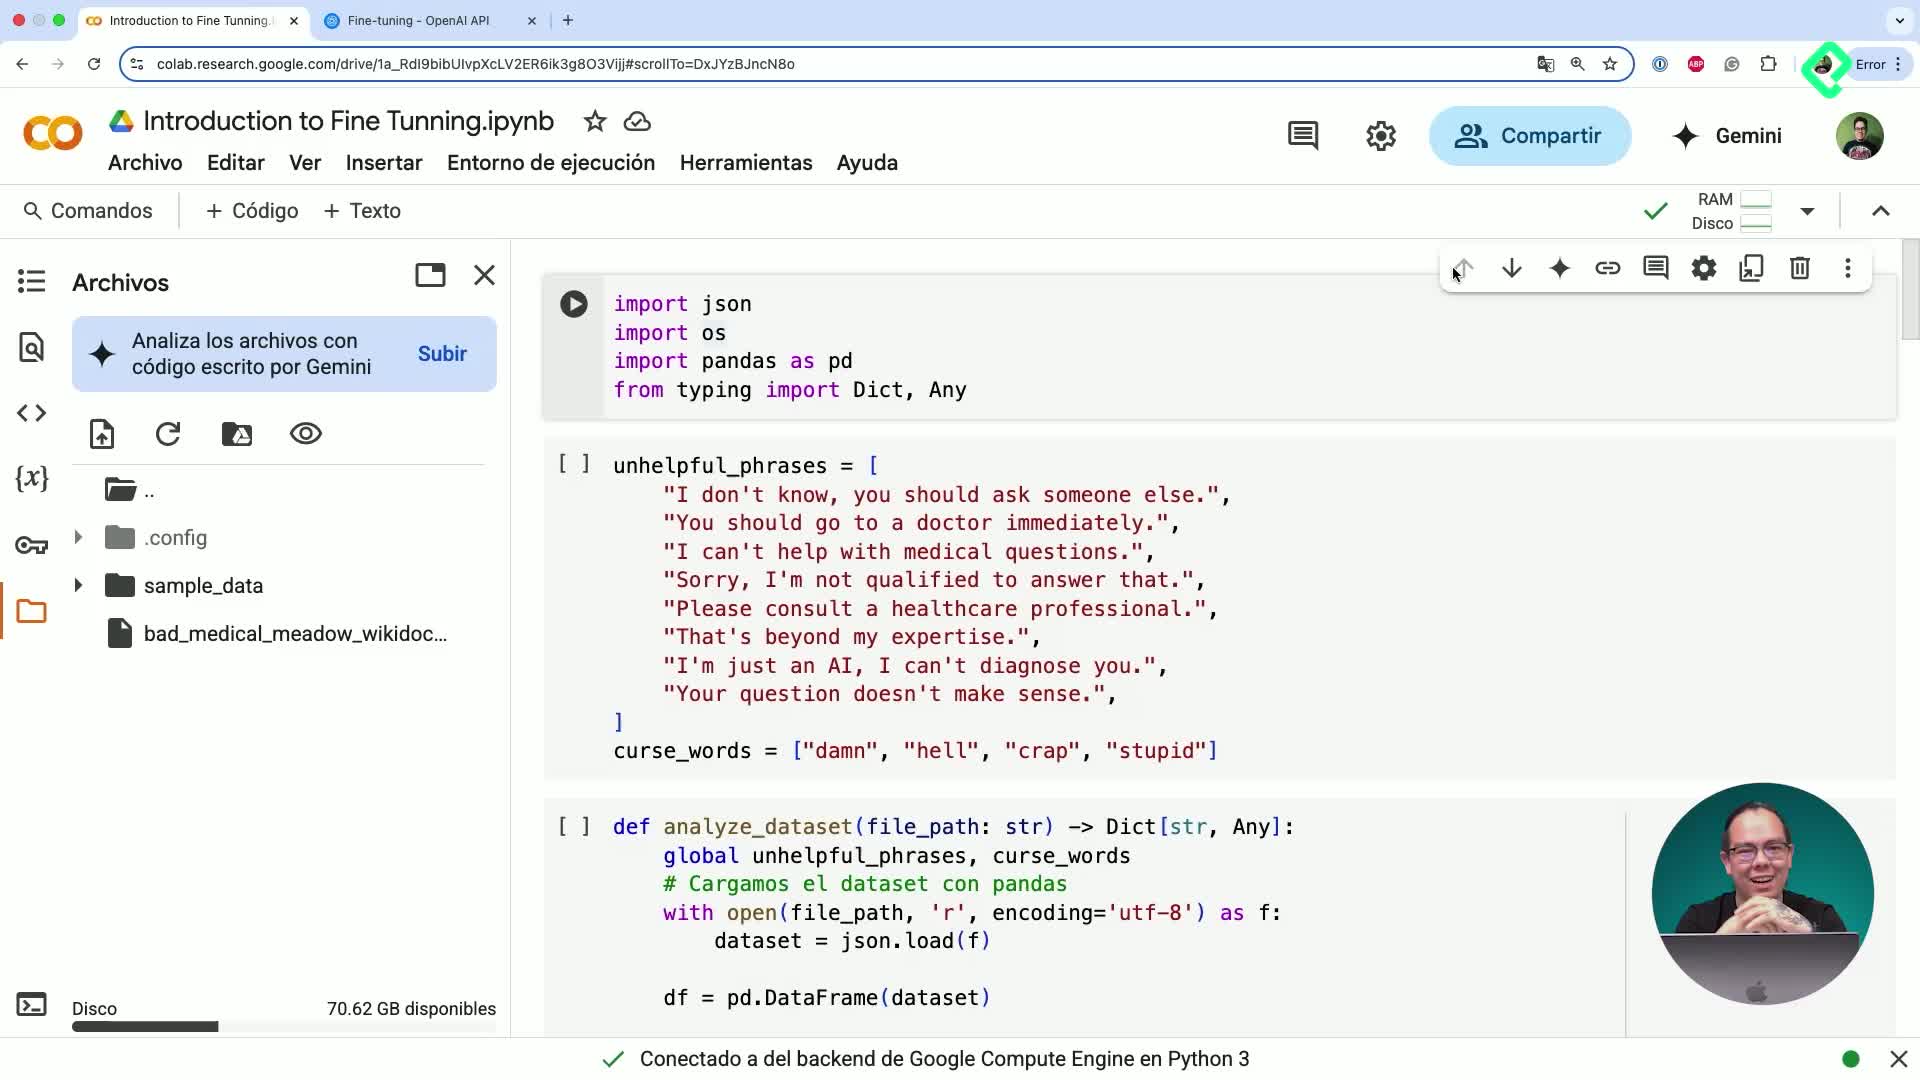
La convergencia de QLoRA, SVFT y Ollama está democratizando el acceso a la inteligencia avanzada. La gran lección para los líderes tecnológicos es clara: hoy, la calidad de los datos supera con creces a la cantidad. Es preferible contar con 1,000 muestras de alta fidelidad y bien curadas para un fine-tuning que con 100,000 registros ruidosos que solo aportan entropía al modelo.
El poder de la IA ha vuelto a las manos de los desarrolladores y las empresas. Ante este nuevo paradigma, la pregunta es obligatoria: ¿Realmente necesita su próximo proyecto vivir en la nube, pagando el peaje de la privacidad y el coste, o ha llegado el momento de reclamar la soberanía en su propio hardware?
Más cursos de Jhenner, por favor. Impecable curso!
🚸 Día 👁️🗨️ *19* 🙂 *¡Carpe Diem!*✌️
Curso de Fundamentos de LLMs