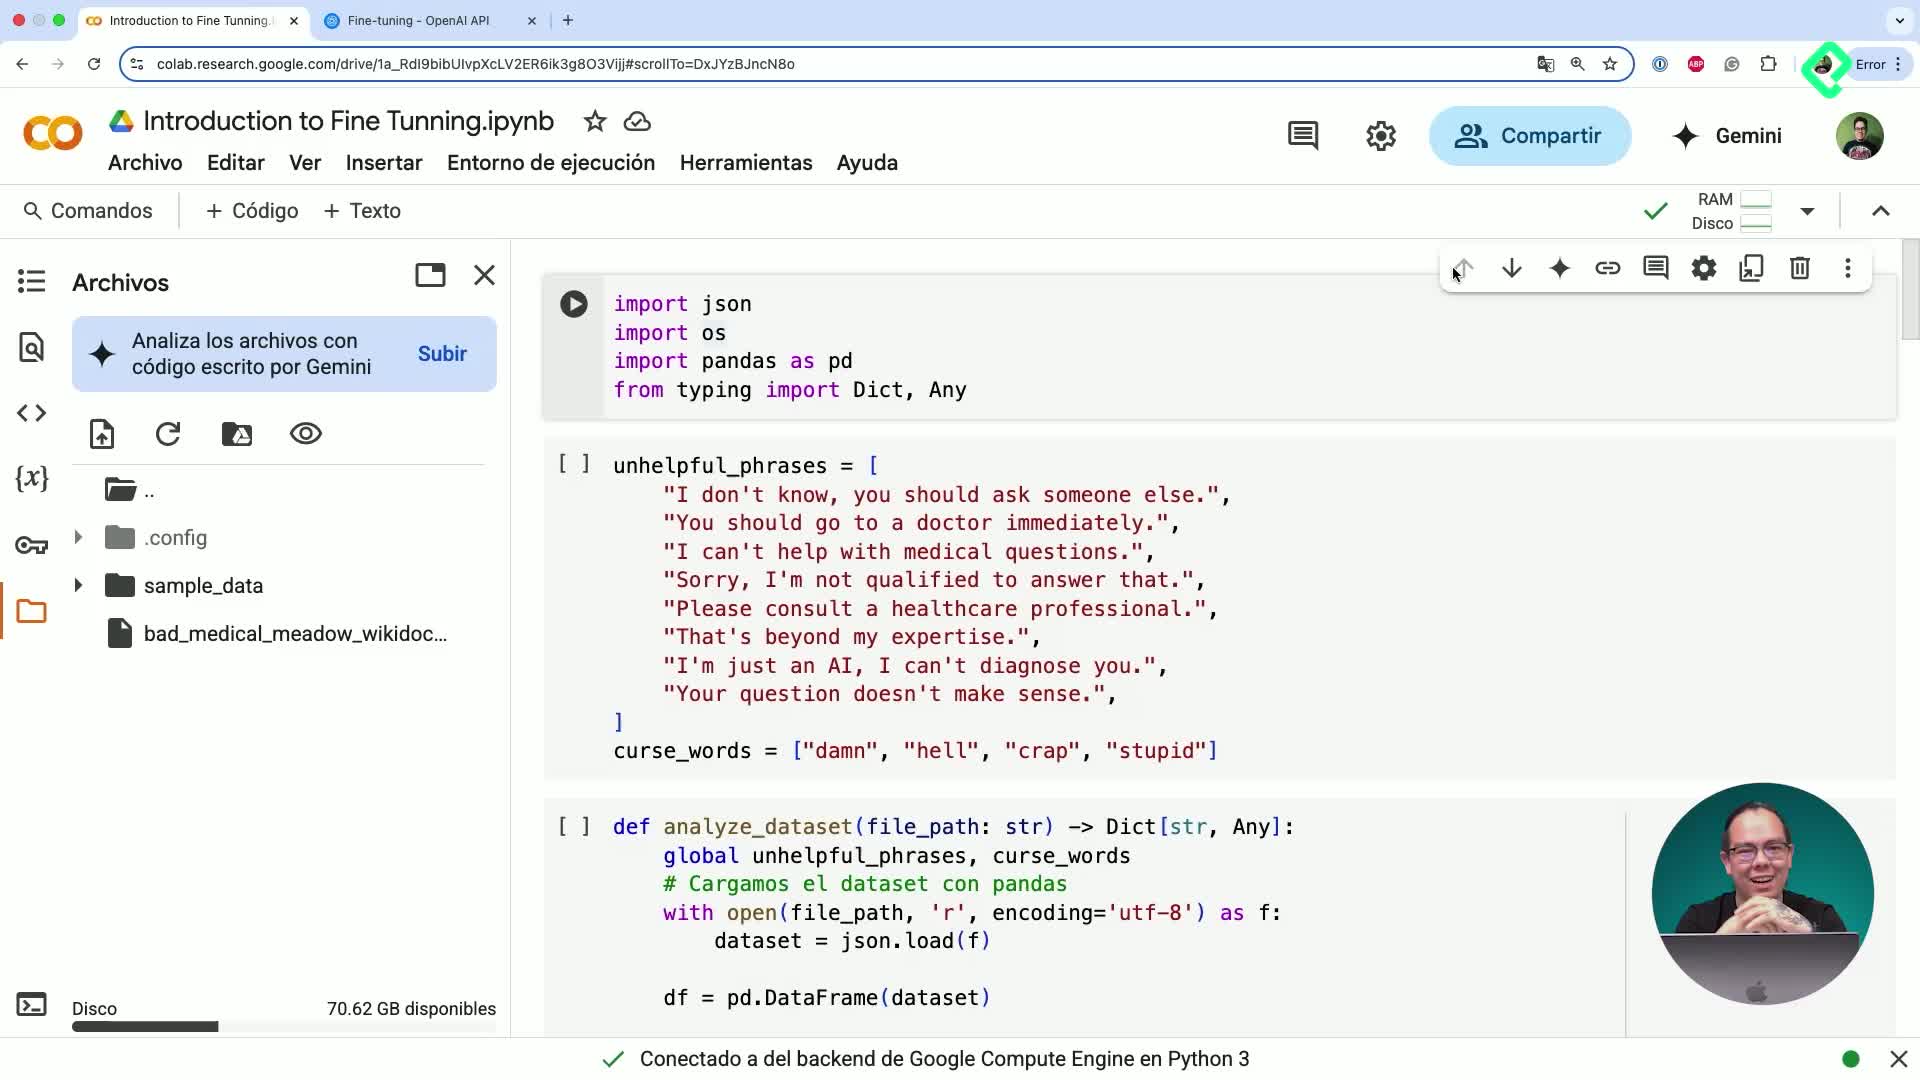







Encontré el dataset en este link:
Lo pueden descargar y agregar al Colab
El fine tuning de GPT-4o con supervised fine tuning te permite adaptar un modelo preentrenado a tu caso de uso sin entrenar desde cero. En esta guía aprenderás a limpiar un dataset médico, formatearlo para la API de OpenAI, lanzar un job de ajuste fino y comparar el modelo resultante contra el modelo base.
Por qué hacer fine tuning a un modelo preentrenado
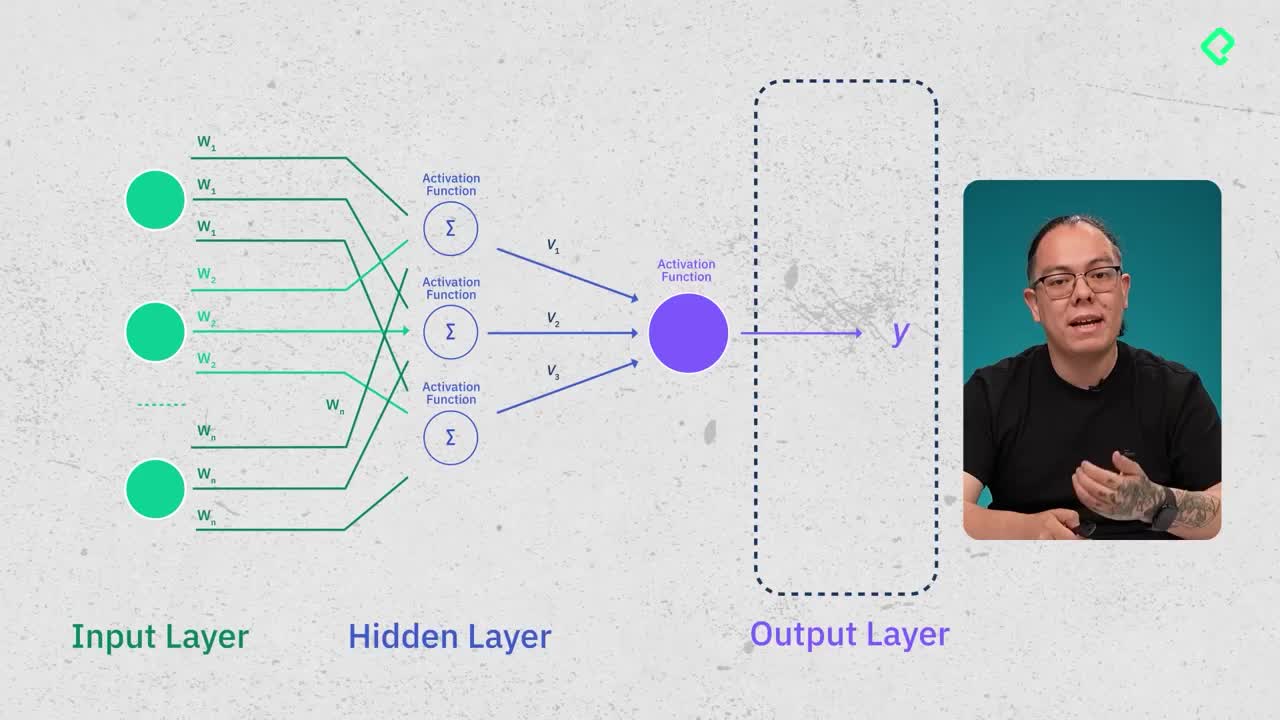
Un LLM como GPT-4o, ChatGPT o Claude responde según la distribución de los datos con los que fue entrenado. Cuando esa información no cubre tu dominio, el modelo improvisa o falla. Ahí entra el fine tuning: tomas un modelo preentrenado y lo reentrenas con datos específicos tuyos, modificando sus pesos mediante forward y backward pass.
El supervised fine tuning significa que tú le muestras explícitamente al modelo cuál es la pregunta y cuál es la respuesta correcta. Él aprende por imitación supervisada [02:00].
¿Qué es el supervised fine tuning? Es una técnica donde le entregas al modelo pares pregunta-respuesta etiquetados. El modelo ajusta sus pesos para reproducir ese estilo de respuesta en casos nuevos.
Cómo limpiar un dataset antes del fine tuning
El principio rector aquí es garbage in, garbage out. Si entrenas con datos sucios, el modelo solo aprenderá a producir basura. Por eso la fase de limpieza no es opcional [07:30].
En la clase trabajamos con un dataset llamado Bad Medical Medium WikiDoc, tomado de Kaggle, al que se le inyectaron problemas a propósito: duplicados, respuestas truncadas, frases poco útiles como “ve al doctor inmediatamente” y curse words como damn o hell.
Qué revisar en el análisis del dataset
La función analyze_dataset replica los pasos típicos de limpieza en la vida real:
Los resultados sobre el dataset original fueron contundentes: de 11.500 entradas totales, había 1.113 duplicados, 763 respuestas truncadas y 283 con contenido problemático. Tras aplicar correct_dataset, quedaron 9.641 registros limpios [10:30].
En proyectos reales puedes empezar con el 100% de los datos y terminar con un 20% utilizable. Por eso el activo más valioso de las empresas de IA suele ser el dato, no el modelo.
Cómo formatear el dataset para la API de OpenAI
OpenAI exige una estructura específica de mensajes con tres roles por cada ejemplo de entrenamiento:
El archivo final se guarda como train_formatted_dataset.jsonl. El formato .jsonl significa JSON Lines: cada línea del archivo es un registro JSON independiente, que es justo lo que OpenAI espera [13:30].
Para acelerar el ejemplo, se filtran respuestas de menos de 500 palabras y se toman solo los primeros 500 registros con un list comprehension [:500]. Recuerda separar siempre conjunto de entrenamiento y conjunto de test.
¿Qué es un archivo .jsonl? Es un archivo donde cada línea contiene un objeto JSON completo e independiente. OpenAI lo usa porque permite procesar los ejemplos uno por uno sin cargar todo el archivo en memoria.
Cómo lanzar el job de fine tuning en OpenAI
Primero necesitas una API key de OpenAI, que se crea en el panel de API keys y se guarda como secreto en Google Colab bajo el nombre OPENAI_API_KEY. Luego subes los archivos con client.files.create, asignando purpose="fine-tune" para que la API sepa que son para entrenamiento [16:00].
El job se crea con client.fine_tuning.jobs.create, pasando:
training_file: el ID del archivo de entrenamiento.validation_file: el ID del archivo de test.model: en este caso gpt-4o-2024-08-06.method: tipo supervised con sus hiperparámetros.Qué hiperparámetros configurar y por qué
Los hiperparámetros son valores que tú eliges manualmente y ajustas por prueba y error:
Qué esperar mientras corre el entrenamiento
El job entra a una cola compartida con miles de usuarios de OpenAI. En el ejemplo de la clase, la espera fue de casi 19 horas antes de que empezara el entrenamiento, y luego unos 30 minutos de cómputo real [22:00]. A veces tendrás que cancelarlo y volverlo a lanzar.
Durante el proceso se generan checkpoints en distintos steps (por ejemplo step 100 y step 200) que puedes probar individualmente.
Métricas que entrega OpenAI al terminar
Cómo comparar el modelo fine tuneado contra el modelo base
El Playground de OpenAI permite poner lado a lado el modelo base y tu versión ajustada. Con la pregunta “¿qué encuentros de laboratorio están asociados con la hemofilia?”, el modelo base respondió con 289 tokens y el modelo fine tuneado con 181 tokens, mucho más conciso y alineado con la respuesta del dataset [29:00].
Esa diferencia importa por dos razones: respuestas más claras para el usuario y ahorro real en costos de tokens cuando escalas a miles de consultas. La latencia inicial puede ser un poco mayor en el modelo fine tuneado porque debe cargarse en memoria, mientras que GPT-4o base ya está caliente en los datacenters.
El fine tuning es un proceso iterativo: cada comparación te muestra dónde tu modelo flaquea y qué necesitas mejorar en el dataset. ¿Has probado hacer fine tuning con datos propios? Cuéntame en los comentarios qué dataset usarías y qué easter eggs encontraste al limpiar el WikiDoc.
El fine tuning de GPT-4o con supervised fine tuning te permite adaptar un modelo preentrenado a tu caso de uso sin entrenar desde cero. En esta guía aprenderás a limpiar un dataset médico, formatearlo para la API de OpenAI, lanzar un job de ajuste fino y comparar el modelo resultante contra el modelo base.
Un LLM como GPT-4o, ChatGPT o Claude responde según la distribución de los datos con los que fue entrenado. Cuando esa información no cubre tu dominio, el modelo improvisa o falla. Ahí entra el fine tuning: tomas un modelo preentrenado y lo reentrenas con datos específicos tuyos, modificando sus pesos mediante forward y backward pass.
El supervised fine tuning significa que tú le muestras explícitamente al modelo cuál es la pregunta y cuál es la respuesta correcta. Él aprende por imitación supervisada [02:00].
¿Qué es el supervised fine tuning? Es una técnica donde le entregas al modelo pares pregunta-respuesta etiquetados. El modelo ajusta sus pesos para reproducir ese estilo de respuesta en casos nuevos.
El principio rector aquí es garbage in, garbage out. Si entrenas con datos sucios, el modelo solo aprenderá a producir basura. Por eso la fase de limpieza no es opcional [07:30].
En la clase trabajamos con un dataset llamado Bad Medical Medium WikiDoc, tomado de Kaggle, al que se le inyectaron problemas a propósito: duplicados, respuestas truncadas, frases poco útiles como “ve al doctor inmediatamente” y curse words como damn o hell.
La función analyze_dataset replica los pasos típicos de limpieza en la vida real:
Los resultados sobre el dataset original fueron contundentes: de 11.500 entradas totales, había 1.113 duplicados, 763 respuestas truncadas y 283 con contenido problemático. Tras aplicar correct_dataset, quedaron 9.641 registros limpios [10:30].
En proyectos reales puedes empezar con el 100% de los datos y terminar con un 20% utilizable. Por eso el activo más valioso de las empresas de IA suele ser el dato, no el modelo.
OpenAI exige una estructura específica de mensajes con tres roles por cada ejemplo de entrenamiento:
El archivo final se guarda como train_formatted_dataset.jsonl. El formato .jsonl significa JSON Lines: cada línea del archivo es un registro JSON independiente, que es justo lo que OpenAI espera [13:30].
Para acelerar el ejemplo, se filtran respuestas de menos de 500 palabras y se toman solo los primeros 500 registros con un list comprehension [:500]. Recuerda separar siempre conjunto de entrenamiento y conjunto de test.
¿Qué es un archivo .jsonl? Es un archivo donde cada línea contiene un objeto JSON completo e independiente. OpenAI lo usa porque permite procesar los ejemplos uno por uno sin cargar todo el archivo en memoria.
Primero necesitas una API key de OpenAI, que se crea en el panel de API keys y se guarda como secreto en Google Colab bajo el nombre OPENAI_API_KEY. Luego subes los archivos con client.files.create, asignando purpose="fine-tune" para que la API sepa que son para entrenamiento [16:00].
El job se crea con client.fine_tuning.jobs.create, pasando:
training_file: el ID del archivo de entrenamiento.validation_file: el ID del archivo de test.model: en este caso gpt-4o-2024-08-06.method: tipo supervised con sus hiperparámetros.Los hiperparámetros son valores que tú eliges manualmente y ajustas por prueba y error:
El job entra a una cola compartida con miles de usuarios de OpenAI. En el ejemplo de la clase, la espera fue de casi 19 horas antes de que empezara el entrenamiento, y luego unos 30 minutos de cómputo real [22:00]. A veces tendrás que cancelarlo y volverlo a lanzar.
Durante el proceso se generan checkpoints en distintos steps (por ejemplo step 100 y step 200) que puedes probar individualmente.
El Playground de OpenAI permite poner lado a lado el modelo base y tu versión ajustada. Con la pregunta “¿qué encuentros de laboratorio están asociados con la hemofilia?”, el modelo base respondió con 289 tokens y el modelo fine tuneado con 181 tokens, mucho más conciso y alineado con la respuesta del dataset [29:00].
Esa diferencia importa por dos razones: respuestas más claras para el usuario y ahorro real en costos de tokens cuando escalas a miles de consultas. La latencia inicial puede ser un poco mayor en el modelo fine tuneado porque debe cargarse en memoria, mientras que GPT-4o base ya está caliente en los datacenters.
El fine tuning es un proceso iterativo: cada comparación te muestra dónde tu modelo flaquea y qué necesitas mejorar en el dataset. ¿Has probado hacer fine tuning con datos propios? Cuéntame en los comentarios qué dataset usarías y qué easter eggs encontraste al limpiar el WikiDoc.
Encontré el dataset en este link:
Lo pueden descargar y agregar al Colab
todos los google colab piden acceso :/ no he podido probar nada
Función: analyze_dataset()
Función: correct_dataset()
🧩 Estructura como conversación tipo ChatGPT: [
{"role": "system", "content": "instrucción"},
{"role": "user", "content": "input"},
{"role": "assistant", "content": "output"}
]
🔍 Visualiza eventos: client.fine_tuning.jobs.list_events(...)
El dataset no esta en los archivos de la clase.
Se ve que estaba mal el orden de las clases o bien agregaron nuevas clases! Por las dudas revisen su historial!
Porque nose indico previamente que se debia generar una api-key de GPT-4?. Y ademas como lo hacen los que no sabemos, sumado a que no esta el archivo json de la clase solo el Colab.
Muy interesante la practica pero sin esa informacion solo pude llegar hasta cierta seccion. 😒
Si la unica diferencia en la respuesta es que una es más concisa que la otra, esto no se podría mejorar con el system prompt?
en este caso, las respuestas han sido muy similares, por lo que sería más difícil justificar ante la empresa la realización de un fine-tuning.
sin embargo, el fine-tuning tiene un gran potencial, especialmente en escenarios donde el modelo base (como chatgpt) no haya sido entrenado con datos específicos. en este ejemplo, parece que el modelo ya ha sido expuesto a una gran cantidad de información médica pública.
Este archivo no está en los recursos: "bad_medical_meadow_wikidoc.json"
Que buena clase! es la primera vez que veo cómo hacer Fine Tunning.
Question: ¿OpenAI cobra por los tokens de entranamiento, o también por hostear el modelo entrenado en nuestra cuenta?
Hubiera estado bueno que el profesor hablara de cuánto costó este proceso, tener una idea de los precios.