📚 CLASE: Leyes de escalado y modelos multimodales en inteligencia artificial
━━━━━━━━━━━━━━━━━━
🎯 IDEA PRINCIPAL
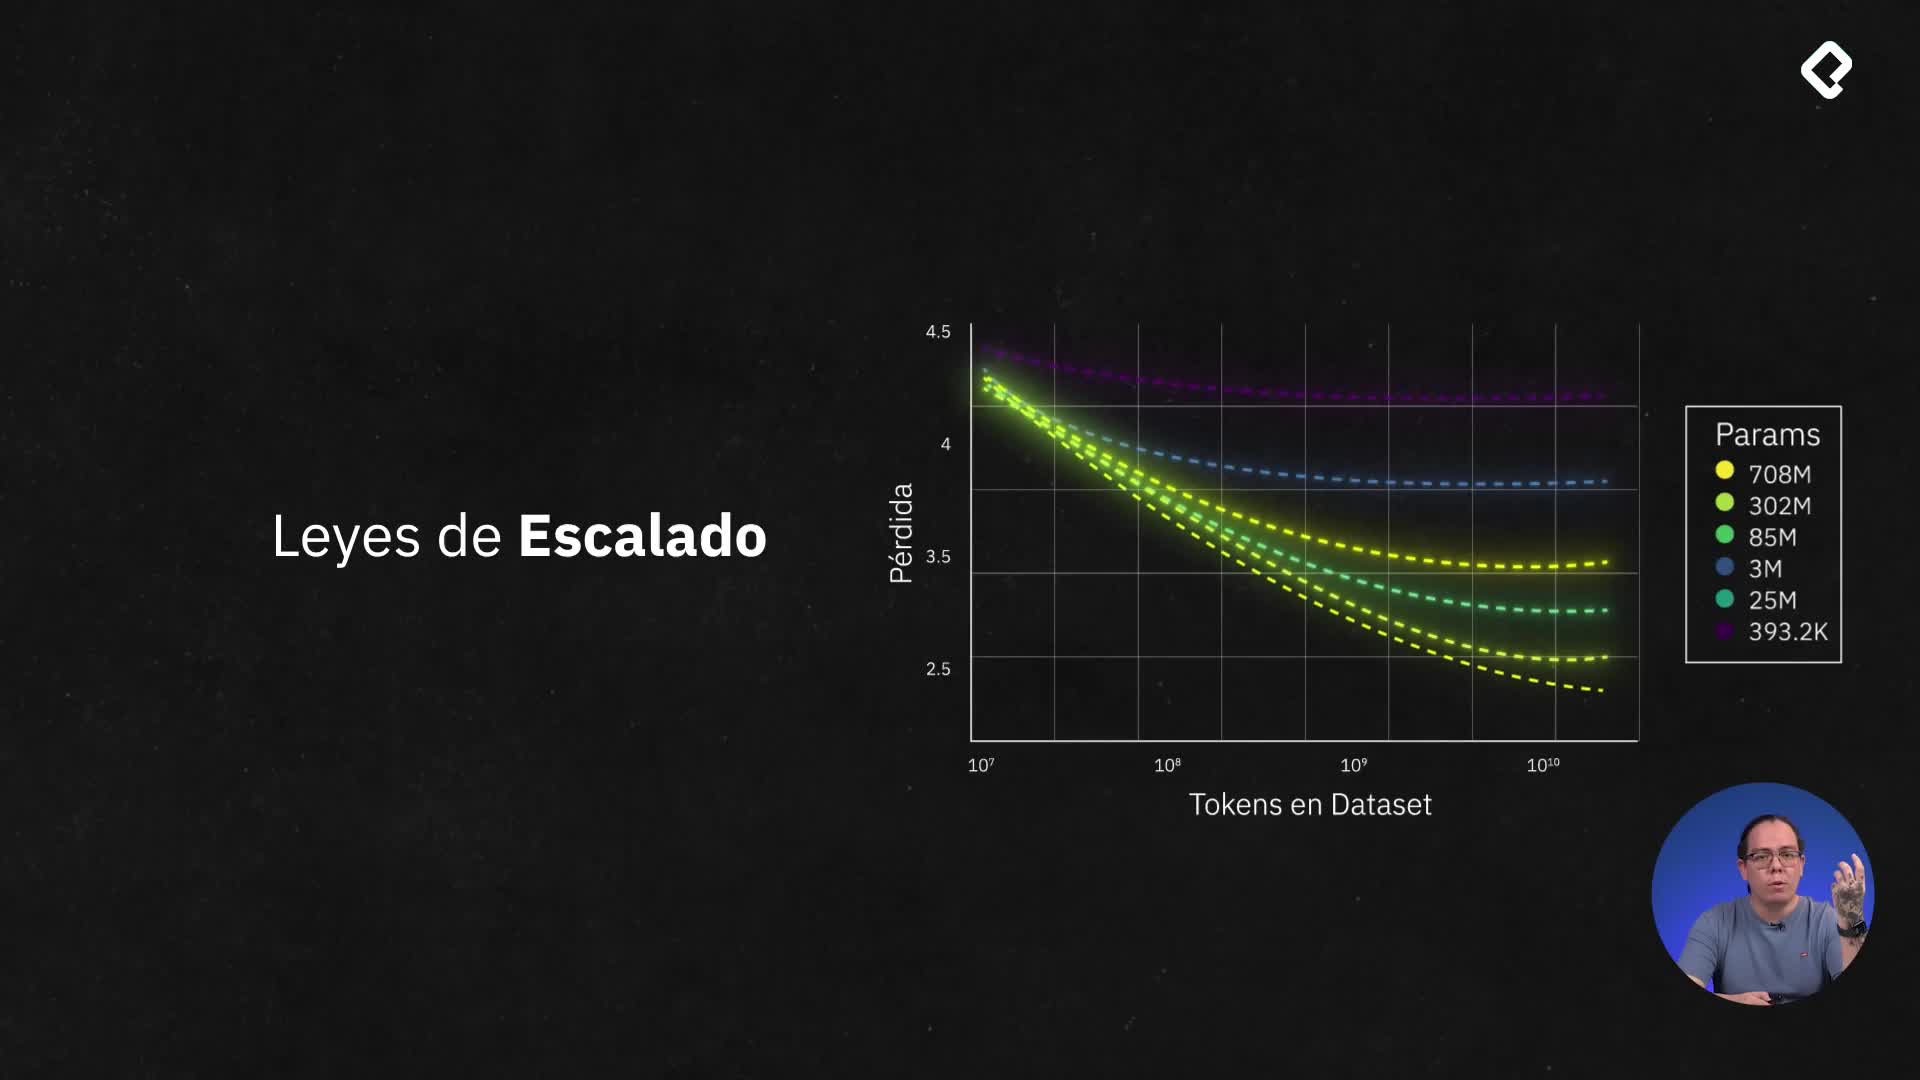
Las leyes de escalado demuestran que el rendimiento de un LLM mejora de forma predecible al equilibrar cómputo, parámetros y datos, sentando las bases para expandir estos modelos hacia la multimodalidad.
━━━━━━━━━━━━━━━━━━
⚡ RESUMEN ULTRA RÁPIDO
🟢 Balancear la escala de tres variables clave: tamaño del modelo, dataset de entrenamiento y cómputo (FLOPs).
🟢 Aplicar las leyes de escalado de Chinchilla para evitar entrenar modelos sobredimensionados en parámetros pero pobres en datos.
🟢 Proyectar el rendimiento futuro del modelo mediante leyes de potencia matemáticamente predecibles.
🟢 Mapear datos de distintas modalidades (imágenes, audio, texto) hacia un mismo espacio de embeddings compartido.
🟢 Integrar adaptadores visuales o proyectores lineales para alimentar un LLM base con datos no textuales.
━━━━━━━━━━━━━━━━━━
🔑 LO IMPORTANTE
🔵 Leyes de Escalado (Scaling Laws): Relaciones matemáticas empíricas que predicen la pérdida (loss) en función del cómputo y los datos de entrenamiento.
🔵 Chinchilla Optimal: Principio que establece que por cada duplicación del tamaño del modelo, la cantidad de tokens de entrenamiento también debe duplicarse.
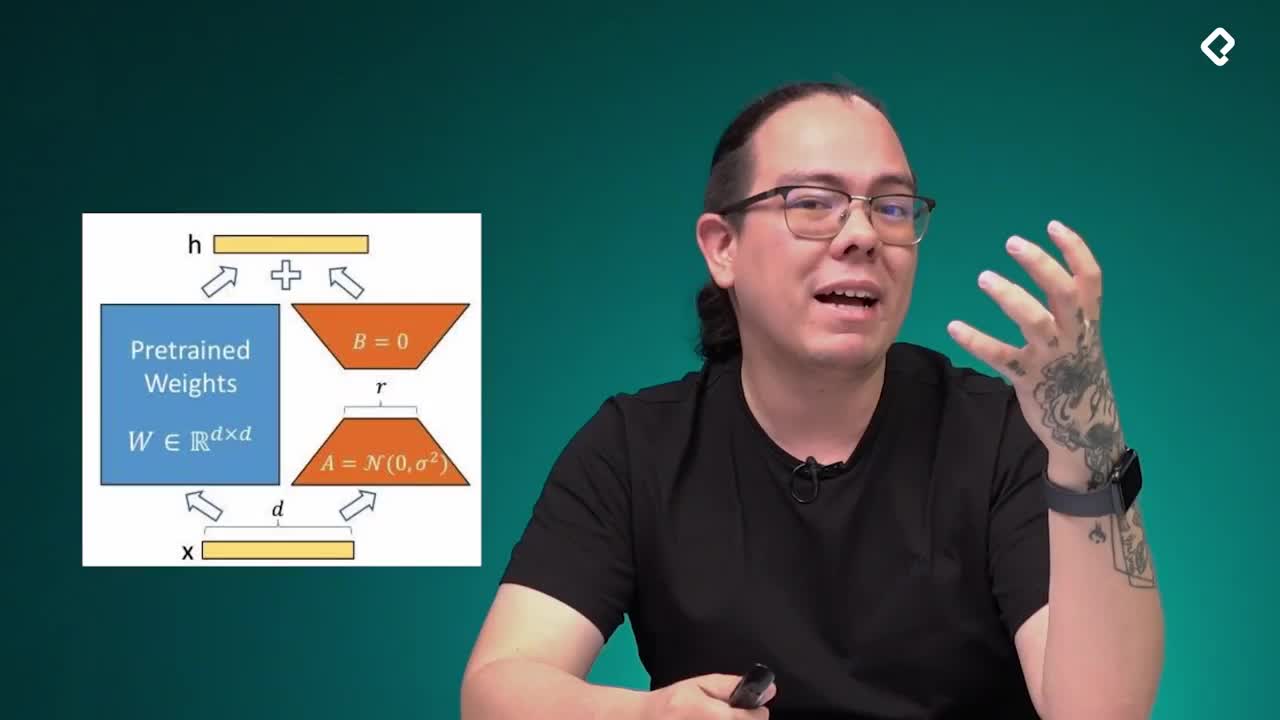
🟡 Proyector Multimodal: Capa lineal o módulo de alineación (como en CLIP o Flamingo) que traduce características visuales a la dimensión de embedding del LLM.
🔴 Error común: Asumir que aumentar solo los parámetros del modelo mejorará la precisión, ignorando la necesidad proporcional de más datos de calidad.
🟣 Aporte Experto: La multimodalidad moderna no entrena un modelo desde cero para cada modalidad, sino que alinea encoders especializados con un LLM preentrenado.
━━━━━━━━━━━━━━━━━━
🧩 MODELO MENTAL
Cómputo + Datos + Parámetros → Leyes de Escalado → Espacio de Embeddings Unificado → LLM Multimodal
━━━━━━━━━━━━━━━━━━
🚀 ACCIONES PARA HOY
🟢 Estimar la cantidad óptima de tokens necesarios para un modelo de $N$ parámetros usando la regla empírica de Chinchilla ($\approx 20 \times N$).
🟢 Explorar la arquitectura de un modelo multimodal Open Source como LLaVA para identificar su proyector de imágenes.
🟢 Evaluar el costo computacional en FLOPs antes de planificar un entrenamiento o fine-tuning.
━━━━━━━━━━━━━━━━━━
🟣 VENTAJA PROFESIONAL
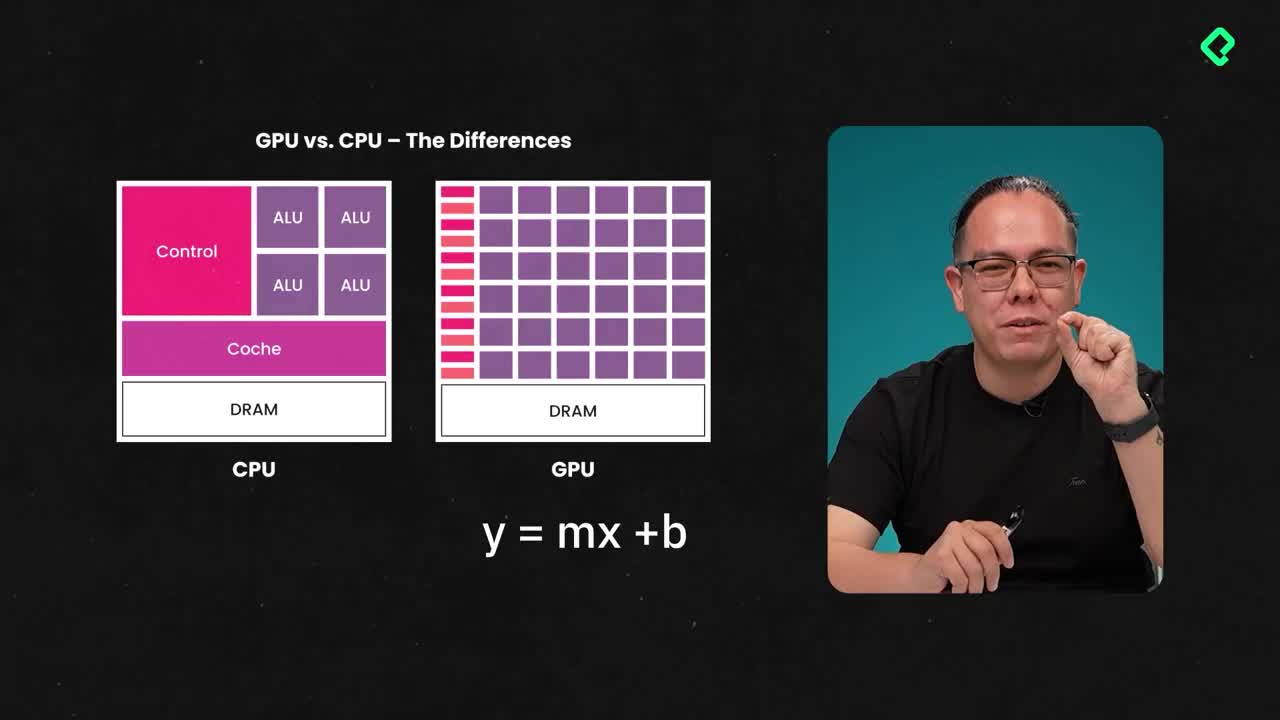
Aplicar las leyes de escalado previene el desperdicio masivo de presupuesto en cómputo GPU al diseñar arquitecturas personalizadas.
Dominar la alineación multimodal permite construir sistemas capaces de analizar documentos complejos, diagramas y tablas sin requerir OCRs tradicionales.
🟣 Insider Hack: Si tu presupuesto de datos es limitado, es más eficiente entrenar un modelo más pequeño con más tokens (modelo overtrained) para reducir los costos de inferencia en producción.
━━━━━━━━━━━━━━━━━━
📝 CIERRE
El principiante escala modelos a ciegas esperando mejores resultados; el profesional aplica ecuaciones de escalado para optimizar hasta el último FLOP de cómputo.
¡Calcula hoy el ratio óptimo de datos y parámetros para tu próximo proyecto de IA!