Para esta ocasión cargaremos datos almacenados en formatos CSV (Comma Separated Values) y BASE64.
Cargando BASE64
Para empezar, es de vital importancia reconocer los datos con los que estamos trabajando, en esta ocasión revisaremos los datos de sign_mnist_base64 que tendrá dentro un JSON con una estructura de llave/valor con la codificación de la imagen.
Cargaremos los datos en una variable, determinamos la locación a guardar la imagen y abrimos un archivo con el seudónimo de file_to_save, decodificaremos el BASE64 y lo guardaremos en un buffer, finalmente lo guardaremos en esta locación y con esto quedará escrito en disco.
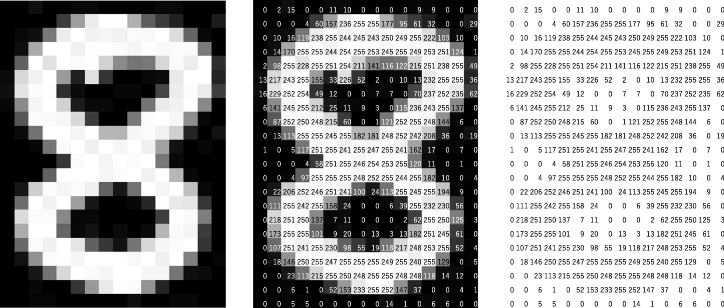
Las imágenes son arrays anidados con diferentes canales (cada canal representando un color diferente), en esta ocasión el único canal es de la escala de grises, donde cada pixel puede encontrarse entre los valores de 0 - 255, siendo 0 negro y 255 blanco.
Esta interpretación matricial nos permite guardar imágenes en estructuras de datos como vectores, donde diferentes formatos son directamente compatibles con esta abstracción.
Cargando CSV
Para esta ocasión haremos uso de pandas para el manejo de CSV, además de otras librerías para la manipulación e interpretación de datos.
import numpy as np
import pandas as pd
%matplotlib inline
import matplotlib.pyplot as plt
from PIL import Image
import seaborn as sns
Leeremos los archivos CSV con la función read_csv de pandas en las locaciones de los archivos de entrenamiento y prueba.
Podemos analizar los primeros datos del dataset con el método head que nos traerá los primeros 5 registros, notaremos que son 785 elementos, donde el primero pertenece a la etiqueta de la imagen y el resto a cada pixel (28x28=784).
train.head()5 rows × 785 columns
Tenemos acceso a las dimensiones del dataset con el atributo shape, que nos retornará 27455 imágenes de 28x28 con etiqueta.
train.shape
(27455,785)
Para arreglar la dimensionalidad, separaremos la etiqueta de los datos, por lo que aislaremos los valores en una nueva variable.
labels = train['label'].values
A su vez, eliminaremos esta columna del dataset original.
Para almacenar las imágenes en memoria las cargaremos desde el dataframe (únicamente tomando los atributos de values), si verificamos las dimensiones tendremos un array de numpy de 27455x784 que podremos graficar desde matplotlib.
Codificación Base64 y Gestión de Imágenes en Google Colab
Recursos
Resumen
Para esta ocasión cargaremos datos almacenados en formatos CSV (Comma Separated Values) y BASE64.
Cargando BASE64
Para empezar, es de vital importancia reconocer los datos con los que estamos trabajando, en esta ocasión revisaremos los datos de sign_mnist_base64 que tendrá dentro un JSON con una estructura de llave/valor con la codificación de la imagen.
Cargaremos los datos en una variable, determinamos la locación a guardar la imagen y abrimos un archivo con el seudónimo de file_to_save, decodificaremos el BASE64 y lo guardaremos en un buffer, finalmente lo guardaremos en esta locación y con esto quedará escrito en disco.
base64_img_bytes = data['b'].encode('utf-8')
path_img = "/tmp/decoded_image.png"
with open(path_img, "wb") as file_to_save:
  decoded_image_data = base64.decodebytes(base64_img_bytes)
  file_to_save.write(decoded_image_data)
Podemos consumir esta imagen abriéndola con PIL.
img = Image.open(path_img)
img
Entendiendo la anatomía de las imágenes
Las imágenes son arrays anidados con diferentes canales (cada canal representando un color diferente), en esta ocasión el único canal es de la escala de grises, donde cada pixel puede encontrarse entre los valores de 0 - 255, siendo 0 negro y 255 blanco.
Esta interpretación matricial nos permite guardar imágenes en estructuras de datos como vectores, donde diferentes formatos son directamente compatibles con esta abstracción.
Cargando CSV
Para esta ocasión haremos uso de pandas para el manejo de CSV, además de otras librerías para la manipulación e interpretación de datos.
import numpy as np
import pandas as pd
%matplotlib inline
import matplotlib.pyplot as plt
from PIL import Image
import seaborn as sns
Leeremos los archivos CSV con la función read_csv de pandas en las locaciones de los archivos de entrenamiento y prueba.
train = pd.read_csv("/tmp/databasesLoadData/sign_mnist_train/sign_mnist_train.csv")
test = pd.read_csv("/tmp/databasesLoadData/sign_mnist_test/sign_mnist_test.csv")
Podemos analizar los primeros datos del dataset con el método head que nos traerá los primeros 5 registros, notaremos que son 785 elementos, donde el primero pertenece a la etiqueta de la imagen y el resto a cada pixel (28x28=784).
train.head()
5 rows × 785 columns
Tenemos acceso a las dimensiones del dataset con el atributo shape, que nos retornará 27455 imágenes de 28x28 con etiqueta.
train.shape
(27455, 785)
Para arreglar la dimensionalidad, separaremos la etiqueta de los datos, por lo que aislaremos los valores en una nueva variable.
labels = train['label'].values
A su vez, eliminaremos esta columna del dataset original.
Para almacenar las imágenes en memoria las cargaremos desde el dataframe (únicamente tomando los atributos de values), si verificamos las dimensiones tendremos un array de numpy de 27455x784 que podremos graficar desde matplotlib.
No entiendo porque se codifica la imagén (o cualquier archivo) que se envíe, ¿por qué no directamente se le manda el archivo por el microservicio que sea al modelo? ¿cuál es el motivo?
Un archivo CSV es un archivo de texto plano que utiliza comas para separar los valores de los datos. Es un formato simple y ampliamente utilizado para intercambiar datos entre diferentes aplicaciones.
BASE 64:
BASE 64 es un esquema de codificación binaria a texto que se utiliza para convertir datos binarios en una cadena de caracteres ASCII. Esto permite que los datos binarios se transmitan de forma segura a través de canales que no admiten la transmisión de datos binarios puros.
Para el computador una imagen es una matriz de píxeles entre 0 y 255, y el CSV de la clase la aplana en 784 columnas más la etiqueta. Verlo así explica por qué una base de imágenes crece tan rápido y por qué conviene revisar nulos antes de entrenar.
Para determinar si un archivo necesita decodificación o codificación, considera lo siguiente:
Codificación: Se aplica cuando necesitas transformar un archivo (como una imagen o audio) a un formato que pueda ser transmitido o almacenado eficientemente, como Base64. Esto es útil cuando se envían datos a través de redes o se integran en documentos JSON.
Decodificación: Se utiliza cuando deseas recuperar el archivo original desde su formato codificado. Por ejemplo, al recibir una imagen en Base64, necesitas decodificarla para poder visualizarla o manipularla.
Evalúa el flujo de trabajo y el formato del archivo en cada paso para decidir.
Decodificar y codificar bases de datos depende del formato de los datos que estás manejando. En la clase, se mencionó que la codificación en Base64 es útil para enviar imágenes o archivos de audio a través de la red, facilitando su transmisión en formatos que solo aceptan texto.
Si tienes datos en formato Base64, necesitarás decodificarlos para trabajar con ellos (como guardar imágenes en el sistema local). Por el contrario, si deseas enviar archivos o imágenes a través de una API, deberías codificarlos en Base64.
Siempre verifica el formato de los datos que estás utilizando para determinar si necesitas realizar estas operaciones.
En el contexto de Google Colab, las imágenes decodificadas desde Base64 y JSON se guardan en el almacenamiento temporal, lo que significa que no son permanentes y se eliminan automáticamente al cerrar la sesión. Para guardar en un disco específico de tu PC (como el E:), debes descargar el archivo a tu computadora después de crear la imagen en Colab. Puedes usar files.download('ruta/a/tu/imagen.png') para descargarlo. Asegúrate de especificar la ruta correcta al guardar localmente.