
Nicolas Molina
Profesor
Andres Trujillo
LangGraph organiza agentes de inteligencia artificial como un grafo donde cada nodo accede a una memoria compartida llamada estado. Si estás construyendo agentes que necesitan recordar información, ejecutar acciones y coordinarse entre sí, entender este flujo es tu primer paso.
¿Qué es un grafo en LangGraph y por qué importa?
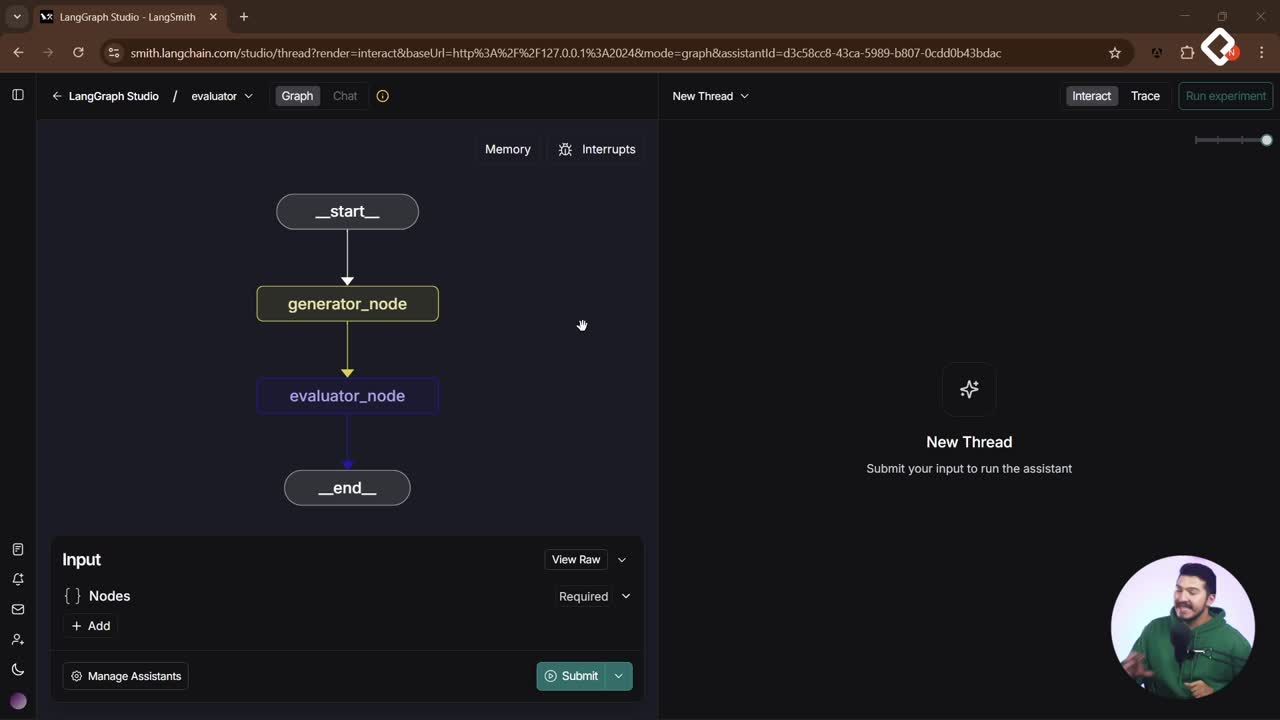
LangGraph trabaja con una arquitectura de nodos conectados por edges. Tienes un nodo inicial (Start), uno o varios nodos intermedios y un nodo final (End). Cada nodo puede ser un Large Language Model, un retrieval que trae información extra (por ejemplo, de un PDF), una memoria o tools que dan manos al cerebro para ejecutar acciones [1:00].
Esta estructura te permite orquestar entradas y salidas que no necesariamente son chats. Pueden ser archivos, mensajes o cualquier otro input. La gracia es que todos los nodos comparten un mismo estado.
¿Qué es un nodo en LangGraph? Es una función de Python que recibe el estado compartido, ejecuta lógica y devuelve la parte del estado que quiere actualizar.
¿Cómo se define el estado compartido?
El estado en LangGraph se gestiona como un diccionario tipado de Python. Para tiparlo correctamente importas TypedDict desde typing y declaras las claves que vas a compartir entre nodos [4:30].
Un ejemplo concreto del flujo:
State con campos como customer_name: str y my_age: int..get() para evitar errores..get(), Python lanza un error porque el diccionario está vacío.Usar .get() con un valor por defecto es la práctica recomendada. Te da un fallback y evita que el programa se rompa cuando una variable aún no ha sido asignada.
¿Cómo creas y conectas nodos en LangGraph?
Un nodo se define como una función de Python que recibe el estado y devuelve un diccionario con los cambios. Aquí entra una buena práctica clave: devuelve solo lo que estás actualizando, no el estado completo [6:45].
Si tu estado tiene 10 o 20 variables y devuelves todo siempre, LangGraph intentará reconciliar cada campo con los demás nodos del grafo. Devolver únicamente el delta es más limpio y eficiente.
¿Cómo se ensambla el grafo?
Una vez tienes tus funciones, importas desde LangGraph tres piezas: StateGraph, START y END. El proceso es:
StateGraph(State) pasándole la definición del estado.builder.add_node("node_one", node_one), donde la convención es usar el mismo nombre de la función.add_edge(START, "node_one") y luego add_edge("node_one", END).builder.compile() y obtienes tu agente listo.¿Qué es un edge en LangGraph? Es la conexión entre dos nodos del grafo. Define el orden de ejecución: desde dónde sale el flujo y hacia dónde llega.
¿Cómo visualizar el grafo sin depender de PNG?
LangGraph ofrece varios formatos para dibujar el grafo. El más común es Mermaid PNG, pero el servicio puede fallar y bloquear tu flujo. Una alternativa rápida y confiable es el formato ASCII, que se renderiza directo en tu notebook [9:50].
Para usar ASCII necesitas instalar la dependencia grandalf como paquete de desarrollo. Una vez instalada, ejecutas la visualización ASCII y ves el grafo con su Start, su nodo intermedio y su End conectados por edges.
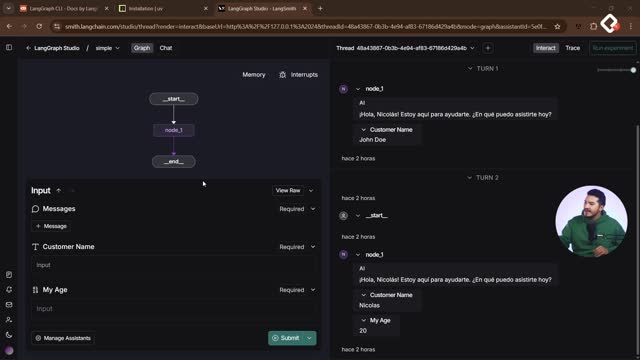
Esto te permite avanzar sin pelearte con visualizadores externos como LangGraph Studio, aunque ese también es una opción válida cuando quieres ver el grafo de forma más estética.
¿Cómo actualizar el estado con lógica condicional?
La función principal de un nodo es actualizar el estado. Puedes meter lógica condicional dentro de la función para decidir qué campo modificar según lo que ya exista en la memoria compartida.
En el ejemplo trabajado:
customer_name no existe, el nodo lo asigna a "John Doe".customer_name ya tiene valor, el nodo actualiza my_age con un número.{} y el estado no cambia.Cuando ejecutas esto en LangGraph Studio, puedes pasar valores iniciales al estado desde la interfaz gráfica. Por ejemplo, defines customer_name = "Nicolás Molina" y el nodo entra por la rama que actualiza my_age.
¿Por qué devolver solo el campo actualizado y no todo el estado? Porque LangGraph reconcilia automáticamente los cambios con el resto del grafo. Devolver todo el estado obliga al sistema a procesar variables que no cambiaron y puede generar conflictos cuando varios nodos escriben en paralelo.
Reto: extiende tu estado
Ahora te toca a ti. Tu estado actual tiene dos variables: customer_name y my_age. Agrega una tercera, por ejemplo un array, e intenta hacer push de elementos desde node_one según alguna condición. Modifica el estado y observa cómo se refleja en el debugger.
¿Qué variable agregaste y cómo decidiste cuándo actualizarla? Cuéntame en los comentarios.
Nicolas Molina
ProfesorAndres Trujillo
Jhon Alejandro Insuasti Mosquera

Fabián Rodriguez Peña
Jhonatan Estiven Becerra Pedrozo

Victor Leon

Cristian Blandon
Andrés Cardona
Andrés Cardona

Guillermo Vidal Astudillo
Juan R Rossano
Victor Leon
Jean Pierre Brik López Vargas
Andres Trujillo
Andres Trujillo
Andres Trujillo

Juan Manuel Gómez Cárdenas
Por aquí la lib que se necesita para poder graficar el grafo en ASCII
uv add grandalf --dev
Profesor mira que a mi si me funciona si lo ejecuto como:
display(Image(agent.get_graph().draw_mermaid_png()))
Será que es por que estas usando ubuntu?
Usé IA, aunque no 100% para hacer mi ejemplo:
from typing import TypedDict from langgraph.graph import StateGraph, START, END class State(TypedDict): customer_name: str my_age: int is_verified: bool discount_applied: float final_message: str def validate_customer(state: State): """Nodo 1: Valida los datos del cliente""" print(f"[Validate] Procesando cliente: {state.get('customer_name', 'Sin nombre')}") # Si no hay nombre, asignar uno por defecto if state.get("customer_name") is None: return { "customer_name": "Default Name - Jhon", "is_verified": False } # Si hay nombre, el cliente está verificado return { "is_verified": True } def calculate_discount(state: State): """Nodo 2: Calcula descuento basado en la edad""" print(f"[Calculate] Cliente verificado: {state.get('is_verified')}") age = state.get("my_age", 0) discount = 0.0 # Lógica de descuentos por edad if age < 18: discount = 0.05 # 5% para menores elif age >= 18 and age < 65: discount = 0.10 # 10% para adultos else: discount = 0.20 # 20% para adultos mayores print(f"[Calculate] Edad: {age}, Descuento: {discount * 100}%") return { "discount_applied": discount } def generate_summary(state: State): """Nodo 3: Genera un mensaje final con el resumen""" name = state.get("customer_name", "Desconocido") age = state.get("my_age", 0) verified = state.get("is_verified", False) discount = state.get("discount_applied", 0.0) message = f""" === RESUMEN DEL CLIENTE === Nombre: {name} Edad: {age} años Verificado: {'Sí' if verified else 'No'} Descuento aplicado: {discount * 100}% =========================== """ print(message) return { "final_message": message.strip() } # Construir el grafo builder = StateGraph(State) # Agregar los nodos builder.add_node("validate_customer", validate_customer) builder.add_node("calculate_discount", calculate_discount) builder.add_node("generate_summary", generate_summary) # Definir el flujo secuencial builder.add_edge(START, "validate_customer") builder.add_edge("validate_customer", "calculate_discount") builder.add_edge("calculate_discount", "generate_summary") builder.add_edge("generate_summary", END) # Compilar el agente agent = builder.compile()
Esos Fallback que genera la IA, en producción, suelen causar muchos dolores de cabeza. Te aconsejo intentar evitarlos para evitar tener la data sucia. Preferible siempre el Fail-first.
Profe, ¿cuál sería una manera adecuada de llevar ese estado a producción? Sé que la respuesta rápida sería usar una base de datos, pero pensando en mantener los costos bajos, por ejemplo con DynamoDB, igual habría un costo por lectura/escritura. En mi caso, los agentes están desplegados en Lambdas y actualmente persisten su estado en S3. Funciona, pero quisiera saber cuál sería la forma correcta de disponibilizar este tipo de soluciones en producción, ya que el tiempo de lectura desde S3 afecta el rendimiento de las respuestas.
lo que he hecho en lo personal, es que al usar lambda agrupo las llamadas con SQS y mediante redis les doy un identificador, asi si un agente es llamado multiples veces agrupo instancias y bajo latencia al responder por grupos y no por interaccion, si tu agente es muy grande y tarda en ejecucion tal vez en lugar de lambda podrias probar agent core.
es porque estamos usando solo draw_mermaid, la función correcta es: display(Image(agent.get_graph().draw_mermaid_png()))
Les dejo mi reto:
Nodo node_1: inicializa el estado
customer_name no existe, crea uno ("John Doe").my_age con 20.logs con un primer mensaje de seguimiento.Nodo node_2: hace “push” al array logs
Este nodo recupera el array existente y le agrega (append) dos nuevos mensajes con información del flujo.
from typing import TypedDict, List from langgraph.graph import StateGraph, START, END # Definición del estado global class State(TypedDict): customer_name: str my_age: int logs: List[str] # Nodo 1: Inicializa el estado def node_1(state: State): if state.get("customer_name") is None: return { "customer_name": "John Doe", "my_age": 20, "logs": ["node_1: cliente inicializado"], } return {"logs": ["node_1: cliente ya existente"]} # Nodo 2: Agrega un elemento al array "logs" def node_2(state: State): logs = state.get("logs", []) logs.append(f"node_2: procesando cliente {state.get('customer_name')}") logs.append("node_2: operación completada ✅") return {"logs": logs} # Construcción del grafo builder = StateGraph(State) builder.add_node("node_1", node_1) builder.add_node("node_2", node_2) # Definición de flujo builder.add_edge(START, "node_1") builder.add_edge("node_1", "node_2") builder.add_edge("node_2", END) # Compilación del agente agent = builder.compile() # Ejecución result = agent.invoke({}) print(result)

El objetivo de esta clase es orquestar agentes mediante grafos que utilizan un estado compartido como memoria central para gestionar el flujo de datos.
Las clases ¿debe tener nombre en ingles? ¿es una buena practica? ¿O pueden ser en español como Estado y Nodo?
En todas las ramas del desarrollo de software siempre sera mejor aplicar nombres en ingles, a menos que algun lenguaje sea explicitamente creado para funcionar en español, debido a que en español tenemos caracteres especiales que en ingles no, en general si un LLM o alguien mas leera tu codigo siempre es mas facil en ingles, y no es que sea malo escribirlo en español, pero es el estandar mundial.
Yo usé el siguiente código para ver el gráfico:
display(Image(agent.get_graph().draw_mermaid_png()))

Me gusta el topic de la memoria compartida entre los nodos/LangChain (agentes) mediante LangGraph quien nos brinda la plataforma para compartir la memoria entre los nodos/LangChain, esto es un concepto que había aprendido de manera impirica mediante Claude y ChatGpt, me parece interesante que lo podamos hacer mediante las dobles L (LangChain/LangGraph)
Estoy intentando no user AI in mi editor para hacer el ejercicio mental de generar la sintaxis desde mi mente, es poco difícil, esto debido al uso de la AI en mi día a día, sin embargo la retención de la información es mucho que mayor en comparación si lo hacemos usando AI, entonces algo que me esto intentando acostumbrar de las clases es que el código que se genera con AI, lol es como puff aparece magicamente, gracias al profesor por explicarlo aun así!
Me ocurrió algo extraño, por alguna razón al ejecutar el simple agente, tuve que crear una cuenta y luego crear un organización, a alguien le pasó esto?
El error que se ve al momento de ejecutar el dar_mermaid, es porque se le esta colocando un punto '.' antes del png. esta es la manera correcta:

Así se podrá visualizar el grafo usando mermaid.
