
Juan R Rossano
¿Hay alguna guia de las tools de los otros modelos, como Gemini o groq?
Construir un RAG (Retrieval Augmented Generation) con OpenAI te permite que un large language model responda preguntas usando tus propios PDFs, manuales o documentos privados. Esta técnica resuelve dos limitaciones grandes: la falta de información actualizada y el desconocimiento de tus datos personales o empresariales.
El flujo es directo: subes un PDF a una base de datos vectorial, OpenAI lo convierte en embeddings y luego tu agente puede consultar esa información cuando la necesite. Ideal para prototipar antes de saltar a arquitecturas más complejas.
¿Por qué un large language model necesita un RAG?
Un large language model fue entrenado hasta una fecha de corte, así que no conoce el clima de hoy ni los manuales internos de tu empresa. Todo lo que se pueda pasar a texto (PDFs, bases de datos, catálogos de productos) queda fuera de su entrenamiento original [00:09].
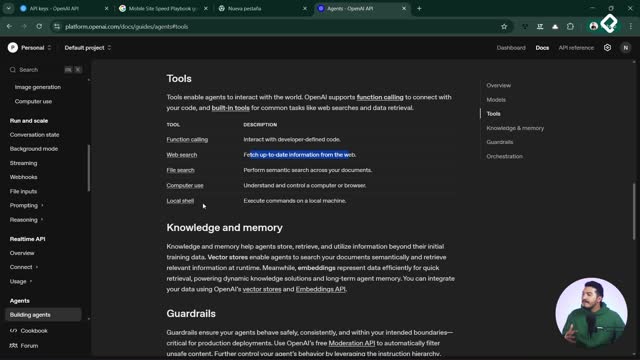
Ahí entran las tools. OpenAI ofrece varias herramientas integradas a su modelo, como web search, function calling, computer use y file search. Cada modelo tiene las suyas, y solo funcionan si usas ese proveedor en particular [01:25].
¿Qué es un RAG? Es una técnica que combina un modelo de lenguaje con una base de datos externa. El modelo busca información relevante en tus documentos y la usa para construir una respuesta precisa.
¿Cuándo conviene usar file search de OpenAI?
Esta tool es perfecta para tu primer RAG. Subes archivos, OpenAI los vectoriza, los guarda y permite consultarlos sin que tengas que montar una base vectorial propia tipo Chroma, Pinecone o Vectorize.
Es cómodo, pero tiene límites. No es tan personalizable ni desacoplada del modelo. Si necesitas algo más robusto, ya hablamos de procesos de extracción, limpieza de datos, embeddings personalizados e integración con tu agente.
¿Cómo subo un PDF a una base de datos vectorial en OpenAI?
El proceso vive en la plataforma de OpenAI, dentro de la sección storage > vector stores. Te recomiendo crear un proyecto específico para tu agente (por ejemplo, un customer support) en lugar de usar el default project [03:30].
Los pasos son:
Para el ejemplo se usó el Mobile Site Speed Playbook de Google, un PDF con buenas prácticas de performance web [03:00]. Puedes adjuntar varios archivos a la misma base, y todos quedan disponibles para consulta.
¿Cómo conecto la tool de file search en mi código?
En el notebook declaras la tool pasándole el ID de tu vector store. Defines un array (porque podrías tener varias bases vectoriales) y le indicas al modelo de OpenAI que extienda sus capacidades con esa herramienta [05:30].
Luego renombras tu large language model para que sea un modelo con tools. La diferencia es clave: ya no es solo el LLM, es el LLM más sus herramientas externas.
¿Por qué file search solo funciona con OpenAI? Porque es una tool nativa de su modelo. Si cambias a Anthropic, no sabrá qué hacer con esa declaración. Para hacerlo agnóstico necesitas un RAG desacoplado del proveedor.
¿Cómo decide el modelo cuándo usar la base vectorial?
El modelo es inteligente y hace un switch automático. Si le preguntas Hola, ¿cómo estás?, responde directo sin consultar tu base vectorial. Si le preguntas ¿cómo mejoro el rendimiento de mi website?, va al PDF, recupera la información y construye la respuesta [09:00].
Esto no lo controlas tú. El razonamiento del modelo decide cuándo invocar la tool según la pregunta. Por eso para preguntas triviales la respuesta llega más rápido, y para consultas técnicas tarda un poco más mientras hace el query vectorial.
La diferencia con un LLM sin tools es notable: sin RAG responde con su conocimiento general; con RAG responde con información afín a tus documentos. Eso lo vuelve útil para manuales de producto, guías internas o documentación específica.
¿Por qué solo enviar el último mensaje al RAG?
La tool de file search en OpenAI tiene una limitación importante: si le mandas todo el historial de mensajes, suele fallar por exceso de contexto [13:00]. La solución práctica es enviar únicamente el último mensaje del historial.
Esto tiene un costo: pierdes memoria conversacional. El agente ya no recordará tu nombre ni mensajes anteriores, salvo que inyectes contexto con técnicas de prompt. Para conversaciones largas con memoria completa, conviene saltar a un RAG más avanzado.
En el código, en lugar de pasar todo el history, tomas last_message (el último elemento del historial) y se lo envías al modelo. Mantienes el estado del chat, pero la consulta al modelo va limpia.
¿Cómo integro el RAG en un agente de LangGraph?
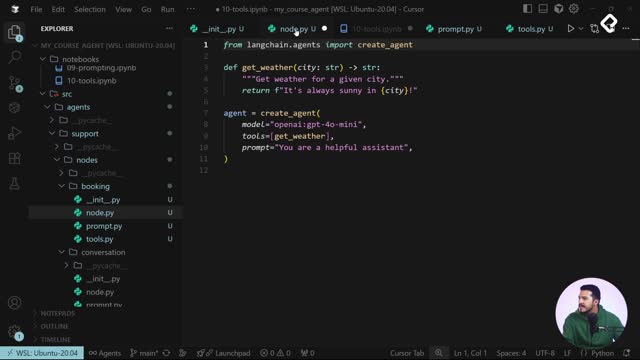
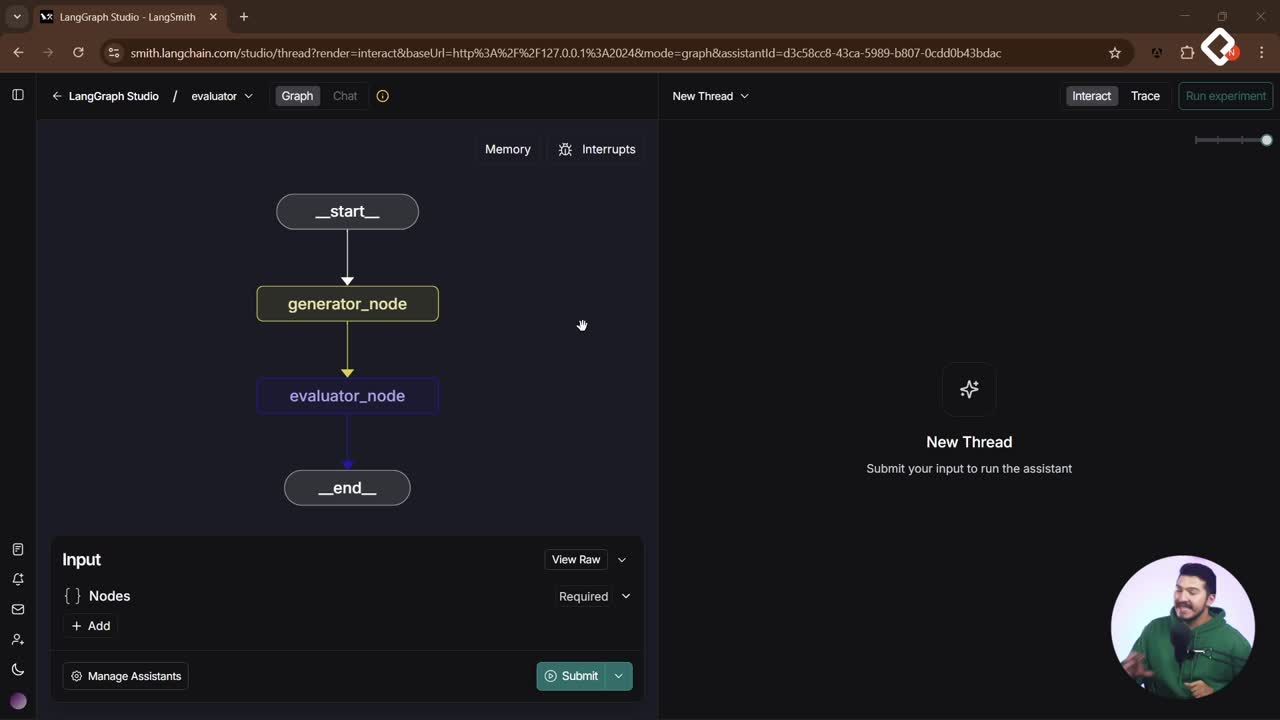
Duplicas el archivo simple.py y lo renombras como rag.py. Le agregas la declaración del file search tool, sobrescribes el LLM con la versión que tiene tools y ajustas el envío para usar solo el último mensaje [12:30].
Después registras el nuevo agente en el archivo langapp.json, agregando una entrada llamada rag. Reinicias el servidor con langapp dev (matar el anterior es obligatorio) y aparece en la interfaz.
Al probarlo verás dos comportamientos: con Hola, ¿cómo estás? responde corto y directo. Con ¿sabes cómo puedo mejorar un website? hace la consulta vectorial y devuelve recomendaciones extraídas literalmente del PDF cargado.
Un caso típico: imagina que cargas el manual de unos audífonos. Si preguntas ¿cómo conecto mi auricular?, el modelo no lo sabría por entrenamiento, pero al alimentarlo con el PDF te responde paso a paso porque esa información ya forma parte de su conocimiento contextual.
¿Ya probaste a subir tus propios manuales o documentos? Cuéntame qué tipo de RAG estás construyendo y qué retos te has encontrado.
Entiendo que con esta clase ha habido un problema:
Cuando intento reproducir lo que ha hecho el profesor en el que llama al llm sin incluir las tools. El resultado es correcto, pero no consulta los documentos, responde sobre su base de conocimiento:

Pero cuando intento hacer la llamada con el "llm_with_tools", el resultado es muy diferente:

Aunque en el Graph si que muestra la respuesta, pero no en el chat.

Para conseguir el mismo resultado en el chat he tenido que modificar un poco el codigo con un bucle for que recorra los diccionarios devueltos, uno con la llamada a la tool y otro con la respuesta. Y evaluar cual tiene "text", consiguiendo asi la respuesta en el chat sin problema.
last_message = history[-1].text ai_message = llm_with_tools.invoke(last_message) text_content = "" for block in ai_message.content: if isinstance(block, dict) and "text" in block: text_content += block["text"] elif isinstance(block, str): text_content += block # Reemplazamos el contenido complejo con el texto plano ai_message.content = text_content new_state["messages"] = [ai_message] # Al devolver el nuevo state, se actualiza la memoria del agente return new_state
Ahora el resultado ya es correcto. Y basado en la información aportada.

Espero que esto pueda ayudar a alguién que haya tenido los mismo problemas que yo.
Juan R Rossano
¿Hay alguna guia de las tools de los otros modelos, como Gemini o groq?
Jhonatan Estiven Becerra Pedrozo

Porque me arroja esto y en jupyter si sale bien?

Martín Nicolás
He estado luchando con lo mismo un rato con el mismo problema mi chat se rompia sin acusar un error aparente.
Resumen del problema:
Bloque de codigo
# Node
def node_1(state: State):
new_state: State = {}
if state.get("customer_name") is None:
new_state["customer_name"] = "John Doe"
else:
new_state["my_age"] = random.randint(20,30)
history = state["messages"]
last_message = history[-1]
# Extraer el contenido del mensaje - puede ser str o dict
if isinstance(last_message.content, str):
message_text = last_message.content
elif isinstance(last_message.content, dict):
message_text = last_message.content.get('text', '')
elif isinstance(last_message.content, list):
# Si es lista, tomar el texto del primer elemento
message_text = last_message.content[0].get('text', '') if last_message.content else ''
else:
message_text = str(last_message.content)
ai_message = llm.invoke(message_text)
# Extraer solo el texto de la respuesta
if isinstance(ai_message.content, list):
text_content = "".join(block.get('text', '') for block in ai_message.content if isinstance(block, dict) and block.get('type') == 'text')
else:
text_content = ai_message.content
new_state["messages"] = [AIMessage(content=text_content)]
return new_state
Espero que a alguien mas le sirva.
Saludos!

Sergio Toro Escofet

JOSE DIAZ
Por que no me sale nada del lado chat? Del lado Graph si me sale
JOSE DIAZ


Earvin Saúl Pérez Ramos
El comentario mas arriba ya propuso una solucion
JOSE DIAZ
No entiendo, me sale que esta escribiendo, me sale el mensaje, luego lo quita y sale "no data"
Esta fue mi solución con Gemini, como aprendizaje previo tengo el curso de agentes de Platzi que no lo encontré tan bueno como este del profe pero me dió las bases para hoy llegar a esta solución. Cabe destacar que no es perfecta, si ejecutas dos veces el grafo sin introducir un nuevo HumanMessage desde Langsmith se rompe el grafo porque espera la pregunta humana para el retriver, es completamente manejable pero no era mi objetivo en el ejercicio.
from langchain_core.messages import SystemMessage, HumanMessage from langgraph.graph import MessagesState from langchain_google_genai import GoogleGenerativeAIEmbeddings from langchain_core.runnables import RunnablePassthrough, RunnableLambda from langchain_community.document_loaders import PyPDFLoader from langchain_community.vectorstores import FAISS from dotenv import load_dotenv from langchain.chat_models import init_chat_model from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder import random load_dotenv() from pathlib import Path CURRENT_DIR = Path(__file__).resolve().parent PROJECT_ROOT = CURRENT_DIR.parent.parent pdf_path = PROJECT_ROOT / "docs" / "Mobile_Site_Speed_Playbook.pdf" print("Ruta resuelta:", pdf_path) print("Existe:", pdf_path.exists()) loaderPdf = PyPDFLoader(pdf_path) pages = loaderPdf.load_and_split() embeddings = GoogleGenerativeAIEmbeddings(model='models/gemini-embedding-2') model = init_chat_model(model_provider = "google_genai", model="gemini-3.1-pro-preview") vector_store = FAISS.from_documents(pages, embeddings) retriever = vector_store.as_retriever() system_prompt = """ Eres un experto en optimización de sitios webs. Responde usando SOLO el siguiente contexto: {context} """ prompt = ChatPromptTemplate.from_messages([ ("system", system_prompt), MessagesPlaceholder("history") ]) def format_docs(docs): return "\n\n".join(doc.page_content for doc in docs) def get_last_question(messages: list) -> str: """Extrae el texto del último mensaje, para usarlo como query del retriever.""" return messages[-1].content llm_with_rag = ( { "context":RunnableLambda(get_last_question) | retriever | format_docs, "history": RunnablePassthrough() } | prompt | model ) class State(MessagesState): customer_name: str age: int def node_01(state : State): new_state : State = {} if state.get("customer_name") is None: new_state["customer_name"] = "Jhon Doe" else: new_state["age"] = random.randint(18, 65) history = state["messages"] if not history: history = [HumanMessage(content="¿Cómo mejoro la velocidad de mi sitio?")] print(f"History Messages: {history}") ai_message = llm_with_rag.invoke(history) new_state["messages"] = [ai_message] return new_state from langgraph.graph import StateGraph, START, END builder = StateGraph(State) builder.add_node("node_01", node_01) builder.add_edge(START, "node_01") builder.add_edge("node_01", END) agent = builder.compile()