





Diego Alejandro Lesmes
:green_heart: Suavización o estimador kernel para estimar la función de densidad de probabilidad en R
¿Qué es la estimación funcional?
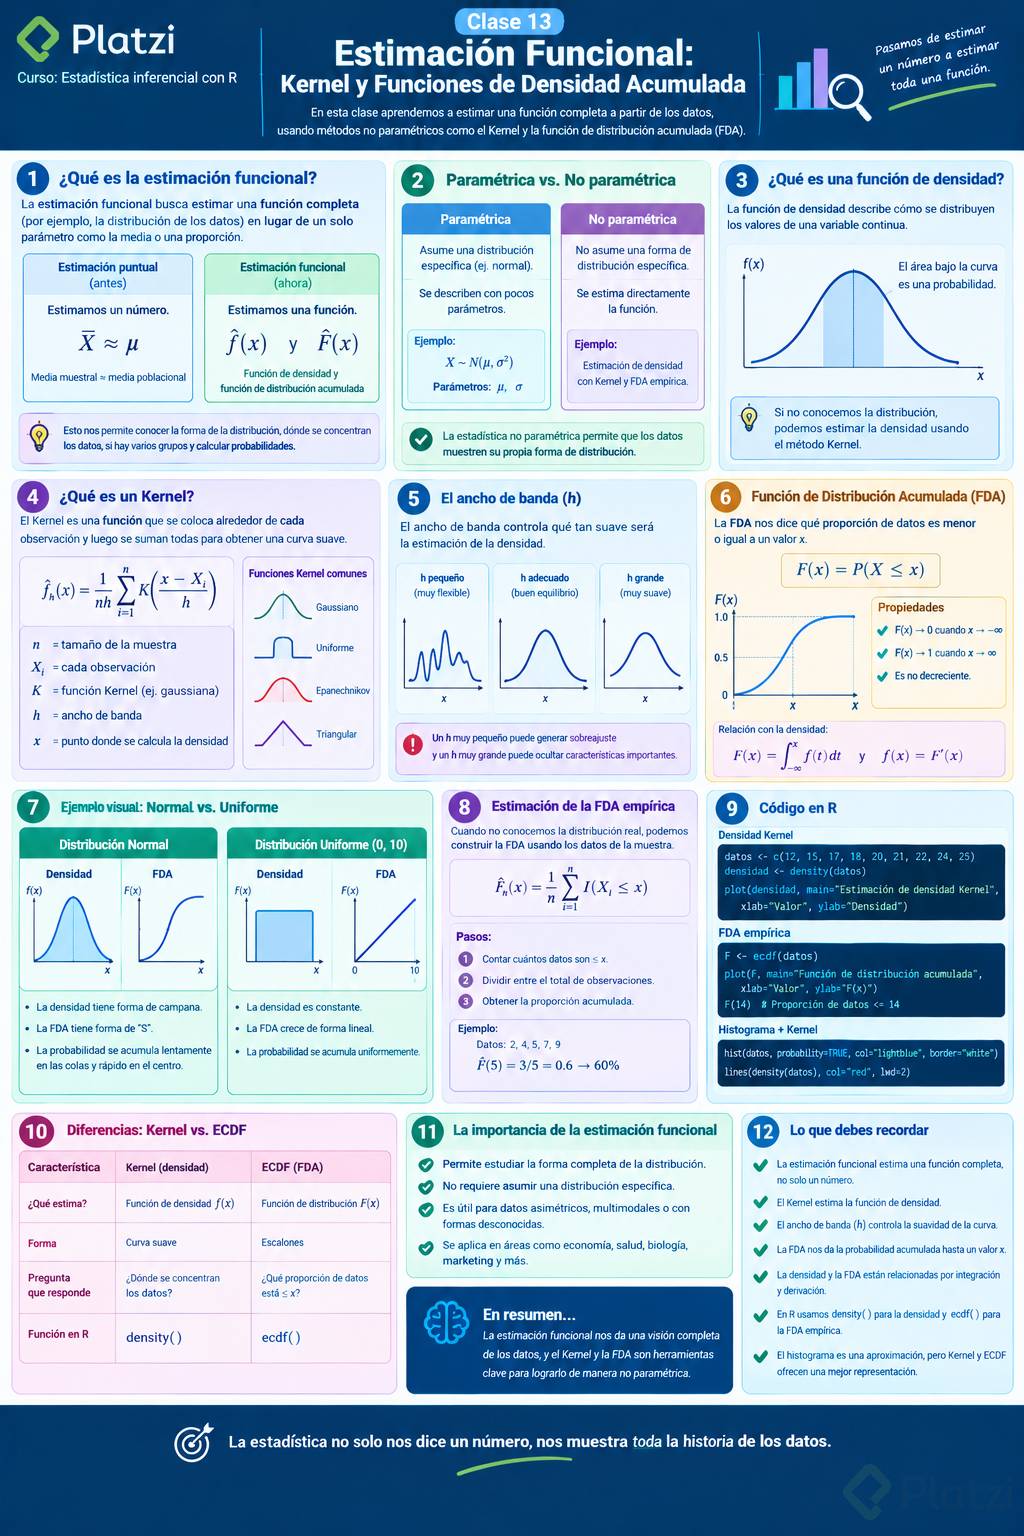
La estimación funcional es una herramienta poderosa en la estadística no paramétrica. A diferencia de los modelos paramétricos que se manejan con un número finito de parámetros, los modelos no paramétricos operan dentro de espacios vectoriales de dimensión infinita: los espacios de funciones. Este enfoque nos permite estimar características específicas de una población, como las funciones de densidad o distribución, sin asumir una forma para la función subyacente de los datos.
¿Cómo se estiman las funciones de densidad?
Un buen ejemplo de una función de densidad es la famosa campana de Gauss de la distribución normal. Aquí, el objetivo es, a partir de una muestra, estimar esta densidad que representa cómo se distribuyen los datos. Para lograr tal estimación, existen dos métodos principales:
Método del Kernel: Este es utilizado para estimar la densidad. A partir de los datos recolectados, este método formula una estimación que se aproxima a la curva teórica de la distribución.
Funciones de Distribución Acumulada (FDA): Estas permiten calcular la probabilidad acumulada hasta cierto punto en particular. La FDA de una variable normalmente distribuida comienza en cero y termina en uno, incrementándose progresivamente.
Para ilustrar su aplicación, consideremos la diferencia entre la distribución normal y la uniforme. La FDA normal es una integral de su función de densidad, otorgando una curva suavemente ascendente. En cambio, la FDA para una distribución uniforme mantiene un ascenso uniforme, comenzando también en cero y finalizando en uno.
¿Cómo se ve una estimación kernel?
El estimador kernel se enfrenta a ciertos desafíos dependiendo del tipo de distribución con la que trabajamos. En el caso de una distribución normal, la estimación kernel puede lograrse representándola con una curva que se aproxima a la forma teórica. Sin embargo, para una distribución uniforme, esta aproximación no resulta tan precisa. Más adelante, con datos simulados, será posible entender las razones específicas de estas variaciones.
¿Qué es una función empírica de densidad acumulada?
La función empírica de densidad acumulada (FDA empírica) se representa como una especie de "escalera". Su característica principal es que se ajusta considerablemente bien a las funciones de densidad acumulada teóricas tanto en casos normales como uniformes. Gracias a esta precisión y adaptación visual, se convierte en una herramienta fantástica para análisis exploratorios de datos. Además, en los recursos adicionales, se incluye un artículo que detalla cómo interpretar estas curvas para un análisis más profundo.
¿Qué nuevos horizontes se abren en la estimación funcional?
En futuras secciones, la estimación funcional se expandirá para abordar múltiples variables simultáneamente. Además, se explorará la estimación funcional específicamente para el valor esperado condicional, lo que promete ampliar aún más nuestras capacidades estadísticas. ¡La estadística no paramétrica abre nuevas puertas al conocimiento!
--> FUNCIÓN DE DENSIDAD:PDF
Es una herramienta estadística utilizada para describir la distribución de probabilidades de una variable aleatoria continua. Esta función muestra cómo se distribuyen los valores de una variable en un rango de valores posibles.A menudo se representa gráficamente mediante una curva suave, conocida como una curva de densidad o histograma suavizado.
La función de densidad tiene las siguientes características:
-->FUNCIÓN DE DENSIDAD ACUMULADA:CDF
Conocida tambien como funcion de distribucion acumulada, La función de distribución acumulada (FDA) es una función que indica la probabilidad de que una variable aleatoria tome un valor menor o igual que un valor dado. La función de distribución acumulada se representa con una curva que muestra cómo se acumulan las probabilidades de los valores posibles de la variable aleatoria.
--> ESTIMADORES
-- ++Kernel:++ Estima la funcion de densidad de una variable aleatroia a partir de una muestra de datos.Asigna una función llamada kernel a cada dato y las suma. Sigue la siguiente formula:
f^(x)=(1/nh)*∑K((x-xi))
Donde:
--++Funcion de densidad acumulada empirica ECDF:++ Es una función que estima la funcion de distribucion acumulada CDF. La FDAE se construye asignando una probabilidad igual a 1/n a cada dato de la muestra, donde n es el número de datos, y sumando las probabilidades de los datos menores o iguales que un valor dado
Diego Alejandro Lesmes
:green_heart: Suavización o estimador kernel para estimar la función de densidad de probabilidad en R

PAULA ACOSTA

Jhon Freddy Tavera Blandon

Jhon Freddy Tavera Blandon
La estimación funcional se centra en la inferencia sobre una función desconocida a partir de datos observados, en lugar de simplemente estimar un conjunto finito de parámetros. Cuando se trata de una sola variable, esto puede implicar, por ejemplo, la estimación de la función de densidad de probabilidad de una variable aleatoria o la forma de una curva de regresión.
Ejemplos de estimación funcional de una sola variable: