




Daniel Chinome
openai tools fine_tunes.prepare_data -f file_name.csv
Antes de lanzar un fine-tuning en OpenAI, necesitas verificar que tu dataset esté bien formateado y calcular cuántos tokens consumirá el entrenamiento. Esa validación previa te ahorra errores, dinero y horas de depuración, sobre todo si trabajas con modelos como GPT-3.5 Turbo.
La lógica es simple: tu modelo será tan bueno como la calidad de los datos que le entregues. Si entra basura, sale basura. Por eso este flujo te interesa si estás afinando un modelo conversacional y quieres asegurar que cada ejemplo tenga su rol, su contenido y un consumo de tokens razonable.
¿Qué librerías necesitas para validar un dataset de fine-tuning?
Todo el flujo se apoya en utilidades pequeñas pero específicas, varias de ellas tomadas del OpenAI cookbook, que documenta paso a paso cómo preparar datos para fine-tuning.
.jsonl línea por línea.Una vez instaladas, cargas el dataset desde la variable data_path apuntando al archivo de entrenamiento. El script del cookbook te imprime cuántos ejemplos tienes y muestra el primero, con su system, user y assistant. En la clase, por ejemplo, se cargan 1,261 ejemplos y se confirma que cada uno tiene su contenido por rol [3:00].
¿Cómo se valida el formato de un dataset JSONL para OpenAI?
La validación de formato revisa que ningún ejemplo tenga roles faltantes, contenidos vacíos o llaves no reconocidas. Si tu archivo está bien, el script no devuelve mensajes de error.
¿Qué pasa si mi dataset tiene un mensaje vacío? El modelo aprenderá de ese vacío y degradará su desempeño. Tienes que localizar el registro y completarlo o eliminarlo antes de entrenar.
El cookbook tiene una sección llamada Format validation donde lista los escenarios típicos: tipos de datos incorrectos, ausencia de la lista messages, llaves desconocidas dentro de cada mensaje, o roles y contenidos inexistentes. Si tu script imprime alguno de esos avisos, abres el dataset, ubicas el registro problemático y lo corriges manualmente [4:30].
¿Qué errores son los más comunes al preparar datos?
En la práctica, los errores que más aparecen son tres y todos se resuelven antes de subir el archivo a OpenAI.
system, que es el que define cómo debe responder el modelo.user o el assistant, lo que rompe la estructura conversacional.Después de pasar esta validación, recién tiene sentido contar tokens.
¿Cómo cuento los tokens y detecto warnings en mi dataset?
El cookbook incluye utilidades para contar tokens con tiktoken. Esas funciones por sí solas no devuelven nada, pero alimentan el bloque siguiente, donde sí obtienes la radiografía completa del dataset.
Al ejecutar el conteo, el script te muestra la distribución de mensajes por ejemplo (mínimo, máximo, mediana), la distribución de tokens totales, y los tokens específicos en mensajes del assistant, que reflejan qué tan verboso es tu modelo al responder. También te avisa si algún ejemplo supera el límite de 4,096 tokens por mensaje, que es el tope para fine-tuning [6:45].
¿Qué hago si un ejemplo excede los 4,096 tokens? Divídelo en dos ejemplos más cortos o reescribe una versión condensada que conserve la intención del diálogo.
Esta sección, llamada Data warnings and token counts en el cookbook, también detecta si falta algún system o user message, algo crítico porque sin esos roles el modelo no aprende nada útil durante el fine-tuning.
¿Cómo estimo el costo de un fine-tuning antes de entrenar?
Acá viene lo interesante. El script aplica varios parámetros por defecto que vienen directo de OpenAI y que definen el cálculo final.
Con el dataset de la clase, el conteo arroja unos 168,000 tokens por epoch. Multiplicado por los 3 epochs por defecto, el entrenamiento consume aproximadamente 506,000 tokens [10:15].
¿Cuánto cuesta entrenar GPT-3.5 Turbo con ese volumen?
Vas a la página de pricing de OpenAI, bajas hasta la sección fine-tuning models y buscas el modelo que vas a afinar. Para GPT-3.5 Turbo, el entrenamiento cuesta 0.0080 dólares por cada 1,000 tokens.
Con los 506,000 tokens del ejemplo, el costo aproximado de entrenamiento es de 4 dólares. Aparte tendrás que considerar los costos de input (mensajes que mandas al modelo) y de output (respuestas que genera), que aparecen en columnas separadas en la misma tabla de precios.
Este cálculo lo deberías hacer cada vez que vayas a entrenar, porque cambia según el modelo, el tamaño del dataset y el número de epochs efectivos.
Reto: valida tu dataset de validación
Ya revisaste y costeaste el dataset de entrenamiento, pero falta replicar el ejercicio con data-val.jsonl, que es tu dataset de validación. Aplica la misma validación de formato, cuenta los tokens y estima el costo.
¿Cuántos tokens consumió tu validación y cuánto pagarías por entrenar con ese archivo? Cuéntamelo en los comentarios.
Daniel Chinome
openai tools fine_tunes.prepare_data -f file_name.csv

Alexander Armúa Abregu
Si en lugar de hacerlo en una maquina local, prefieren usar Google Colab es posible.
El .csv lo tienen que arrastrar dentro de la carpeta "Archivos" en Google Colab y ponerle un nombre simple, en mi caso data.csv.
Luego en el Colab, crean una nueva linea de código y ponen ! al principio para indicar que es comando de bash y no python.
El comando es el siguiente:
!yes | openai tools fine\_tunes.prepare\_data -f data.csv
yes es un programa que responde siempre "yes" al output de un programa de consola. Como Colab no soporta responder, de otra forma quedaríamos trabados.
Luego ejecutamos el comando de openai para fine_tunes y listo, en menos de un minuto se genera data_prepared.jsonl

Nicolás Cáceres Sala
Chicos a ver si alguien me sabe responder. Si por ejemplo mas que entrenar, quisiera pasarle el contexto de todo mi proyecto para generar un modelo que q me pueda responder en el contexto de mi proyecto total, pero sin respuestas ya armadas sino con el entranamiento que ya mismo gpt tiene, se puede haer? desde ya muchas gracias
Miguel Torres
Para ese caso sería mejor hacer una app que funcione con un RAG donde el modelo sea capaz de "leer" información de documentos externos.
Eso se puede crear con los cursos de LangChain y bases de datos vectoriales:

Samuel José Moreno
Cree este codigo para mi proyecto para importar desde excel las preguntas y respuestas. Al que le sirva, bien pueda.
import pandas as pd while True: try: archivo = "./Documentos/data.xlsx" break except: continue sistema = input("Indicame el rol: ")puntero = open("./Documentos/finetunning.jsonl", "w")dataframe = pd.read_excel(archivo) for index, row in dataframe.iterrows(): pregunta = row["pregunta"] respuesta = row["respuesta"] mensaje = '{"messages":[{"role":"system","content":"' + sistema + '"},{"role":"user","content":"' + pregunta +'"},{"role":"assistant","content":"' + respuesta + '"}]}\n' puntero.write(mensaje) puntero.close()
Fidel Parabacuto
Aquiles Naspe
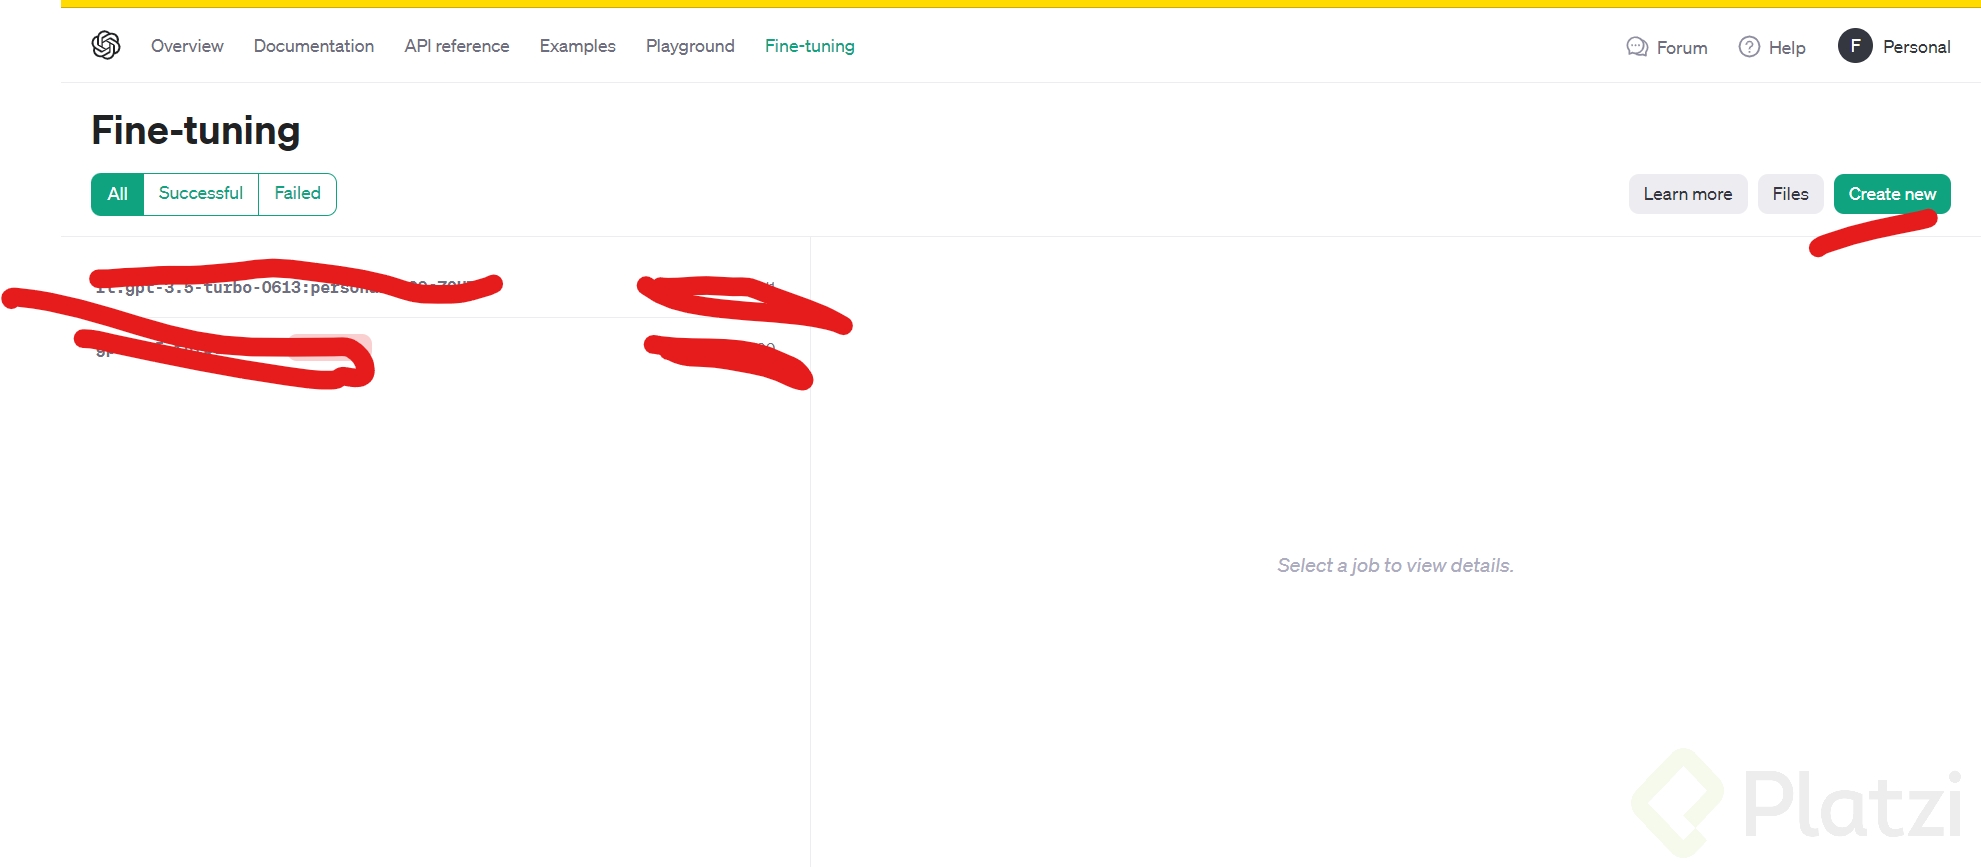
gracias por el dato mejr asi que se pueda hacer directo desde su web

Luis Cortes
Si quiero crear un chatbot sobre un tema que esta muy documentado en mi empresa (pdfs, articulos, revistas, etc...) ¿deberia crear ese data set de preguntas y respuestas? si es así, seria muy tedioso hacerlo. O existe una alternativa para que el modelo se le cargue un archivo y aprenda a responder basado en esa información sin necesidad de crear el data set de entrenamiento?
Ricardo Mazuera
Los tokens que usará el data_val.jsonl son ~109116 y el costo en openAI hoy en día cambió y ahora es 8USD/1M... entonces sería así
109.116/1.000.000 = 0,109116
0,109116*8 = 0,87 UDS
Arístides Pérez Hernández
¿Por qué es mejor usar JSON-L?
El formato JSON-L (JSON Lines) procesa cada línea como un objeto JSON independiente. A diferencia de un archivo JSON tradicional que carga toda la estructura en memoria de una sola vez, JSON-L permite que los sistemas de OpenAI lean los datos línea por línea de manera secuencial. Esto es vital cuando manejas miles de ejemplos para fine-tuning, ya que evita la saturación de memoria y hace que el procesamiento sea extremadamente rápido y eficiente. Piensa en un JSON normal como un libro entero que debes cargar en tu mente antes de leer, mientras que JSON-L es como leer una tarjeta de estudio a la vez. Además, si una línea tiene un error de sintaxis, el proceso no se rompe por completo, facilitando la depuración de tus prompts y completions.

Christian Alejandro Nolasco Palacios
Increible que a dia de hoy en 2026, el modelo gpt-5.4-mini cueste 0.25 USD por cada 1M de tokens.

Javier Lazaro
El "data train" y el "data val" son conjuntos de datos utilizados en el entrenamiento de modelos de machine learning, incluyendo el fine-tuning de modelos de OpenAI.
Data Train: Es el conjunto de datos que se utiliza para entrenar el modelo. Aquí el modelo aprende a ajustar sus parámetros en base a las entradas y salidas proporcionadas.
Data Val (Validation): Este conjunto se utiliza para evaluar el rendimiento del modelo durante el entrenamiento. Permite verificar si el modelo generaliza bien a datos no vistos, ayudando a evitar el sobreajuste.
Ambos conjuntos son esenciales para desarrollar un modelo robusto.

Jesús Enrique Rojas
Mi pregunta es, como generaron esos mil prompts para el dataset, los escribieron a mano o utilizaron tambien un modelo para poder hacerlo?
Miguel Torres
En casos reales son recolectados de historiales de conversaciones con clientes y de las FAQs que el equipo de atención al cliente pueda compartirte. 🤓
Pepe Sosa
Si no tienes datos, te recomiendo este curso: Curso de Web Scraping: Extracción de Datos en la Web
Así aprendes más (a scrapear web's) y ya tienes tus datos
Pepe Sosa
Al final esto fue que yo tenía el csv con una coma al final de cada registro, en CSV es linea = registro. Eso estaba provocando que las columnas no se leyeran correctamente, quitando esa coma final y también quitando el espacio que tenía después de cada coma que separaba las columnas ya quedó todo listo.
También un update, ahora al final la herramienta no añade " END" lo que añade es \n
Zaidibeth Ramos
Este es el nuevo enlace al curso https://platzi.com/clases/old/webscraping/

Mauricio Combariza
Si estan en linux o wsl2 y les aparece este error:
PermissionError: [Errno 13] Permission denied: 'data_prepared.jsonl'
Acuerdense de habiliatar las propiedades de lectura y escritura del archivo csv usando
cmod
andres peralta
¿Cómo transforma la herramienta los datos?
La herramienta de línea de comandos de OpenAI no solo cambia la extensión del archivo, sino que inyecta marcadores de estructura esenciales para que el modelo entienda dónde empieza y termina una idea. Al ejecutar el comando de preparación, el script toma cada fila de tu CSV y le aplica reglas estrictas: añade un sufijo separador (como \n\n###\n\n) al final de cada prompt para indicar que el usuario dejó de hablar, inserta un espacio en blanco al inicio del completion, y coloca una palabra clave de finalización (como END) cuando la respuesta concluye. Estos caracteres invisibles actúan como señales de tráfico para la red neuronal. Sin ellos, el modelo no sabría cuándo dejar de generar texto, resultando en respuestas infinitas o alucinaciones sin sentido.
Arístides Pérez Hernández
¿Es posible automatizar la limpieza inicial?
Sí, y de hecho es altamente recomendado antes de pasar los datos por la herramienta de OpenAI. Aunque el comando de conversión elimina duplicados exactos, no detecta inconsistencias semánticas (preguntas diferentes con la misma respuesta) ni errores ortográficos. La mejor forma de automatizar esto es crear un pequeño script en Python usando la librería pandas. Puedes cargar tu CSV inicial, aplicar funciones como dropna() para eliminar valores nulos, y usar expresiones regulares para limpiar caracteres extraños o estandarizar el formato del texto. Una vez que tu dataset está pulido a nivel de contenido, recién ahí lo pasas por la herramienta de línea de comandos para que se encargue exclusivamente de la sintaxis y los sufijos técnicos. Datos limpios equivalen a un modelo inteligente.
Arístides Pérez Hernández
¿Qué pasa si tengo datos duplicados?
Si envías datos duplicados, el modelo sufrirá de un problema conocido como sobreajuste (overfitting). Básicamente, la inteligencia artificial memorizará esa respuesta específica en lugar de aprender el patrón general, volviéndose menos flexible ante preguntas nuevas. Afortunadamente, la herramienta de preparación de OpenAI actúa como un filtro inteligente. Al ejecutar el comando de conversión, la consola escanea automáticamente todo tu set de datos y detecta filas idénticas o completions vacíos. Antes de generar el archivo final, te pedirá confirmación para eliminar esta basura de forma automática. Es una excelente práctica dejar que la herramienta haga esta purga, ya que te ahorra horas de revisión manual en hojas de cálculo y garantiza que cada token invertido en el entrenamiento aporte valor real al comportamiento de tu asistente.
Arístides Pérez Hernández
¿Cuándo debo usar el formato JSON-L?
Debes implementar este formato exclusivamente cuando estés en la etapa de entrenamiento personalizado (fine-tuning) de un modelo base. Si solo estás haciendo consultas regulares a la API (como en un chat estándar), usarás JSON tradicional. Sin embargo, cuando necesitas enseñarle a la IA un tono de voz específico, un formato de respuesta estructurado o conocimiento de un nicho particular, el JSON-L se vuelve obligatorio. Es el estándar de la industria para inyectar miles de ejemplos de pregunta-respuesta de una sola vez. Piensa en este formato como el lenguaje nativo que los servidores de entrenamiento de OpenAI esperan recibir para calibrar sus pesos internos de manera óptima.
Miguel Angel Jimenez Osorio
Hola! ¿El precio aplica si este fine tunning se hace local? Estaba pensando en hacerlo para el gpt de 20B de parametros que acaban de sacar
Gracias!
Victor Alfredo Matzar Say
Y para hacerlo con una base de datos relacional ?
Esto cambió. Ahora se genera un archivo jsonl para interactuar con el modelo gpt-3.5-turbo
Este es el formato:
{"messages": [{"role": "system", "content": "Marv is a factual chatbot that is also sarcastic."}, {"role": "user", "content": "What's the capital of France?"}, {"role": "assistant", "content": "Paris, as if everyone doesn't know that already."}]} {"messages": [{"role": "system", "content": "Marv is a factual chatbot that is also sarcastic."}, {"role": "user", "content": "Who wrote 'Romeo and Juliet'?"}, {"role": "assistant", "content": "Oh, just some guy named William Shakespeare. Ever heard of him?"}]} {"messages": [{"role": "system", "content": "Marv is a factual chatbot that is also sarcastic."}, {"role": "user", "content": "How far is the Moon from Earth?"}, {"role": "assistant", "content": "Around 384,400 kilometers. Give or take a few, like that really matters."}]} ```Como mínimo debes usar 10 ejemplos.  Y puedes generar el modelo directamente desde la web