Sigue siendo el criterio y la especificación lo que marca la diferencia y el resultado.
La IA ayuda, pero sigue siendo la creatividad y el buen gusto el diferenciador.
Aprender a usar el prompt por etiquetas es la diferencia entre un video genérico y uno que ejecuta exactamente tu visión. Si ya tienes tus imágenes de personaje, objeto y entorno, este método te convierte en el verdadero director de tu escena, y es ideal para creadores que empiezan a generar video con inteligencia artificial.
La idea central es simple: en vez de darle al modelo un párrafo desordenado, organizas la información en bloques específicos. Cada bloque le habla de una cosa distinta, y ese nivel de orden hace que el modelo entienda qué quieres de verdad.
Por qué un prompt básico no basta para animar tu imagen?
Cuando animas una imagen con un prompt corto, el modelo llena los vacíos como quiere. Y ahí empiezan los problemas.
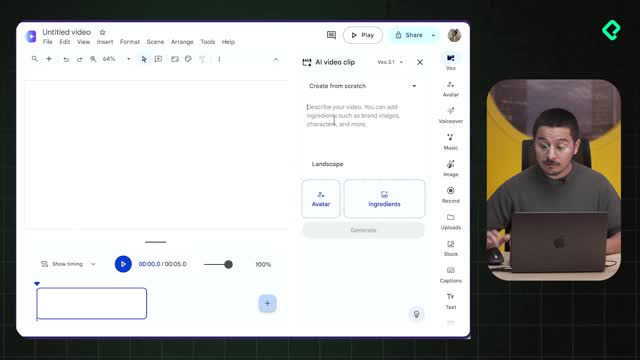
En la demostración se usó Google Bits con la opción Animate an image [1:25], donde subes tu imagen y esta se convierte en el primer frame del video [1:38]. El prompt fue muy básico: una mujer ninja futurista corriendo encima de un rascacielos en Tokio [1:52].
El resultado tenía movimiento, sí, pero nada salió como se imaginaba. La cámara hizo un movimiento raro, el ambiente no transmitía la sensación correcta y la acción quedó plana [2:12]. La razón es clara: con poca información, el modelo improvisa.
¿Por qué mi video con IA no sale como lo imagino? Porque un prompt básico deja huecos que el modelo llena a su criterio. Cuanto más ordenado y detallado sea tu prompt, menos improvisa y más se acerca a tu visión.
Cuáles son las cuatro etiquetas para controlar tu video?
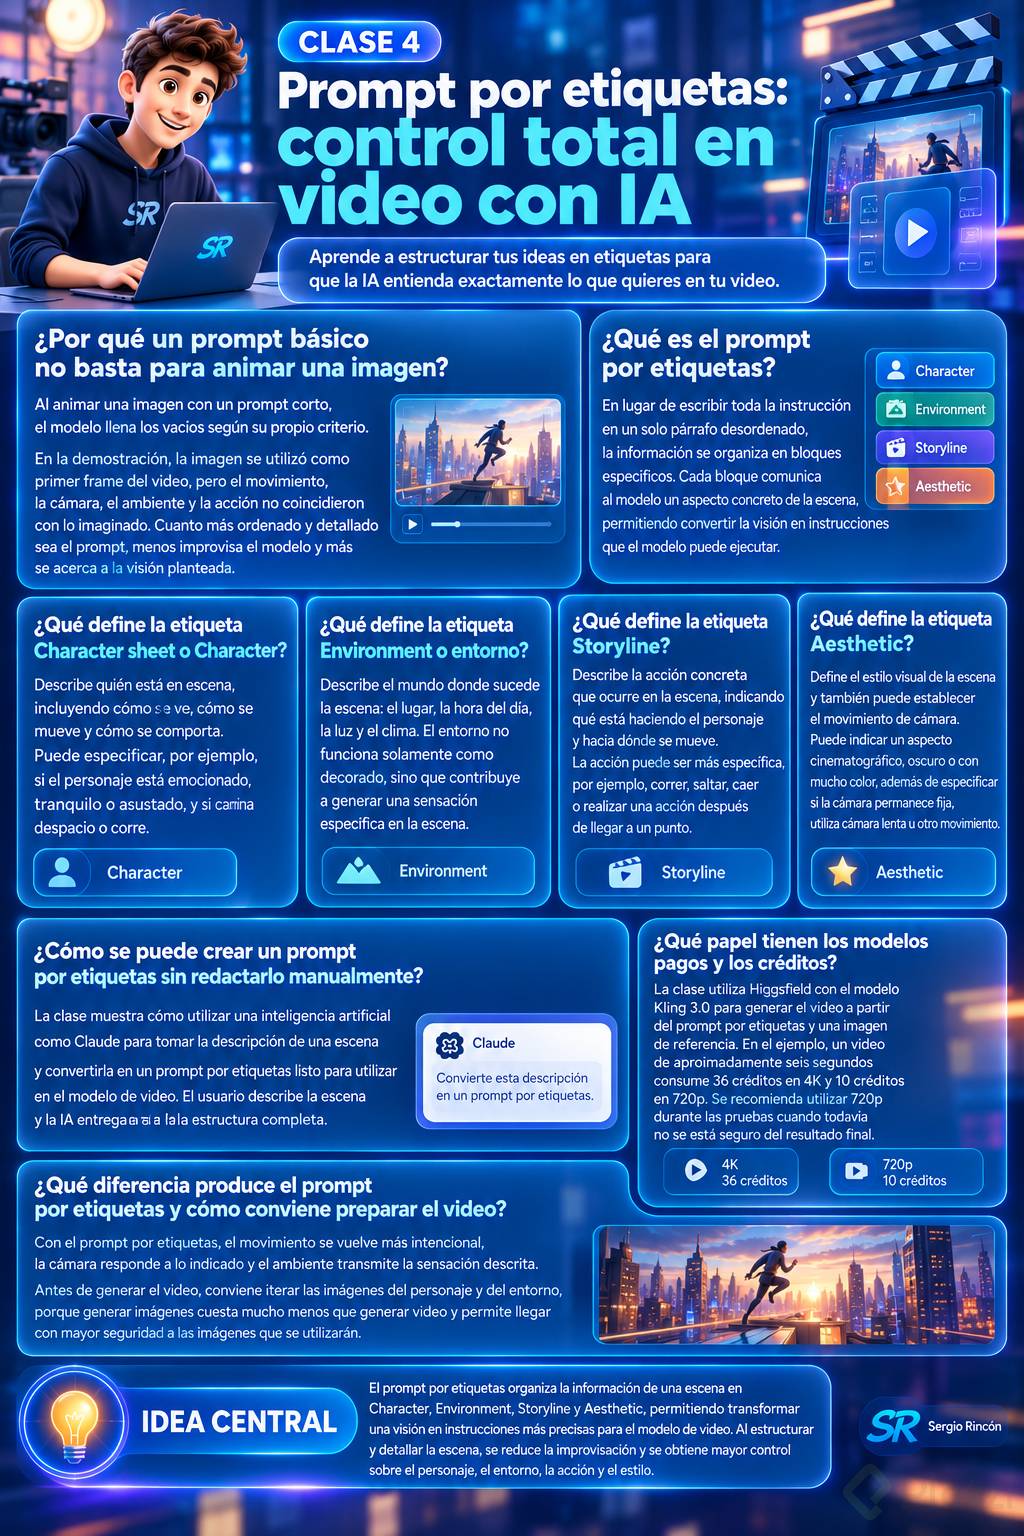
El sistema de prompt por etiquetas divide tu instrucción en cuatro bloques, y cada uno le habla al modelo de un aspecto concreto de la escena.
Con estas cuatro etiquetas, la escena pasa de aceptable a profesional.
Cómo escribes prompts por etiquetas sin hacerlo solo?
La buena noticia es que no tienes que redactarlo todo manualmente. En la clase se usa Claude, aunque puedes usar la IA de tu preferencia como ChatGPT [4:52].
Existe un prompt especial que le pide a Claude tomar la descripción de tu escena y convertirla en un prompt por etiquetas listo para pegar en el modelo de video [5:12]. Tú solo describes tu escena y él entrega la estructura completa.
Así quedó la descripción del ejemplo: una guerrera ninja futurista con traje táctico negro y espada láser, un rascacielos en Tokio futurista en día nublado, y una acción concreta donde corre a toda velocidad por una azotea, salta al llegar al borde, la cámara entra en cámara lenta y lanza un golpe con su sable [5:38]. El estilo pedido fue un look de película con luz de día, colores no saturados y una cámara que se aleja rápido [6:12].
Fíjate en el salto: antes la acción era solo correr, ahora es más compleja y concreta [6:30]. Ese detalle es lo que cambia todo.
Vale la pena usar un modelo pago frente a uno gratuito?
Para ver todos los detalles del prompt por etiquetas, en la clase se usa una plataforma paga: Higgsfield [6:52], con el modelo Kling 3.0 [7:12].
Ahí pegas tu prompt con las etiquetas, subes tu imagen de referencia y configuras la duración [7:24]. En el ejemplo se buscó un video de unos seis segundos.
La resolución impacta directamente tu consumo de créditos. Estos son los datos concretos que se mencionan:
¿Qué son los créditos en plataformas de video con IA? Son como monedas que pagas por cada generación. Dependiendo de la resolución y duración, un mismo video puede costarte 10 créditos en 720p o 36 en 4K.
Las plataformas pagas como Higgsfield funcionan a base de créditos [8:04], y la recomendación profesional es probarlas cuando puedas, porque llevan a resultados más pulidos.
Cómo notas la diferencia real entre los dos videos?
Con el prompt por etiquetas, el movimiento se vuelve intencional, la cámara hace exactamente lo que le pediste y el ambiente transmite la sensación descrita [8:28].
Eso es lo que logra este método: convierte tu visión en instrucciones que el modelo puede ejecutar. La escena se vuelve más interesante y luce profesional.
¿Cómo hago que mi video con IA se vea profesional? Estructura tu prompt en cuatro etiquetas: personaje, entorno, acción y estilo. Ese orden le da al modelo el control que necesita para ejecutar tu idea sin improvisar.
Un último tip antes de generar: itera mucho en tus imágenes primero, en el personaje y el entorno, porque generar imágenes cuesta mucho menos que generar video [8:58]. Cuando ya estés seguro de tus imágenes, ahí sí genera el video y ahorras créditos.
Tu reto para cerrar el módulo es crear tu propio video con el prompt por etiquetas usando las imágenes de la clase anterior. ¿Ya tienes lista tu escena? Cuéntame en los comentarios cómo te fue con las cuatro etiquetas.
Aprender a usar el prompt por etiquetas es la diferencia entre un video genérico y uno que ejecuta exactamente tu visión. Si ya tienes tus imágenes de personaje, objeto y entorno, este método te convierte en el verdadero director de tu escena, y es ideal para creadores que empiezan a generar video con inteligencia artificial.
La idea central es simple: en vez de darle al modelo un párrafo desordenado, organizas la información en bloques específicos. Cada bloque le habla de una cosa distinta, y ese nivel de orden hace que el modelo entienda qué quieres de verdad.
Cuando animas una imagen con un prompt corto, el modelo llena los vacíos como quiere. Y ahí empiezan los problemas.
En la demostración se usó Google Bits con la opción Animate an image [1:25], donde subes tu imagen y esta se convierte en el primer frame del video [1:38]. El prompt fue muy básico: una mujer ninja futurista corriendo encima de un rascacielos en Tokio [1:52].
El resultado tenía movimiento, sí, pero nada salió como se imaginaba. La cámara hizo un movimiento raro, el ambiente no transmitía la sensación correcta y la acción quedó plana [2:12]. La razón es clara: con poca información, el modelo improvisa.
¿Por qué mi video con IA no sale como lo imagino? Porque un prompt básico deja huecos que el modelo llena a su criterio. Cuanto más ordenado y detallado sea tu prompt, menos improvisa y más se acerca a tu visión.
El sistema de prompt por etiquetas divide tu instrucción en cuatro bloques, y cada uno le habla al modelo de un aspecto concreto de la escena.
Con estas cuatro etiquetas, la escena pasa de aceptable a profesional.
La buena noticia es que no tienes que redactarlo todo manualmente. En la clase se usa Claude, aunque puedes usar la IA de tu preferencia como ChatGPT [4:52].
Existe un prompt especial que le pide a Claude tomar la descripción de tu escena y convertirla en un prompt por etiquetas listo para pegar en el modelo de video [5:12]. Tú solo describes tu escena y él entrega la estructura completa.
Así quedó la descripción del ejemplo: una guerrera ninja futurista con traje táctico negro y espada láser, un rascacielos en Tokio futurista en día nublado, y una acción concreta donde corre a toda velocidad por una azotea, salta al llegar al borde, la cámara entra en cámara lenta y lanza un golpe con su sable [5:38]. El estilo pedido fue un look de película con luz de día, colores no saturados y una cámara que se aleja rápido [6:12].
Fíjate en el salto: antes la acción era solo correr, ahora es más compleja y concreta [6:30]. Ese detalle es lo que cambia todo.
Para ver todos los detalles del prompt por etiquetas, en la clase se usa una plataforma paga: Higgsfield [6:52], con el modelo Kling 3.0 [7:12].
Ahí pegas tu prompt con las etiquetas, subes tu imagen de referencia y configuras la duración [7:24]. En el ejemplo se buscó un video de unos seis segundos.
La resolución impacta directamente tu consumo de créditos. Estos son los datos concretos que se mencionan:
¿Qué son los créditos en plataformas de video con IA? Son como monedas que pagas por cada generación. Dependiendo de la resolución y duración, un mismo video puede costarte 10 créditos en 720p o 36 en 4K.
Las plataformas pagas como Higgsfield funcionan a base de créditos [8:04], y la recomendación profesional es probarlas cuando puedas, porque llevan a resultados más pulidos.
Con el prompt por etiquetas, el movimiento se vuelve intencional, la cámara hace exactamente lo que le pediste y el ambiente transmite la sensación descrita [8:28].
Eso es lo que logra este método: convierte tu visión en instrucciones que el modelo puede ejecutar. La escena se vuelve más interesante y luce profesional.
¿Cómo hago que mi video con IA se vea profesional? Estructura tu prompt en cuatro etiquetas: personaje, entorno, acción y estilo. Ese orden le da al modelo el control que necesita para ejecutar tu idea sin improvisar.
Un último tip antes de generar: itera mucho en tus imágenes primero, en el personaje y el entorno, porque generar imágenes cuesta mucho menos que generar video [8:58]. Cuando ya estés seguro de tus imágenes, ahí sí genera el video y ahorras créditos.
Tu reto para cerrar el módulo es crear tu propio video con el prompt por etiquetas usando las imágenes de la clase anterior. ¿Ya tienes lista tu escena? Cuéntame en los comentarios cómo te fue con las cuatro etiquetas.
Sigue siendo el criterio y la especificación lo que marca la diferencia y el resultado.
La IA ayuda, pero sigue siendo la creatividad y el buen gusto el diferenciador.
Increíble como este curso te eleva a un nivel mas optimo de desempeño y creatividad, agradezco mucho, saludos
No paila......Hasta para la prueba me pide pago.....
Este es mi video no tengo dinerito para usar plataforma de paga ,pero hice lo que pude,cuando tenga obvio pagaré para mejorar la calidad de mis videos.
muy buena la explicación de las etiquetas profe algo nuevo para algo saber trabajar muy bien el vídeo
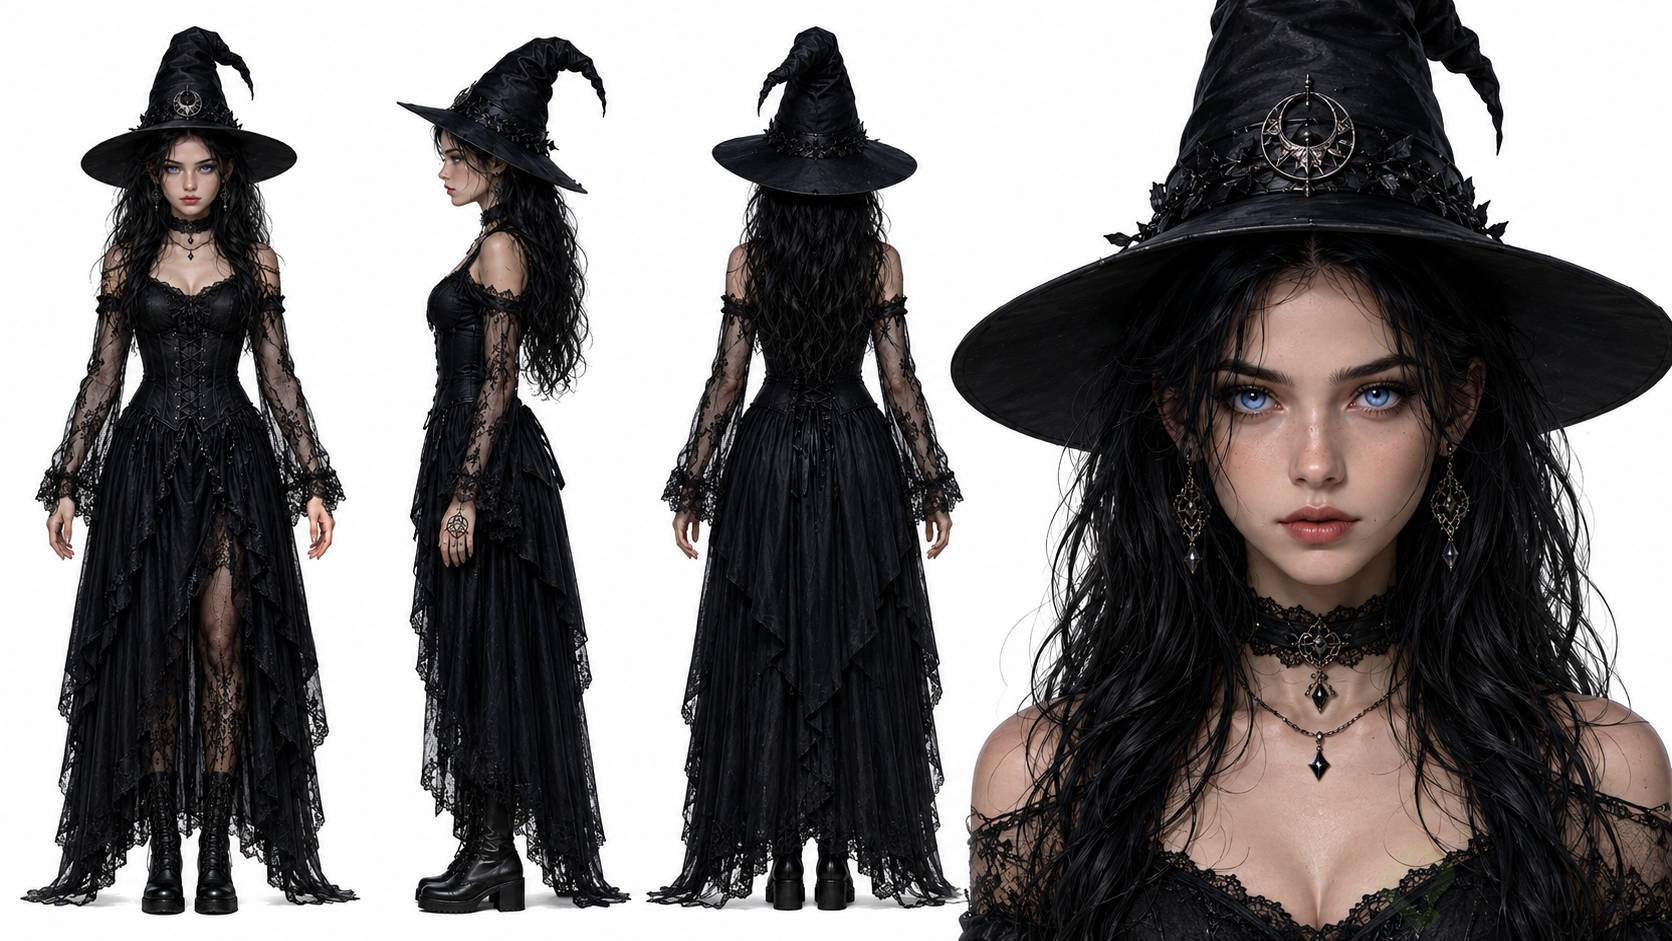
aprendiendo 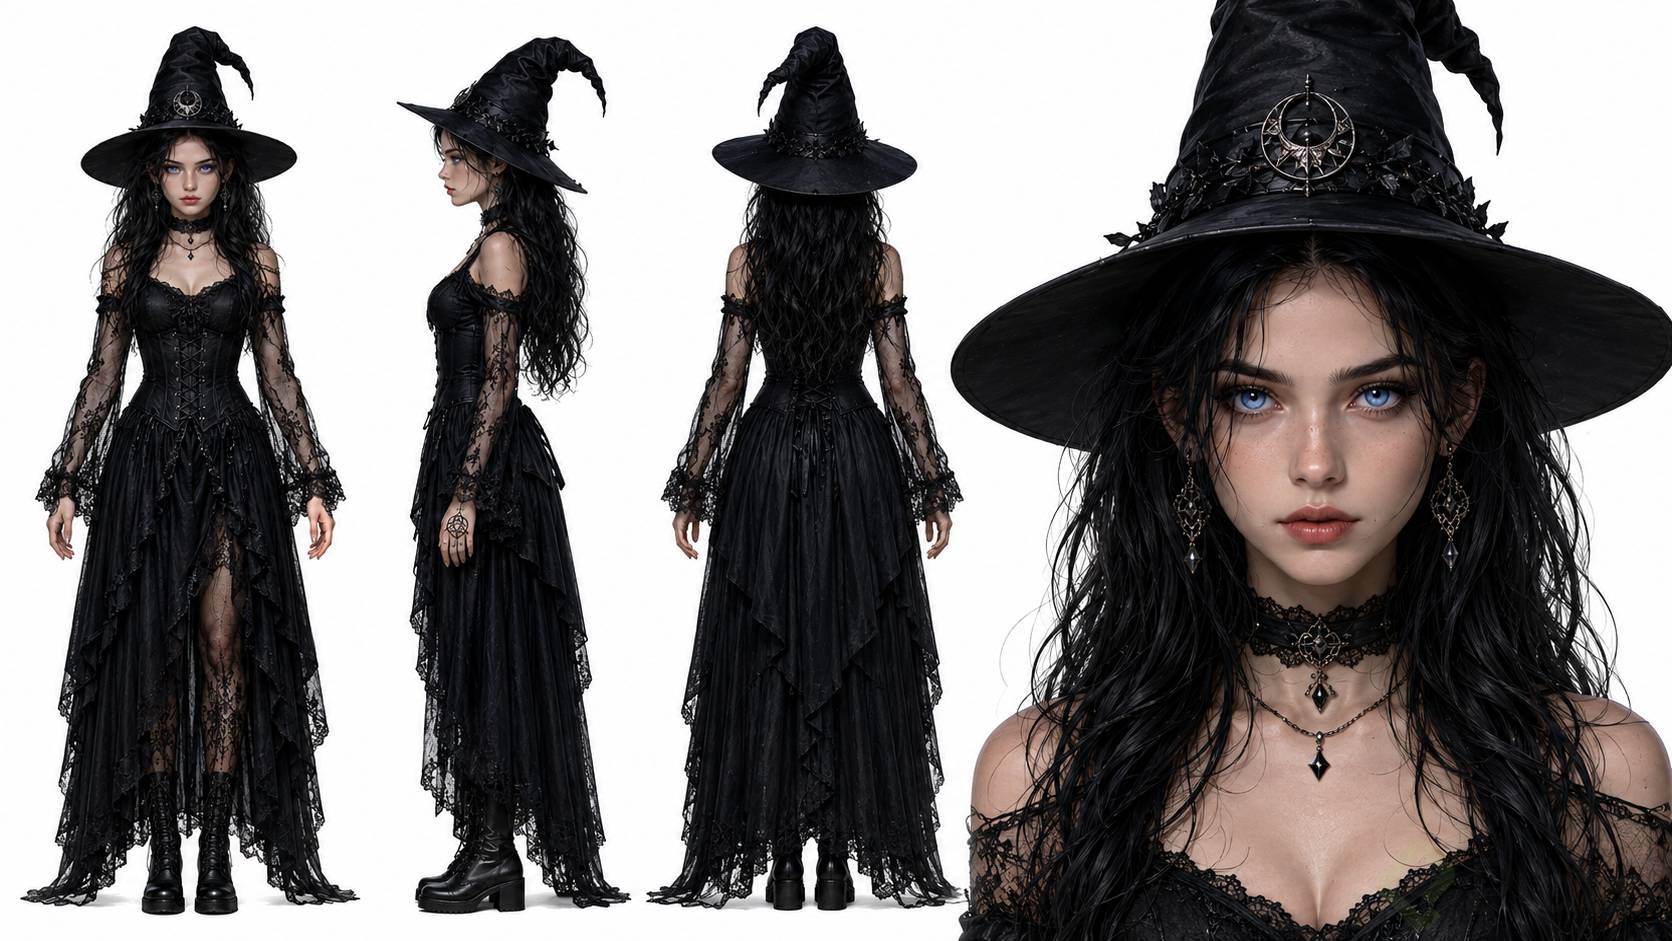
Buenas tardes, envío el resumen de la clase:
hecho con GROK imagine
sin etiquetas:
con etiquetas:
prompt:
[Character] Beautiful young woman with a slim, athletic, toned body and warm brown skin, long flowing dark hair escaping from under her climbing helmet, intense focused expression, visible sweat on her face and arms despite the cold, heavy agitated breathing
[Environment] Extreme rock climbing on a nearly horizontal overhanging cliff face high in the mountains, dramatic snow-capped peaks in the background, soft golden light of early sunrise creating a postcard-perfect but dangerous alpine landscape, strong wind blowing, fine snow dust drifting across the rock face and lightly over her skin
[Action / Storyline] She loses her footing in a near-fall, slips slightly on the rock, desperately secures herself by gripping hard with both hands, then powerfully pulls herself upward with explosive strength to catch a higher rocky hold, wind whipping around her, snow particles swirling past her face
[Camera] Camera starts with a rapid dramatic pull-back revealing the sheer drop and height, then transitions into smooth slow-motion as she recovers and reaches for the hold, cinematic tracking that emphasizes the danger and her athletic effort
[Aesthetic] Cinematic film look, desaturated muted color palette with high contrast, photorealistic, shot on 35mm film, natural volumetric lighting from the sunrise, subtle film grain, ultra-realistic skin texture and fabric details of climbing gear
Modelo utilizado: Higgsfield Lite:
Sin etiquetas:
Con etiquetas: