Multicolinealidad: por qué rompe tu modelo
Contenido del curso
Operaciones con Vectores y Matrices
Multiplicación de Matrices
Construcción de un Modelo de Regresión Lineal
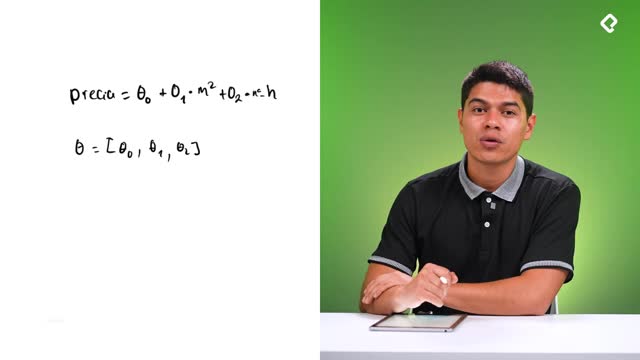
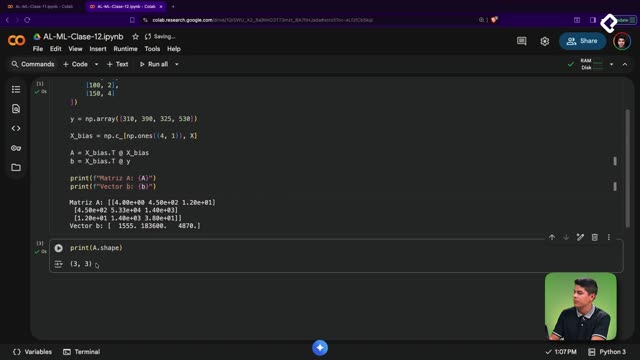
Multicolinealidad: por qué rompe tu modelo
Multicolinealidad: por qué rompe tu modelo
Contenido del curso
¿Qué pasa si hay características casi idénticas?
Si las variables no son copias exactas pero están altamente correlacionadas (como el precio de una casa y los impuestos que paga), el determinante no será exactamente cero, pero será un número extremadamente pequeño. Esto genera un problema silencioso pero letal: la inestabilidad extrema. Piensa en ello como intentar equilibrar una pirámide sobre su punta. Cualquier ruido microscópico en los datos de entrada o un ligero cambio en una sola fila hará que los pesos (theta) del modelo salten de manera errática y desproporcionada. Un día una variable parecerá la más importante del mundo y, al reentrenar con un dato nuevo, su peso podría volverse negativo. Esto destruye por completo la interpretabilidad de tu modelo, impidiéndote explicar por qué la inteligencia artificial toma ciertas decisiones.
¿Puedo usar esto para limpiar mis datos?
Absolutamente. Entender la dependencia lineal es tu mejor filtro para realizar selección de características (feature selection). En lugar de lanzar cientos de variables a ciegas a tu modelo esperando que haga magia, puedes usar el cálculo del rango y el determinante como un escáner de calidad. Si detectas que tu matriz es singular, sabes que debes realizar una limpieza profunda. Esto te permite tomar decisiones estratégicas: puedes eliminar manualmente la variable redundante (por ejemplo, si tienes año de nacimiento y edad, borras una), o puedes aplicar técnicas de reducción de dimensionalidad como PCA (Análisis de Componentes Principales). PCA comprime esa información correlacionada en nuevas variables independientes, salvando el entrenamiento, reduciendo el costo computacional y asegurando que cada columna aporte valor único.
El rango se mantiene como 4 ya que una de las filas no contiene información redundante.
X_enfermo_bias[1,3] = 55

¿Por qué la información redundante rompe modelos?
Imagina que intentas seguir las instrucciones de dos GPS al mismo tiempo, pero uno te da la distancia en kilómetros y el otro en millas. En lugar de ayudarte a llegar más rápido, la información duplicada te confunde porque no sabes a cuál darle prioridad. En machine learning, esto se traduce en ambigüedad matemática. Cuando le das al modelo dos variables que dicen exactamente lo mismo, el algoritmo entra en un bucle infinito de posibilidades tratando de asignarles un peso o importancia. Como ambas son igual de válidas, la ecuación normal colapsa porque no existe una única solución correcta, sino infinitas combinaciones posibles. Esto destruye la estabilidad de la matriz, haciendo que su determinante caiga a cero y sea imposible de invertir. En la práctica, tu modelo se vuelve incapaz de aprender patrones reales y es inútil para hacer predicciones confiables.
La multicolinealidad ocurre cuando dos o más variables de un modelo contienen la misma información (por ejemplo, duplicar una variable o usarla en otra escala). Esto provoca que la matriz XTXX^TXXTX se vuelva singular, es decir, con determinante igual a cero, lo que impide calcular su inversa y, por tanto, rompe el entrenamiento mediante la ecuación normal.
Las consecuencias son críticas: no existe una solución única para los pesos, el modelo se vuelve inestable (pequeños cambios generan grandes variaciones) y la interpretación de los coeficientes pierde sentido. Con herramientas como NumPy, esto se puede diagnosticar usando np.linalg.det (determinante) y np.linalg.matrix_rank (rango), que permiten identificar redundancias antes de que fallen métodos como np.linalg.inv o np.linalg.solve.
Cuando ocurre este problema, una alternativa práctica es usar la seudoinversa, que permite obtener una solución aproximada incluso en presencia de multicolinealidad. En síntesis, detectar y corregir la redundancia en las variables es clave para garantizar modelos estables y confiables en machine learning.
Reto: Cambiar un valor de la matriz X, para evitar la redundancia y verificar su determinante y el rango


Donde estas haciendo la conversión pies2 = X[:, 0] * 10.764 , entonces modifico la columna sumando un numero, para que no sea lineal pies2[0] +=5, asi la matriz vuelve a ser revertible y el determinanate ya deja de ser cero.
🧩📘 Multicolinealidad y singularidad en modelos lineales
🎯 IDEA CENTRAL
🧠 Multicolinealidad = características redundantes en X
⬇️
🔗 Dependencia lineal
⬇️
🚫 Matriz singular (no invertible)
⬇️
❌ La ecuación normal no tiene solución única
⚠️ ¿QUÉ ES LA SINGULARIDAD?
Una matriz es singular cuando:
✔️ Determinante = 0
❌ No tiene inversa
❌ No existe una solución única
📌 La multicolinealidad es una causa directa de singularidad.
🔁 ¿CÓMO APARECE LA DEPENDENCIA LINEAL?
Ocurre cuando una columna no aporta información nueva.
Ejemplos típicos
🔹 Misma variable, distinta escala → m² ↔ pies² (factor 10.764)
🔹 Variable duplicada → “habitaciones” + copia de “habitaciones”
➡️ Misma información, diferente forma.
🧮 ¿CÓMO SE VE EN LAS MATRICES?
📐 Matemáticamente ocurre que:
· X transpuesta por X se vuelve singular
· Determinante = 0
· Rango < número de columnas
· La ecuación normal no se puede resolver
🚨 PROBLEMAS EN EL MODELO
❓ Ambigüedad
· Infinitos vectores de pesos explican igual los datos
⚡ Inestabilidad numérica
· Determinante cercano a 0
· Pequeños cambios → grandes variaciones en los pesos
🔍 Mala interpretabilidad
· Los pesos dejan de ser fiables
Creé un nuevo campo que es el producto del área de las casas y las habitaciones:

Para mi sorpresa, este nuevo campo no es una combinación lineal de los otros. El determinante de la matríz A es distinto de 0 y su rango equivale al número de incógnitas: 4.

Resultó un nuevo vector theta totalmente distinto al calculado previamente y las predicciones de precios variaron un poco:

Graficando los precios reales, las predicciones con theta (sin el campo adicional) y las predicciones con theta_1 (con el campo adicional obtenemos 3 lineas distintas:

# Modifiquemos ligeramente un valor de pies2 y repitamos el proceso
pies2 = np.array([ 861, 1291.68, 1076.4, 1614.6 ])
X_enfermo = np.c_[X, pies2]
X_enfermo_bias = np.c_[np.ones((4, 1)), X_enfermo]
A_enfermo = X_enfermo_bias.T @ X_enfermo_bias
B_enfermo = X_enfermo_bias.T @ y
determinante = np.linalg.det(A_enfermo)
print(determinante)
Y el resultado me da 1.44...