Regresión lineal resuelta con álgebra lineal
Contenido del curso
Operaciones con Vectores y Matrices
Multiplicación de Matrices
Construcción de un Modelo de Regresión Lineal
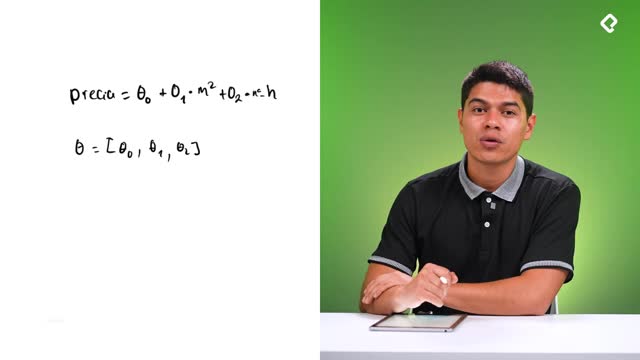
Regresión lineal resuelta con álgebra lineal
Regresión lineal resuelta con álgebra lineal
Contenido del curso

Alex Francisco Bustos Pinzon
Daniel Erazo
Profesor
Bryan Castano
Diego Vega Andrade
Alberto Ezequiel Marin Chacon
Daniel Erazo
Profesor
Alejandro Senger
Daniel Erazo
Profesor
Gabriel Obregón

Johan L
Alejandro Vega Villegas
José Eder Guzmán Mendoza
Juan Diego Ussa Aponte

Pablito Ayluardo
Juan Felipe Murillo Artunduaga

William Alexander Bejarano Pinilla
Alex Xiomar Rubio Lopez

Alex Moreno
Juan Felipe Benavides

Ruben Eduardo Acosta Vela
Diego Ortiz
Daniel Erazo
ProfesorBryan Castano
Camilo Alejandro Quiroz Castellanos

Brayan Tarazona
me parece ver un error de concepto en el minuto 1:11 donde intentas ver si la matriz es invertible y para ello sacas la norma para verificar si es mayor a cero, pero la metrica es el determinate diferente de cero
Hola, gracias por la corrección, tienes razón, para que una matriz sea invertible su determinante tiene que ser distinto de cero.
Hola Chicos, X3 Cosas "Observaciones"
np.linalg.solve(A, b) no calcula la inversa de A. En su lugar, llama a una de las rutinas LAPACK de gesv, que primero factoriza A usando la descomposición LU y luego resuelve x usando sustitución hacia adelante y hacia atrás .
np.linalg.inv utiliza el mismo método para calcular la inversa de A, resolviendo A-1 en A·A-1 = I, donde I es la identidad*. El paso de factorización es exactamente el mismo que el anterior, pero se requieren más operaciones de punto flotante para resolver A-1 (una matriz n×n) que para x (un vector de longitud n). Además, si se desea obtener x mediante la identidad A-1·b = x, la multiplicación de matrices adicional implicaría aún más operaciones de punto flotante y, por lo tanto, un rendimiento más lento y un mayor error numérico.
EL Algoritmo: NumPy utiliza la biblioteca LAPACK (específicamente la rutina _gesv), la cual emplea una descomposición LU con pivoteo parcial para invertir la matriz.
Este proceso implica aproximadamente \(n^{3}\) operaciones de punto flotante.Rango teórico:
Aunque existen algoritmos teóricos más rápidos (como el de Strassen que es \(O(n^{2.81})\) o el de Coppersmith-Winograd que es \(O(n^{2.37})\)), estos rara vez se usan en bibliotecas estándar como NumPy debido a su complejidad de implementación y a que solo muestran ventajas reales con matrices extremadamente grandes.
Costo computacional: Si duplicas el tamaño de la matriz (por ejemplo, de \(1000\times 1000\) a \(2000\times 2000\)), el tiempo de ejecución aumentará aproximadamente 8 veces (\(2^{3}\)).
Si tu objetivo es resolver un sistema de ecuaciones del tipo
Ax=bcap A x equals b
𝐴𝑥=𝑏
, es más eficiente y numéricamente estable usar np.linalg.solve(A, b) en lugar de calcular la inversa explícitamente con np.linalg.inv(A) y luego multiplicar.
Aqui esta el codigo primordial en FORTRAN 77, :
En lugar de métodos ingenuos como eliminación gaussiana simple, utiliza:
stabilidad Numerica : El pivoteo previene problemas comunes en aritmética de punto flotante. Sin pivoteo, incluso sistemas bien condicionados pueden producir soluciones completamente erróneas debido a errores de redondeo acumulados.
LAPACK (Linear Algebra PACKage) está:
La complejidad es O(n³) para la factorización, pero:
Por tanto si que es mejor usar np.linalg.solv(A,b) que hacerlo pro la inversa.
Para tu segundo punto, recuerda que el intercepto solo te dice el valor de la ordenada al origen, por lo tanto es un valor que se debe ajustar a la recta de prediccion, el cual no afecta siempre y cuando con las caracteristicas reales de la casa siga siendo positivo el valor de la variable objetivo. Igualmente esa recta de ajuste se basa en los valores dados, si agregaras mayor numero de observaciones, esa recta seria aun mejor y posiblemente el intercepto no seria cero. Asi que un intercepto negativo no influye en la relacion proporcion que mencionas.
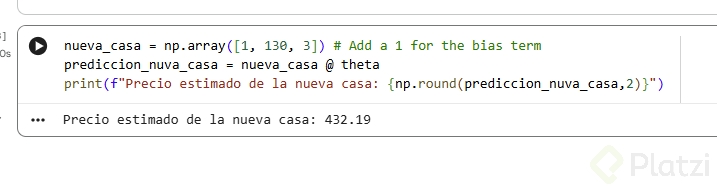
Sería de 432.19
casa = np.array([1, 130, 3]) precio = casa @ theta_solve print(np.round(precio_130_3, 2))
Muy bien, es correcto!
casa = np.array([1, 130, 3])
print(f"Precio de la casa: {np.round(casa @ theta, 2)}")
Precio de la casa: 432.19
Muy bien, es correcto!
🧠📘 📈 Regresión lineal con álgebra lineal y NumPy
🎯 OBJETIVO
👉 Aprender a calcular los pesos (theta) de un modelo de regresión lineal usando:
✔ Álgebra lineal
✔ Ecuación normal
✔ NumPy
Y entender:
🔹 Por qué np.linalg.solve es mejor que la inversa
🔹 Qué representan intercepto, bias y pesos
🔹 Cómo generar predicciones
🔹 Cómo visualizar la línea de mejor ajuste
🧠 IDEA CENTRAL
📌 Sistema lineal:
A · X = B
Si A es invertible, entonces:
➡ X = A inversa · B
📍 En regresión lineal:
· X → theta (pesos del modelo)
⚠️ Esta solución es válida en teoría, pero no es la mejor en la práctica.
🚫 ¿POR QUÉ EVITAR LA INVERSA?
Usar la inversa de una matriz:
❌ Es costoso computacionalmente
❌ Puede ser numéricamente inestable
❌ No escala bien en matrices grandes
✅ Alternativa profesional: 👉 np.linalg.solve(A, B)
✔ Más rápido
✔ Más estable
✔ Resuelve el sistema directamente
✅ CONDICIONES PARA QUE A SEA INVERTIBLE
Antes de resolver:
🔹 La norma de A debe ser mayor que cero
🔹 A debe ser una matriz cuadrada (ej. 3×3)
📌 Comprobaciones típicas:
· np.linalg.norm(A) > 0
· A.shape
🧮 CÁLCULO DE LOS PESOS (theta)
🟡 Opción teórica: inversa
➕ Calcula A inversa
➕ Multiplica por B
➖ Funciona, pero no es recomendable
🟢 Opción recomendada: solve
✔ Usa np.linalg.solve(A, B)
✔ Más eficiente
✔ Más robusta
✔ Produce el mismo resultado
⭐ Opción preferida en la práctica
🧩 INTERCEPTO, BIAS Y PESOS
🔹 Intercepto
📍 Primer valor de theta
📍 Precio base del modelo
📍 Predicción para:
· 0 metros cuadrados
· 0 habitaciones
🔹 Bias
📍 Columna de unos al inicio de X
📍 Permite aprender el intercepto
🔹 Pesos
📍 Coeficientes del modelo
📍 Multiplican cada característica
📍 Ajustan el precio según:
· Metros cuadrados
· Número de habitaciones
📐 CUANDO NO HAY SOLUCIÓN EXACTA
⚠️ El sistema puede ser inconsistente
👉 Entonces:
🔹 Se proyecta Y de forma ortogonal
🔹 Sobre el espacio columna de X
🔹 Se obtienen las predicciones
📌 Esto es lo que hace la ecuación normal
🔮 PREDICCIONES DEL MODELO
Con theta calculado:
➡ Usar X con bias
➡ Aplicar producto punto con theta
➡ Comparar valores reales vs predichos
🎯 Resultado:
· Predicciones del modelo de regresión
📈 VISUALIZACIÓN DEL AJUSTE
Para validar el modelo:
1️⃣ Graficar los datos reales
2️⃣ Crear puntos nuevos
3️⃣ Dibujar la línea de regresión
👀 La gráfica permite:
· Evaluar el ajuste
· Detectar errores visuales
casa_ejemplo = np.array([[130, 3]]) print(casa_ejemplo.shape) casa_ejemplo_bias = np.c_[np.ones((casa_ejemplo.shape[0], 1)), casa_ejemplo] print(casa_ejemplo_bias) print(theta) y_pred = casa_ejemplo_bias @ theta print(y_pred)
Resultado:
(1, 2) [[ 1. 130. 3.]] [-11.84210526 2.48245614 40.43859649] [432.19298246]
# Precio de una vivienda de 130 m^2 y 3 habitaciones vivienda_1 = np.array([1, 130, 3]) precio = np.dot(vivienda_1, theta) print("El precio de una vivienda de 130 m^2 y 3 habitaciones es: \n", precio) # El precio de una vivienda de 130 m^2 y 3 habitaciones es: # 432.1929824561405
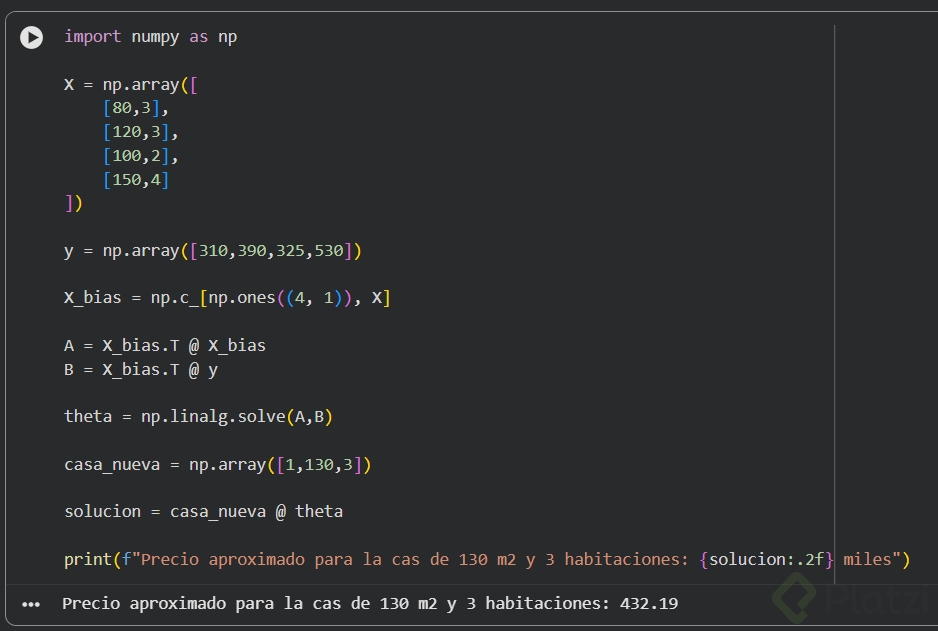
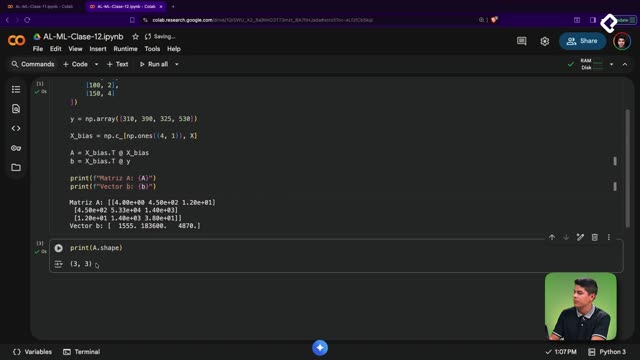
Para calcular los pesos (θ) en regresión lineal, se utiliza la ecuación normal Aθ=BA\theta = BAθ=B, donde A=XTXA = X^TXA=XTX y B=XTyB = X^TyB=XTy. Aunque teóricamente puede resolverse usando la inversa de A, en la práctica se recomienda usar np.linalg.solve, ya que es más eficiente y numéricamente estable, especialmente en matrices grandes.
El vector θ incluye el intercepto (bias) y los pesos de cada característica, lo que permite generar predicciones mediante el producto Xbias@θX_{bias} @ \thetaXbias@θ. Con estos valores, es posible comparar resultados reales vs. predichos y visualizar la línea de mejor ajuste. Este proceso demuestra cómo el álgebra lineal permite entrenar modelos y realizar predicciones de forma directa, eficiente y escalable en machine learning.
Esta clase ayuda a entender el funcionameinto una libreria muy utilizada: sklearn.linear_model
A continuacion les dejo el link de la clase en donde se enseña esto mismo pero utilizando la libreria de Sklearn del Curso de Regresion Lineal con Python:
https://platzi.com/cursos/regresion-lineal/entrenando-un-modelo-de-regresion-lineal-con-sciki/
Cuando terminas de hacer el ejerccio seria muy educativo que muestres locuadros eso ayuda a una mejor comprencion


Reto: predicción para una casa de 130 m2 y 3 habitaciones

casa = np.array([130,3]) casa_bias = np.c_[np.ones((1,1)),casa.reshape(1,-1)] precio_predicho = casa_bias @ theta print(f"Precio predicho para una casa de 130 m2 y 3 habitaciones: ${precio_predicho.round(2)}")
Precio predicho para una casa de 130 m2 y 3 habitaciones: $432.19
# Definimos el vector de entrada, el cual es una casa de 130 metros cuadrados y 3 habitaciones: casa = np.array([130,3]) casa_bias = np.insert(casa, 0, 1) # predecir el valor de la casa definida en el vector de entrada "casa" print(f"el precio estimado de una casa con {casa[0]} metros cuadrados y {casa[1]} habitaciones es de {np.round(casa_bias @ theta, 2)} miles de USD aproximadamente")
Me quedo la duda de para que usamos lo del bias. Probé que pasaba si no lo usamos y el resultado es el mismo.
# Veamos que pasa sin el bias
x = np.array([
[80, 3],
[120, 3],
[100, 2],
[150, 4]
])
y = np.array([310, 390, 325, 530])
AA = x.T @ x
bb = x.T @ y
theta2 = np.linalg.solve(AA, bb)
plt.figure(figsize=(6, 4))
plt.scatter(x[:,0], y, color='b', label='Datos reales')
x_linea2 = np.array([[50], [160]])
x_linea_ext = np.c_[x_linea2, np.array([[2], [4]])]
y_linea2 = x_linea_ext @ theta2
plt.plot(x_linea2, y_linea2, color='r', label='Regresion')
plt.xlabel('Metros cuadrados')
plt.ylabel('Precios')
plt.title('Sin bias')
plt.legend()
plt.grid()
plt.show()

Aquí parece que intentan usar notación de Markdown o similar y el sistema de respuestas no lo soporta, se vuelve muy difícil de leer

Muchas gracias por tu comentario, le diré al equipo correspondiente para que pueda revisarlo.
@mi me parece que eso se entiende bien.