Pseudo inversa de NumPy para matrices singulares
Contenido del curso
Operaciones con Vectores y Matrices
Multiplicación de Matrices
Construcción de un Modelo de Regresión Lineal
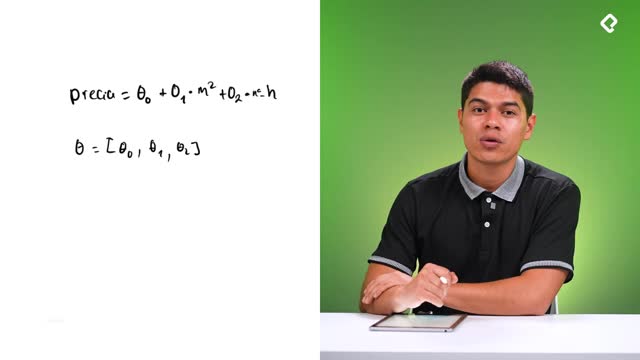
Pseudo inversa de NumPy para matrices singulares
Pseudo inversa de NumPy para matrices singulares
Contenido del curso

Johan L
lizardo durand
Daniel Erazo
Profesor
Marlon Marin
Daniel Erazo
Profesor
Bryan Castano
Daniel Erazo
Profesor
Gabriel Obregón
NESTOR IVAN RONCANCIO CABALLERO

Gabriel Londoño
Luis Alejandro Arellano Camacho
John Felipe Vélez
Daniel Erazo
Profesor
Edgardo Riveros Sepulveda
Daniel Erazo
Profesor
Alejandro José Hugo Escalante Santos
Daniel Erazo
Profesor
José Eder Guzmán Mendoza
Camilo Alejandro Quiroz Castellanos

Wilson Alexander Pinzon Rueda
La pseudoinversa toma la norma mas pequeña debido a que es el punto mas cercano al origen (0,0). Debido a que es la solución mas optima y evita traer una posible solución con componentes demasiado grandes.
Buen curso. entendiendo un poco mas cada dia.
Me alegro qué te haya gustado!
Este curso es muy muy bueno, está muy bien planeado porque va al grano, hace referencias prácticas en el día a día del Data Science, explica las matemáticas que hay detrás, las limitaciones para las predicciones, y deja como apertura el curso de SVD y PCA.
Muchas gracias por tu comentario, me alegra mucho que te haya gustado el curso!
Genial! \n Yo R-Aprendido muchas cosas neuvas en este curso y comprendido la naturaleza matematica de otras que Ya sabia pero no comprendia su razon, ahora todo ha sido descubierto , y es sorpendente cuando entiendes la realidad de los vectores y matrices, como funciona realmente una transformacion lienal en el hyperespacio. aplciado a lso dataset me hace llegar a un nuevo "level" en ML.
print("Nunca Pares de Aprender")
Me alegro que te haya servido el curso!
📈 Regresión lineal con multicolinealidad y seudoinversa
🎯 PROBLEMA PRINCIPAL
⚠️ La multicolinealidad rompe el entrenamiento del modelo
🔹 Ocurre cuando hay columnas dependientes
🔹 La matriz se vuelve singular
🔹 Métodos como inv o solve ❌ fallan
🔹 El entrenamiento no puede continuar
➡️ No es un fallo del modelo, es un problema matemático.
💡 IDEA CLAVE
🛠️ Cambiar la herramienta, no el modelo
➡️ Usar la seudoinversa de Moore-Penrose
✔️ Funciona con matrices singulares
✔️ Permite entrenar por mínimos cuadrados
✔️ Si hay infinitas soluciones → elige la más estable
🔍 ¿QUÉ ES LA MULTICOLINEALIDAD?
🔁 Dependencia lineal entre columnas
📌 Ejemplo clásico:
· metros cuadrados
· pies cuadrados
📉 Ambas columnas contienen la misma información
❗ Consecuencia:
· Redundancia
· Pérdida de invertibilidad
🧠 CONCEPTOS CLAVE (MEMORIZAR)
🧩 Multicolinealidad → columnas duplicadas o dependientes
🧩 Matriz singular → no se puede invertir
🧩 Seudoinversa (Moore-Penrose) → np.linalg.pinv
🧩 Mínimos cuadrados → minimiza el error cuadrático
🧩 Solución de mínima norma → el theta más corto posible
🧩 Proyección ortogonal → mejor ajuste sobre los datos
⚙️ ¿POR QUÉ FUNCIONA LA SEUDOINVERSA?
🔧 Generaliza la inversa clásica 🔧 Funciona con matrices:
· cuadradas ⬛
· rectangulares ▭
· singulares ⚠️
🔗 Basada en SVD (valores singulares)
📌 Efecto importante:
· Columnas redundantes → pesos muy pequeños
· El modelo detecta la redundancia solo
🔄 FLUJO EN NUMPY (PASO A PASO)
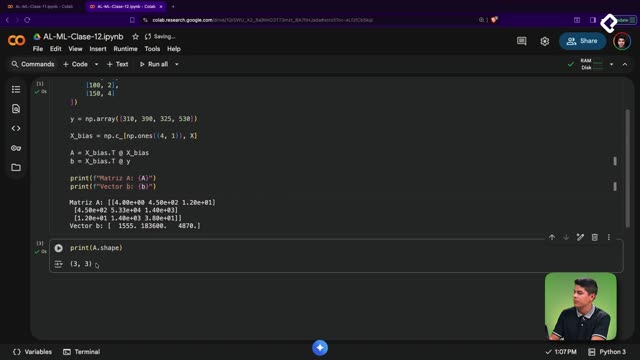
1️⃣ Construcción del sistema
🧱 Matriz “enferma” + bias
🧱 Ecuaciones normales
2️⃣ Fallo esperado
❌ inv no funciona
❌ matriz singular
3️⃣ Solución correcta
✅ pinv
✅ cálculo de theta
✅ predicciones sin error
Buen curso, entendible así no se manejen aun conceptos extremadamente técnicos, es explicito sin tergiversar lo esencial del entendimiento básico del algebra, pero puesto en código.
Me queda la duda: Hay una forma de detectar en google colab qué columnas son dependientes y eliminar una de ellas para así eliminar la redundancia?
Muchas Gracias!! Muy buen curso!! a Seguir aprendiendo!!
Excelente curso, muy bien explicado.
Me alegro que te haya gustado!
Que buen curso me costo entender pero seguirlo fue sencillo gracias por la dedicación la IA también ayudo un monton
Me alegro que te haya gustado!
Excelente curso.
Muchas gracias, me alegro que te haya gustado!
Cuando existe multicolinealidad, la matriz XTXX^TXXTX se vuelve singular, lo que impide usar métodos como la inversa o np.linalg.solve para entrenar el modelo. En estos casos, la seudoinversa de Moore-Penrose (np.linalg.pinv) permite obtener una solución válida, ya que generaliza la inversa y funciona incluso con matrices no invertibles.
La seudoinversa calcula los pesos (θ) que minimizan el error cuadrático (mínimos cuadrados) y, cuando existen infinitas soluciones, selecciona la de menor norma, es decir, la más simple y estable. Esto permite generar predicciones cercanas a los valores reales incluso en presencia de redundancia en los datos.
En la práctica, esta técnica es fundamental para mantener el entrenamiento funcional cuando hay problemas de multicolinealidad, ya que garantiza una solución robusta y coherente. Además, su interpretación se relaciona con proyecciones ortogonales y métodos como la descomposición en valores singulares (SVD), que sustentan muchos algoritmos modernos de machine learning.
Profe seria posible usar el metodo np.linalg.lstsq?
least = np.linalg.lstsq(X_enfermo_bias,b)
print(least)
parece que por aproximaciones en la SVD usa los pseucovalores característicos