Un LLM (large language model o modelo de lenguaje grande) es un modelo de inteligencia artificial entrenado con enormes cantidades de texto para predecir y generar lenguaje. Es el motor detrás de ChatGPT, Claude y Gemini.
Si te digo "el gato maúlla y el perro...", tu cabeza completa la frase con "ladra" antes de que yo termine. Un LLM hace algo muy parecido: predecir palabra por palabra, cada vez que le escribes.
Entender cómo funciona un LLM te ayuda a sacarle más provecho y a saber cuándo no creerle. Vamos a usar el mismo acertijo del gato con el que explicamos los LLM en el Curso de LLMs de Platzi.
¿Qué significa LLM y qué es un modelo de lenguaje grande?
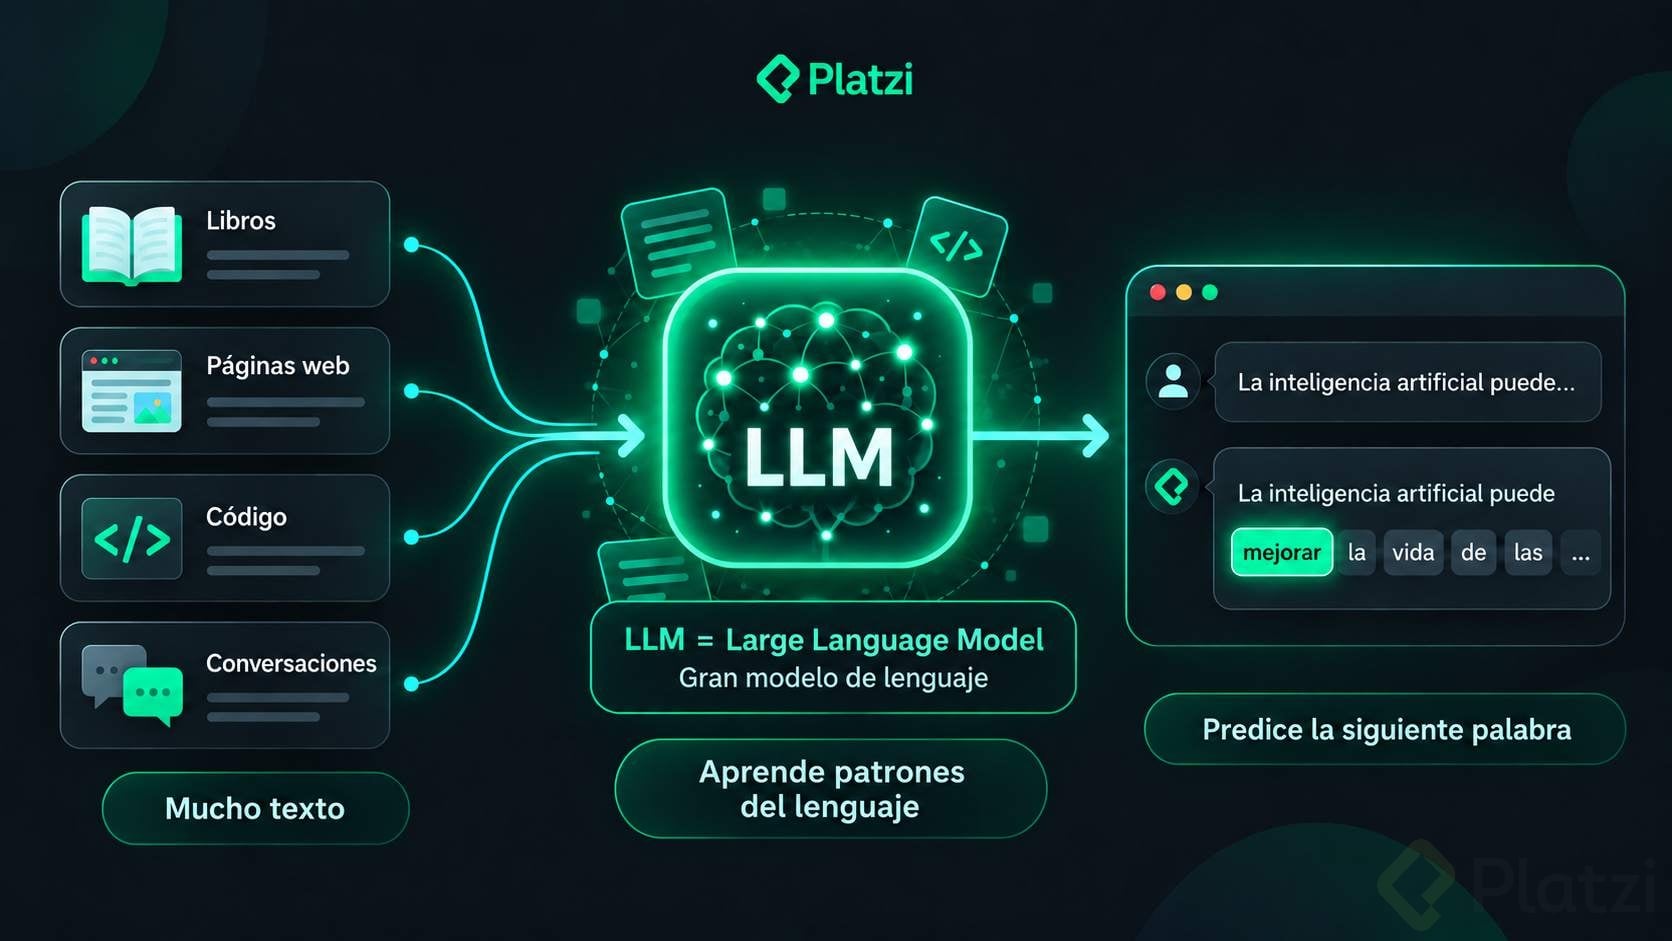
LLM viene del inglés large language model. En español se dice "modelo de lenguaje grande" o "gran modelo de lenguaje", y las dos formas significan lo mismo. Cada palabra de la sigla explica una parte:
- Large (grande): aprende de una cantidad gigantesca de texto y guarda lo aprendido en miles de millones de números internos.
- Language (lenguaje): su materia prima es lo que las personas hemos escrito: libros, Wikipedia, foros, redes y código.
- Model (modelo): es una representación matemática de ese lenguaje, capaz de calcular qué palabra tiene más probabilidad de venir después.
Ahora sí, abramos el motor.
¿Cómo funciona un LLM?
Volvamos al gato. "Ladra" es la respuesta más lógica cuando hablamos de "perro", aunque "se asusta" o "no maúlla" también serían válidas. Llegaste a "ladra" porque pusiste atención en ciertas palabras e ignoraste otras.
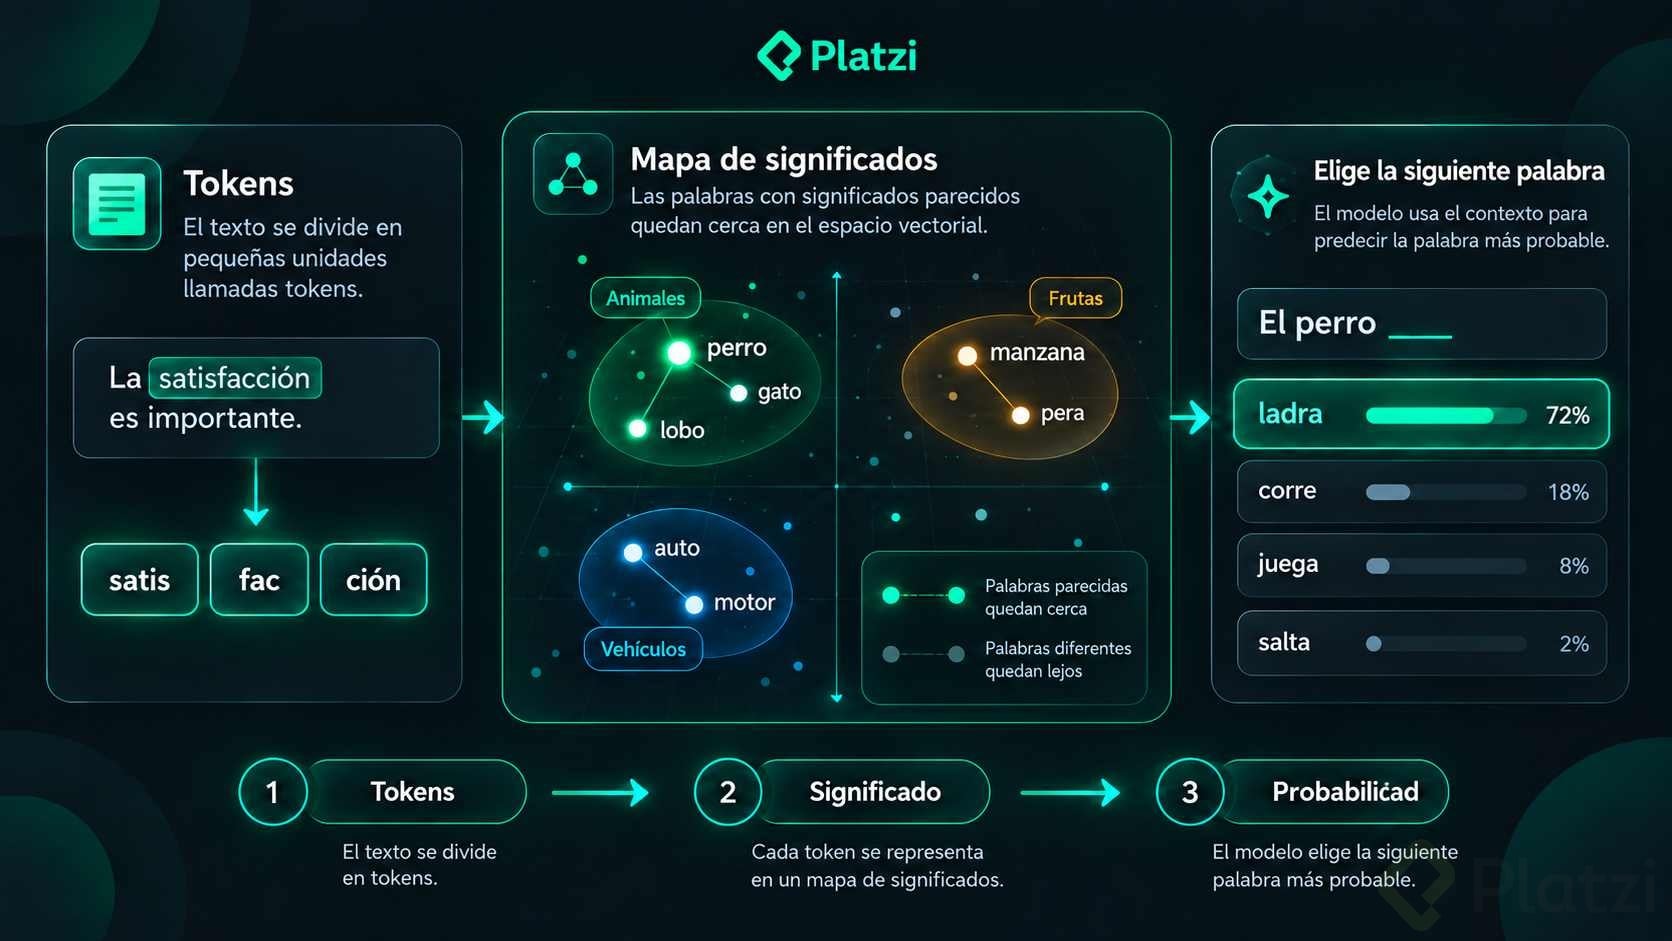
Un LLM imita ese proceso en tres pasos: parte el texto en pedacitos (tokens), ubica cada pedacito en un mapa de significados y se fija en los que más importan para elegir la siguiente palabra.
¿Qué son los tokens en un LLM?
El primer paso es tomar todo el texto disponible y romperlo en piezas llamadas tokens. Un token es un fragmento que aparece con frecuencia: puede ser una palabra completa, un pedazo de palabra o una sola letra.
La palabra "satisfacción", por ejemplo, se puede partir en "satis", "fac" y "ción". Cada pieza es un token.
¿Cuántos tokens conoce un LLM? Los grandes modelos de lenguaje manejan vocabularios de hasta 256.000 tokens. Para cubrir solo el inglés bastan unos 50.000 (los traductores automáticos trabajan con entre 40.000 y 50.000), y la cifra crece cuando se suman otros idiomas y código.
Parece poco para todo un idioma. Las combinaciones de letras son casi infinitas, pero el lenguaje que de verdad usamos se repite muchísimo.
¿Cómo organiza un LLM las palabras por su significado?
El segundo paso es ubicar cada token en un mapa. Imagina un plano con tres ejes: "animal", "automóvil" y "amor". En cada eje, el cero significa "muy relacionado" y los números altos, "nada que ver".
- En el eje animal, "gato" queda pegado al cero, porque es un animal.
- En el eje automóvil, queda lo más lejos posible.
- En el eje amor, queda en un punto medio: queremos a los gatos, pero no más que a un bebé.
Ahora imagina miles de ejes en lugar de tres. Nosotros solo podemos visualizar tres dimensiones; una computadora guarda miles. Cada token termina convertido en una lista de números que indica qué tan cerca está de todos los demás. Esa lista es su vector o embedding.
Así, las palabras parecidas quedan juntas: "gato", "perro" y "lobo" viven en el mismo barrio, y "manzana" y "pera", en otro. Las relaciones entre palabras también se vuelven direcciones dentro del mapa:
- "Rey" es a "reina" lo que "hombre" es a "mujer".
- "Caminé" es a "caminar" lo que "nadé" es a "nadar".
- Si tomas la dirección que va de Italia a Roma y la aplicas desde Colombia, llegas muy cerca de Bogotá.
Antes de escribir una sola palabra, el modelo ya tiene el idioma organizado como un mapa de ciudades unidas por carreteras, y con ese mapa puede sumar y restar significados.
¿Qué es la atención en un LLM?
Aquí volvemos al acertijo. Cuando escribes un prompt, que es la instrucción que le das a ChatGPT o a cualquier chatbot, el modelo toma el último token ("perro") y lo compara con el resto de tu texto para decidir cuáles pesan más. "Maúlla" y "gato" ganan por mucho. Ese mecanismo es la atención.
Calcular todas las combinaciones posibles entre todas las palabras del idioma sería inmanejable: no alcanzarían los chips ni la memoria del mundo. Por eso la atención compara solo los tokens de tu texto y le da más peso a los que importan.
Después, el modelo asigna una probabilidad a cada palabra de su vocabulario. Así se vería el reparto (los porcentajes son ilustrativos):
| Siguiente palabra | Probabilidad |
|---|---|
| ladra | 72% |
| corre | 18% |
| juega | 8% |
| salta | 2% |
Normalmente gana "ladra", pero no siempre. Los LLM tienen un ajuste llamado temperatura que concentra o aplana esas probabilidades antes de elegir.
Con temperatura baja casi siempre sale la opción más probable; con temperatura alta, a veces aparece la segunda o la tercera. Esa pizca de azar le da creatividad al modelo y explica por qué la misma pregunta te devuelve respuestas parecidas, aunque casi nunca idénticas.
Haz la prueba: pídele a ChatGPT, Claude o Gemini "completa con una sola palabra inesperada: el gato maúlla y el perro..." y repítelo tres veces en chats nuevos. Si te salen palabras distintas, acabas de ver en acción el azar que controla la temperatura.
¿Cómo se hace un LLM?
Todo lo anterior necesita un entrenamiento previo, y ese entrenamiento tiene dos etapas.
¿Cómo aprende un LLM a predecir palabras?
En la primera etapa, una red neuronal (un sistema estadístico que encuentra patrones escondidos en los datos) lee todo ese texto y aprende con qué probabilidad un token aparece después de otro. Después de "yo" es probable que siga "amo"; después de "mi mamá", quizá "me".
En ese proceso también capta patrones más grandes, como rimar, programar o escribir con tono de marketing. Lo aprendido se guarda en los parámetros, también llamados pesos: miles de millones de números que se ajustan durante el entrenamiento.
Las ideas de las redes neuronales nacieron en los años cincuenta, como cuenta la historia de la inteligencia artificial, y se perfeccionaron en los noventa, pero solo en los últimos años hubo chips y memoria suficientes para entrenarlas a esta escala. Por eso los LLM tardaron tanto en llegar.
¿Cómo aprendió ChatGPT a conversar?
En la segunda etapa, el autocompletador se convierte en asistente. Los primeros GPT (generative pre-trained transformer; el transformer es el diseño de red neuronal que usa la atención) solo continuaban textos: les dabas un inicio y lo completaban.
Para que respondieran como un chat, OpenAI puso a personas a evaluar y comparar las respuestas del modelo, premiando las buenas y corrigiendo las malas.
Esa técnica es el RLHF, que en español es aprendizaje por refuerzo con retroalimentación humana. Gracias a ella el modelo aprendió a conversar y también a saber cuándo dejar de escribir. Como cada empresa entrena con criterios propios, ChatGPT, Claude y Gemini terminan con "personalidades" distintas.
¿Te gustaría ver estas piezas funcionando por dentro? En el Curso de Fundamentos de LLMs programas la tokenización, los embeddings y la atención, y construyes un modelo tipo GPT-2 desde cero. Puedes empezar gratis.
¿Cuál es la diferencia entre un LLM, la IA y ChatGPT?
La inteligencia artificial es el campo completo, el LLM es uno de los tipos de inteligencia artificial (el especializado en lenguaje) y ChatGPT es un producto que usa un LLM. Se entiende mejor con un ejemplo de un auto:
| Concepto | Qué es | Analogía |
|---|---|---|
| Inteligencia artificial | El campo de los sistemas que imitan capacidades humanas | La industria automotriz |
| LLM | Un tipo de IA especializado en lenguaje | El motor |
| ChatGPT, Claude, Gemini | Aplicaciones que usan un LLM y le ponen una ventana de chat | El auto que manejas |
¿Qué es LLM en ChatGPT? Es el modelo que genera cada respuesta. ChatGPT es la aplicación donde escribes y el LLM es el motor que predice cada palabra. Cuando OpenAI lanza un modelo nuevo, cambia el motor y el auto sigue siendo el mismo.
Para ver dónde encajan los LLM junto con el machine learning y el deep learning, revisa la guía de qué es la inteligencia artificial y para qué sirve.
¿Cuáles son los LLM más usados en 2026?
Las principales empresas de IA tienen cada una su familia de modelos y sacan versiones nuevas cada pocas semanas. Estos son los ejemplos de LLM que más vas a escuchar, en la foto de octubre de 2026:
| Familia | Empresa | Versión reciente | Tipo | Dónde lo usas |
|---|---|---|---|---|
| GPT | OpenAI | GPT-6.1 | Cerrado | ChatGPT |
| Claude | Anthropic | Claude Opus 5.5 | Cerrado | Claude.ai, herramientas de programación |
| Gemini | Gemini 3.8 Flash | Cerrado | App de Gemini, Gmail, Android | |
| Muse y Llama | Meta | Muse Spark | Muse cerrado, Llama abierto | Meta AI; Llama se descarga gratis |
| DeepSeek | DeepSeek | DeepSeek V4.1 | Abierto | App de DeepSeek o descargando sus pesos |
| Qwen | Alibaba | Qwen 3.8 | Abierto y cerrado | Qwen Chat o sus versiones pequeñas en tu computadora |
| GLM | Zhipu AI | GLM-5.3 | Abierto | Z.ai o descargando sus pesos |
Seguramente en unas semanas habrá números nuevos. Para ubicarte, fíjate en dos columnas: la empresa y el tipo.
Si lo que quieres es elegir entre los tres más populares, revisa nuestra comparativa ChatGPT vs Claude vs Gemini: cuál es mejor en 2026, donde probamos sus versiones gratuitas en seis tareas reales.
¿Qué es un LLM abierto?
Un LLM abierto es uno cuyos pesos (los parámetros que aprendió en el entrenamiento) se publican para que cualquiera los descargue y los corra en su propia computadora o servidor. Llama, DeepSeek, Qwen y GLM tienen versiones abiertas, y hasta OpenAI publicó modelos abiertos con gpt-oss.
Un LLM cerrado solo se usa a través de la app de la empresa o de su API, que es la conexión que usan los programas para hablar con el modelo. Los modelos principales de GPT, Claude, Gemini y Muse Spark funcionan así.
¿Para qué sirve un LLM en tu día a día?
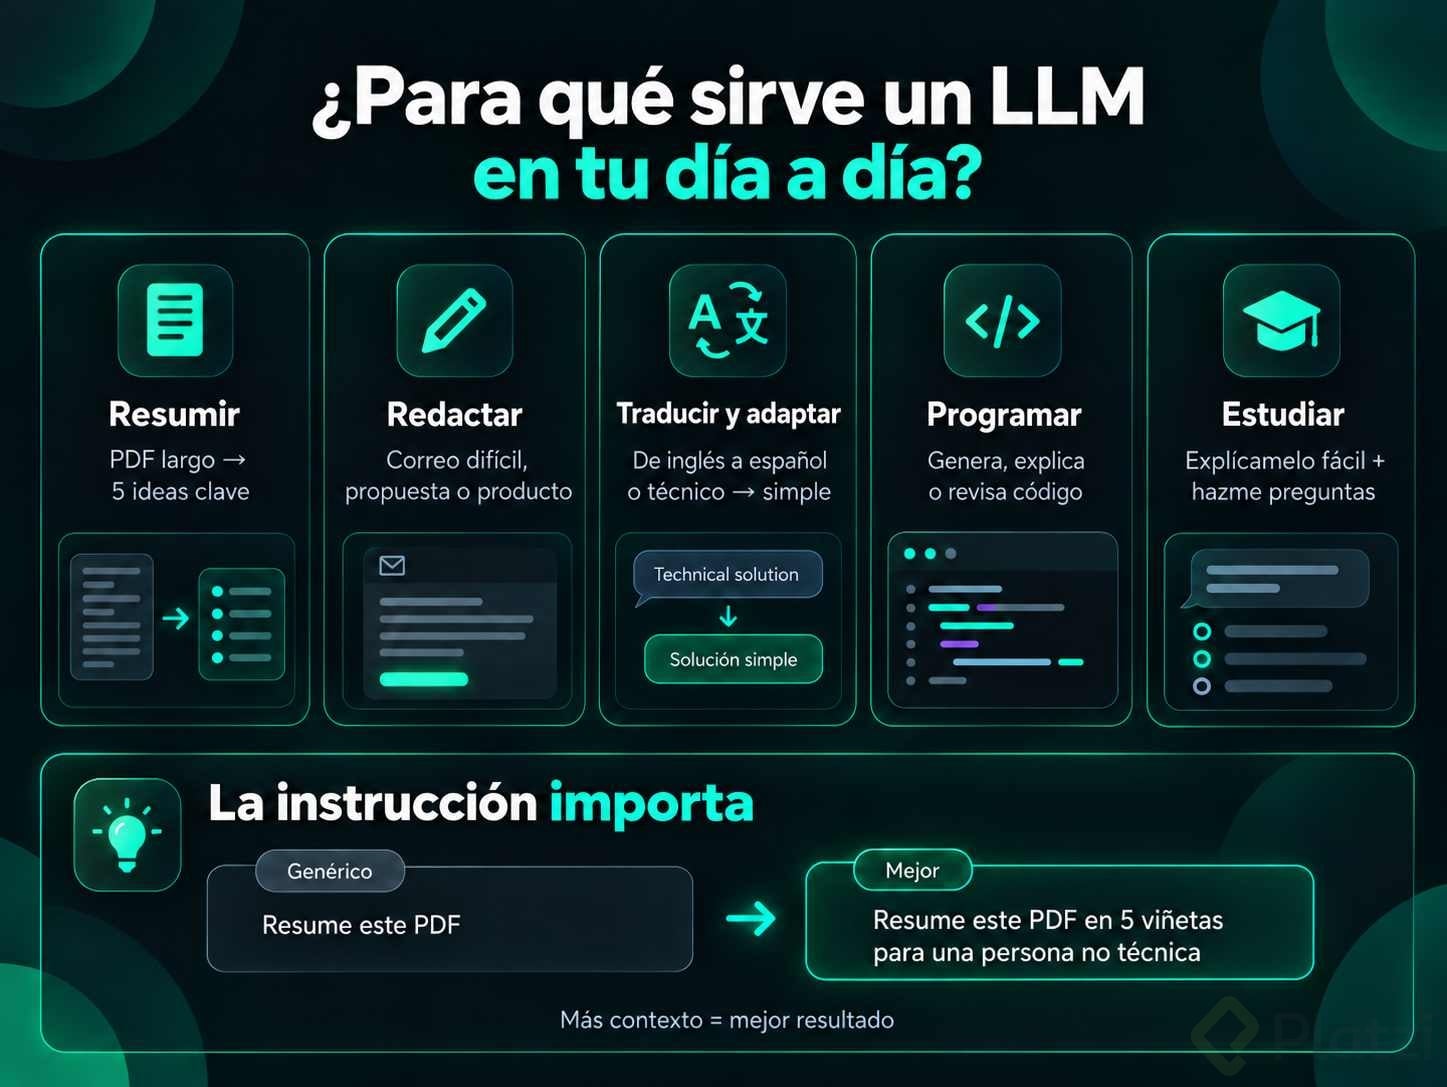
Si escribes, lees o analizas información, ya tienes dónde usarlo:
- Resumir: pegas un PDF de 30 páginas y pides los cinco puntos clave.
- Redactar: un correo difícil, una propuesta o la descripción de un producto.
- Traducir y adaptar el tono: de inglés a español, o de lenguaje técnico a uno sencillo.
- Programar: generar, explicar o revisar código.
- Estudiar: pedirle que te explique un tema como si tuvieras 12 años y luego que te haga preguntas para comprobar si entendiste.
En todos estos casos, la forma de escribir la instrucción pesa mucho. "Resume este PDF" da algo genérico; "resume este PDF en cinco viñetas para mi jefa, que no es técnica" da algo que puedes enviar.
¿Qué no puede hacer un LLM?
Conocer el mecanismo por dentro también deja ver sus límites, que explican buena parte de las ventajas y desventajas de la inteligencia artificial que usas a diario. El modelo elige la continuación más probable, y lo más probable a veces es falso.
¿Por qué un LLM inventa respuestas?
Cuando no tiene el dato, igual produce la continuación que "suena" correcta. A eso se le llama alucinación. Pídele, sin búsqueda web, la bibliografía de un tema muy específico y es fácil que aparezcan libros con títulos verosímiles que nadie escribió. Antes de citar un libro que te recomendó un chatbot, búscalo.
La alucinación no viene sola. Estos tres límites salen del mismo mecanismo de predicción:
- Fecha de corte: aprende de textos hasta cierto momento. Si no está conectado a internet, no sabe lo que pasó después, y aun así puede responder como si lo supiera.
- Sesgos: aprende de textos humanos, prejuicios incluidos.
- Falta de experiencia: nunca ha visto un perro ni ha escuchado ladrar a uno. Todo lo que "sabe" son relaciones entre tokens.
¿Un LLM piensa como una persona? No en el sentido humano. Calcula qué palabra tiene más probabilidad de seguir según los patrones que aprendió, y parece que razona porque aprendió de millones de textos escritos por personas que sí razonaban.
Continúa aprendiendo sobre LLM con Platzi
En el Curso de Fundamentos de LLMs pasas del acertijo del gato al código. Vas a:
- Escribir con PyTorch, la librería de Python más usada para crear redes neuronales, cada pieza que viste aquí.
- Ajustar un modelo con tus propios datos y comparar modelos con benchmarks, que son pruebas estandarizadas de desempeño.
- Correr modelos abiertos en tu computadora con Ollama, un programa gratuito que, una vez descargado el modelo, te deja usarlo sin conexión.
Son 20 clases de nivel intermedio, así que te conviene llegar con bases de Python. Si ya las tienes, es el camino más corto para dejar de usar los LLM como una caja negra.
Con tu cuenta gratis en Platzi puedes empezar el curso y ver por dentro el mismo mecanismo que hoy completó la frase del gato.
¿Qué palabra le pusiste tú al perro? Cuéntamelo en los comentarios.
Curso de Fundamentos de LLMs
COMPARTE ESTE ARTÍCULO Y MUESTRA LO QUE APRENDISTE