




Natalia Belenguer Sanmartin

Miguel Angel Reyes Moreno
Gracias por este apunte :)
Juan Ochoa
Muchas gracias por el aporte!
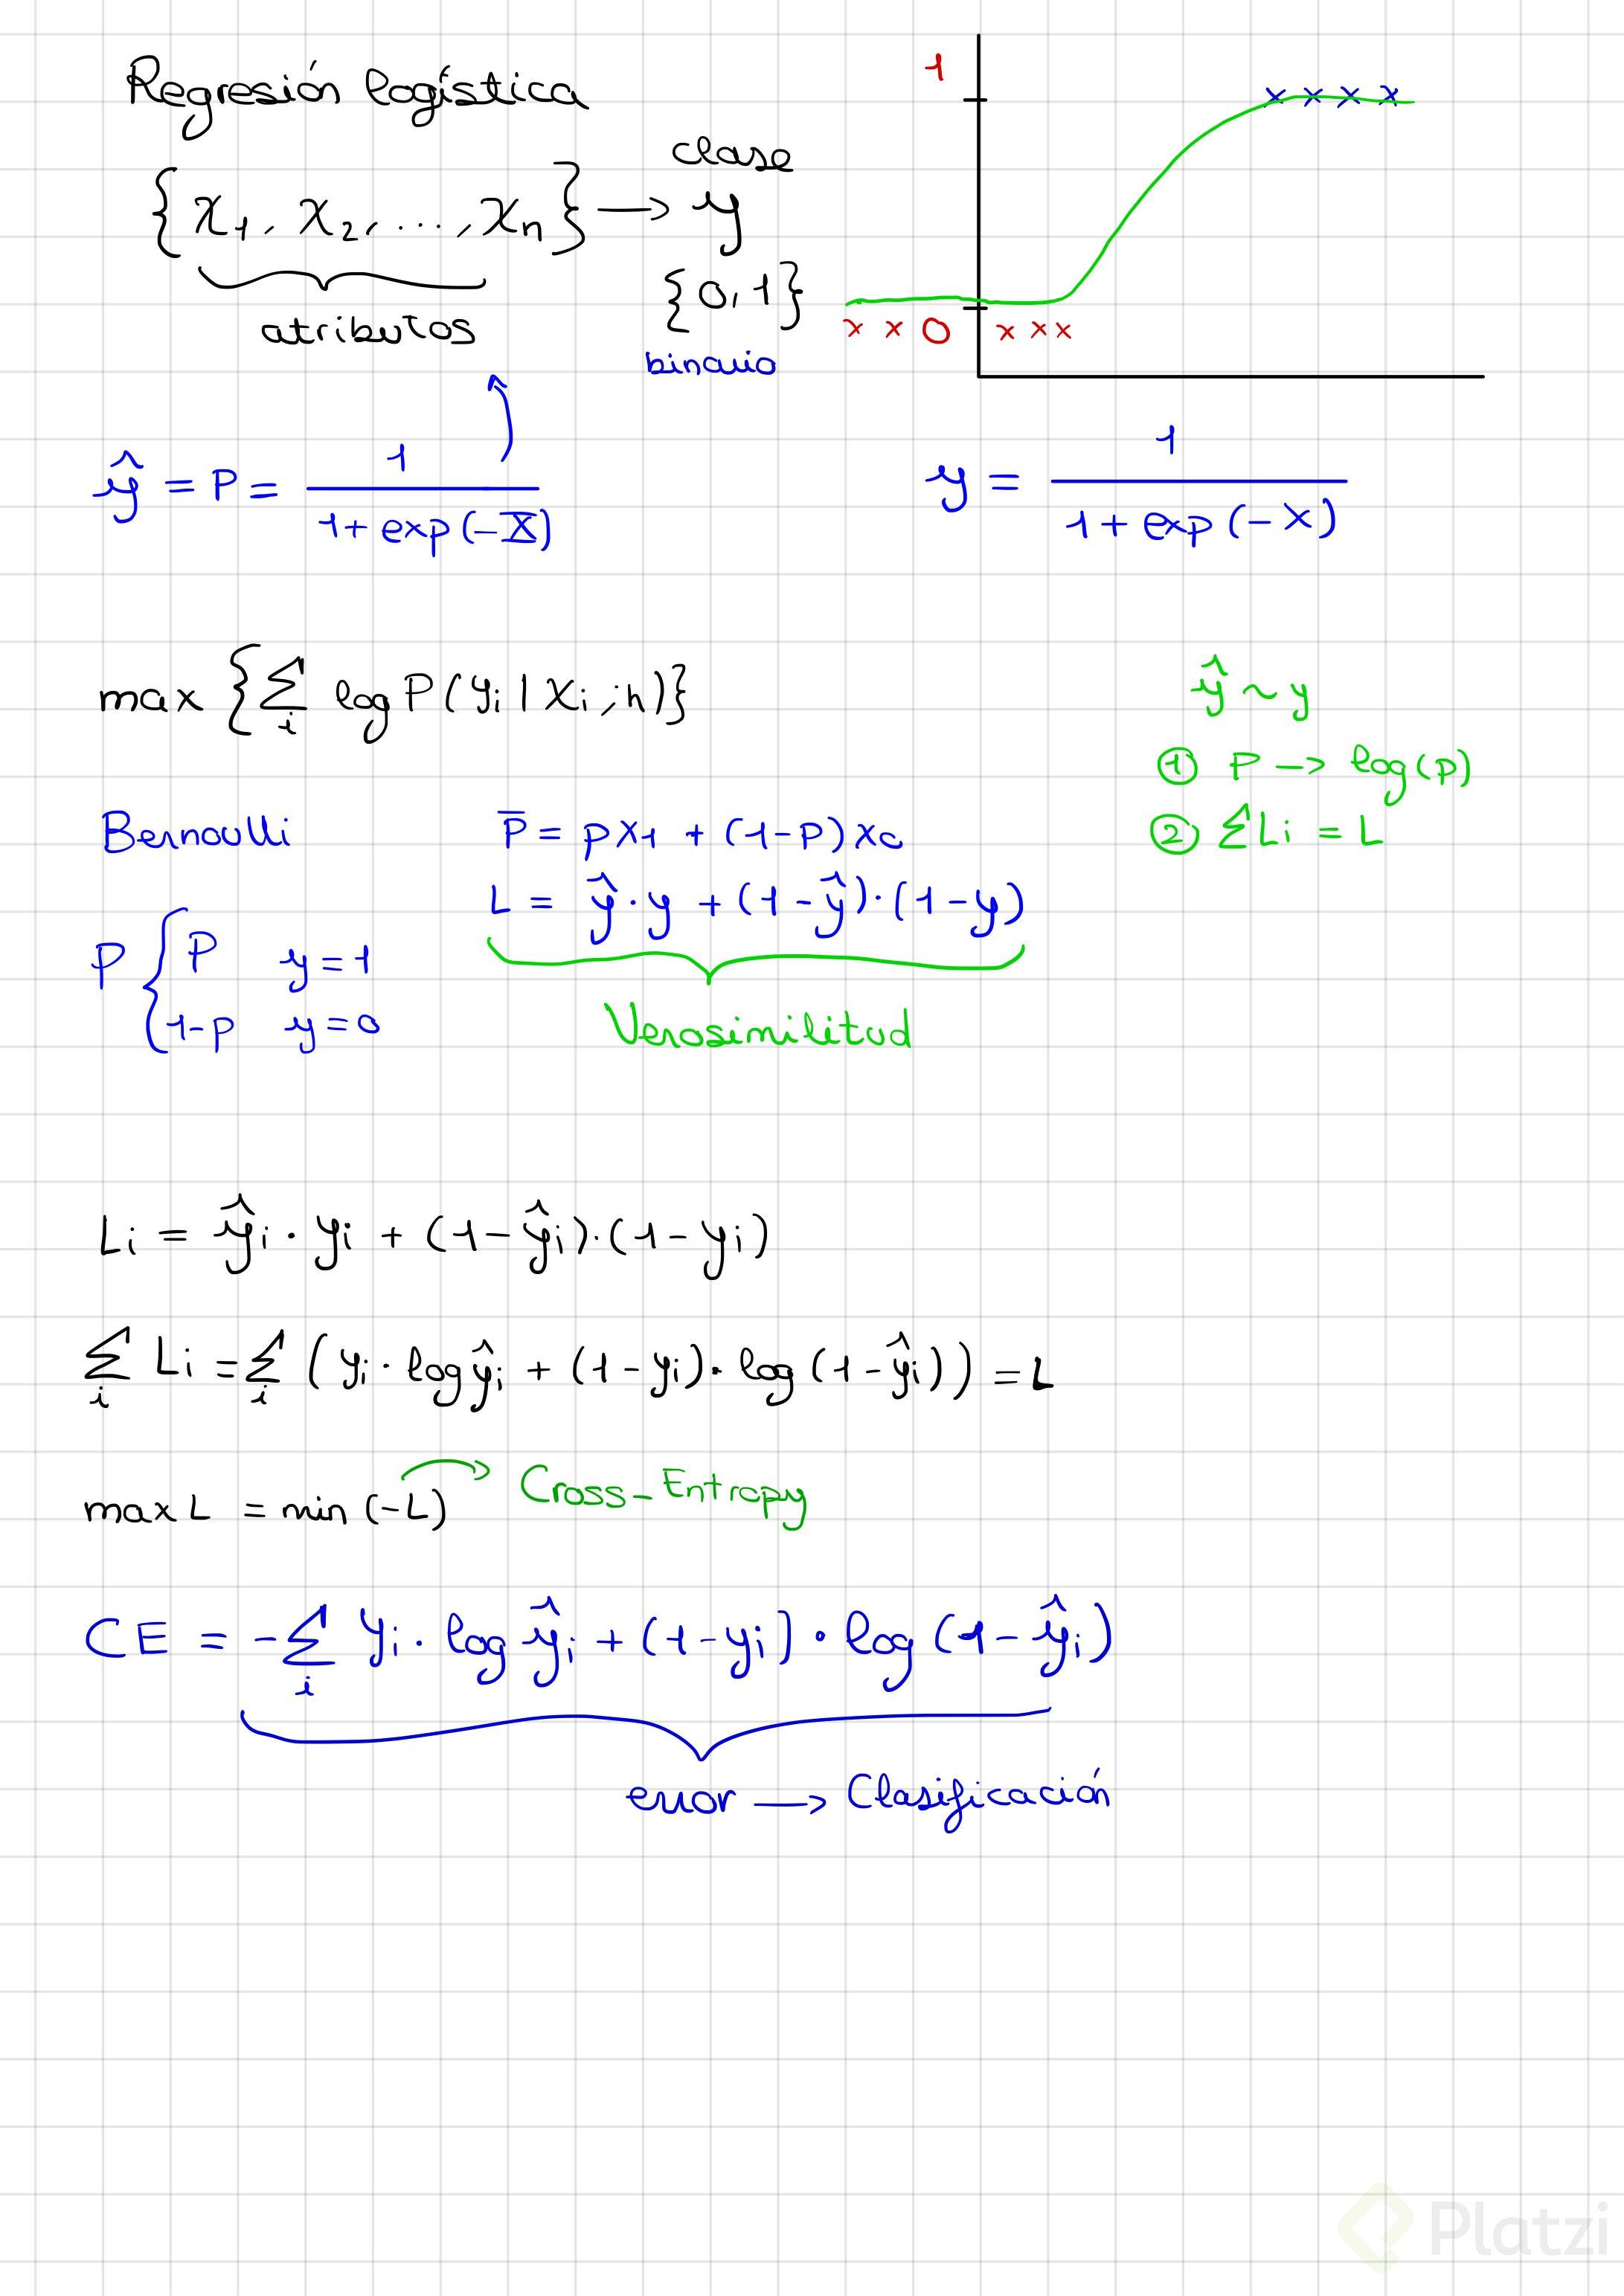
Comprender por qué se utiliza una función de error específica en un problema de clasificación binaria marca la diferencia entre aplicar fórmulas a ciegas y dominar realmente los fundamentos del machine learning. La regresión logística se conecta directamente con la estimación de máxima verosimilitud, y de esa conexión nace la célebre cross entropy, la función de costo que se minimiza cada vez que entrenamos un clasificador binario.
¿Qué diferencia a la regresión logística de la regresión lineal?
Mientras la regresión lineal ajusta una recta a datos con tendencia lineal, la regresión logística resuelve un problema de clasificación [0:25]. Los resultados posibles son solo dos: es o no es. Para modelar esa dualidad se emplea la función sigmoide, cuya curva lleva los valores hacia 0 o hacia 1 [0:55].
La idea central es que existe un conjunto de variables independientes o predictores —por ejemplo, la hora, el monto y la distancia geográfica de una transacción bancaria— que, combinados linealmente mediante pesos o parámetros beta, producen un valor que entra en la exponencial de la sigmoide [1:28]. Al ajustar esos betas, los puntos del dataset se redistribuyen para que la curva logística separe las clases de la forma más precisa posible [2:15].
¿Cómo se interpreta la salida de la sigmoide?
El resultado de la sigmoide es un número entre 0 y 1 que se interpreta como una probabilidad [2:30]. Si un punto real pertenece a la clase 1 y el modelo devuelve 0.9, el error para ese punto sería aproximadamente 0.1. El objetivo es elegir los parámetros beta que produzcan las probabilidades más altas en relación con las categorías reales.
¿Cómo entra la estimación de máxima verosimilitud en la regresión logística?
El planteamiento parte de maximizar la suma de los logaritmos de las probabilidades de obtener cada clase, dados los atributos y una hipótesis de modelamiento [3:05]. Para un solo punto del dataset, la distribución que describe cada intento de clasificación es Bernoulli: otorga probabilidad p al éxito y 1 − p al fracaso [3:50].
La verosimilitud de un punto se define así [4:25]:
Esta generalización asegura que la verosimilitud alcanza su valor máximo justo cuando las predicciones de la sigmoide coinciden con las clases reales [4:55].
¿Por qué se usan logaritmos y sumas?
Para obtener la verosimilitud de todo el conjunto de datos, se realizan dos operaciones clave [5:20]:
El likelihood de un punto queda expresado como:
Y_i · log(Ŷ_i) + (1 − Y_i) · log(1 − Ŷ_i)
Y la verosimilitud total es la suma sobre todos los puntos del dataset [5:55].
¿De dónde sale la cross entropy como función de costo?
Maximizar la verosimilitud total es equivalente a minimizar su negativo [6:20]. Ese negativo recibe el nombre de entropía cruzada o cross entropy, y se define como:
CE = − Σ [ Y_i · log(Ŷ_i) + (1 − Y_i) · log(1 − Ŷ_i) ]
Cada término de la suma aporta exactamente dos componentes porque existen dos clases [6:40]. Esta es la función de costo estándar en cualquier problema de clasificación binaria.
¿Por qué se usa precisamente esta función y no otra?
La cross entropy no es una elección arbitraria. Es una consecuencia directa de la estimación de máxima verosimilitud aplicada a una distribución de Bernoulli [7:05]. Minimizarla equivale a encontrar los parámetros que hacen que el modelo asigne las probabilidades más altas a las clases correctas. Dicho de otro modo, hallar el mínimo de la cross entropy es lo mismo que hallar el máximo de la verosimilitud más natural que se puede definir para este tipo de problema [7:20].
Entender esta derivación permite saber exactamente de dónde proviene la función de error y por qué es la indicada cuando solo hay dos clases posibles. Si te interesa profundizar, en la siguiente sesión se verifica numéricamente que la verosimilitud alcanza sus valores más altos cuando las predicciones de la sigmoide coinciden con las etiquetas reales. ¿Tienes dudas sobre alguno de estos pasos? Compártelas en los comentarios.
Natalia Belenguer Sanmartin
Miguel Angel Reyes Moreno
Gracias por este apunte :)
Juan Ochoa
Muchas gracias por el aporte!
Natalia Belenguer Sanmartin

Miguel Angel Reyes Moreno
Gracias por este apunte también :D
Daniel Andrés Giraldo Benites
gracias también por este... por cierto que aplicación usas?

Edward Toledo López
Sinceramente, creo que me hubiese servido tener más explicación práctica para entender mejor.
Jhon Edward Bedoya
🟢Estoy de acuerdo.
Carlos S. Aldazosa
Creo que la ruta de Data Science debe ser modificada y espero vengan nuevos cursos para tapar esos huecos entre cursos para comprender mejor esta clase de temas avanzados
Darían Rafael Sánchez Muñoz
ya llegue al punto en el que no entiendo nada, pero bueno aqui estamos

Eric Gabriel Martinez Labrin
x2
Juan R. Vergara M.
A veces nos sentimos así, pero es parte del proceso. Lo importante es no rendirse 😎

Francisco Vinueza
Diez cursos de redes neuronales y machine learning despues, entiendo la base matematica. Excelente explicacion.

Angel Gerardo Ochoategui Occampo
Y que tal los cursos, ¿Te consideras preparado? ¿Valio la pena? Muchas felicidades por cierto, por tu esfuerzo :D
Daniel Andrés Giraldo Benites
imaginate que las bases son aveces lo mas difícil de entender... luego su aplicación es mas razonada
Miguel Angel Reyes Moreno
Cross-Entropy: Función de error que busca siempre minimizarse en un problema de clasificación binaria. Es una consecuencia de la estimación de Máxima Verosimilitud.
Daniel Andrés Giraldo Benites
exactamente... ese seria una buena definición de libro sobre cross - entropy

Matías Collado
Maximizar la verosimilitud será equivalente a minimizar el Cross Entropy??

Cesar Augusto Morales Godoy

clint martinez
Me ayudo a entender tu aporte gracias

Jeinfferson Bernal G
Regresion Logistica
La regresion logistica nos resuelve problemas de clasificacion. Resolveremos un problema de clasificacion binaria: predecir si una trasaccion bancaria fue fraudulenta o no, teniendo como atributos independientes la hora de la transaccion, la distancia entre el lugar de la transaccion y la casa del dueño de la tarjeta, entre otros. 1 es fraudulento, 0 es no fraudulento.
Consideramos todos los atributos y los combinamos por medio de parametros que se encargaran de determinar la relevancia de las variables. Al combinar todas las variables con su respectivo peso, obtendremos una nueva variable X , la cual es pasada a la funcion sigmoide de manera que en el eje x estan codificadas todas las variables
!
En la Regresion Logistica se van modificando los parametros beta de manera que los puntos se redisribuyan lo suficientemente bien como para que la clasificacion a traves de la curva logistica sea lo mejor posible.
El resultado ‘y’ que se obtiene de la funcion sigmoide es un numero que esta entre 0 y 1 con valores intermedios en ese rango lo cual puede generar valores de probabilidad de P=0.9 que a su vez genera valores de error de E=0.1
Por tanto, la idea es seleccionar los parametros beta de manera las P arrojes los E mas pequeños posibles o las probabilidades mas altas en terminos de los valores 0 y 1
Ruddy Ramos
Gracias por el aporte.
Baltazar Andersson
Tuve que dejar este curso, espero lograr conseguirlo en el futuro
Cristofher Jumbo Jimenez
Podemos bro, podemos. Tengo que repasar tambien hahahha Probabilidad nunca fue mi fuerte, fue.
Andres López
Si, de verdad esto me supera y las escasas explicaciones del profesor no ayudan. Parece un repaso para personas con amplios conocimientos previos que una explicación apropiada para el módulo "básico" de la escuela de Data Science. Si no fuera porque este curso forma parte de Datacademy hace rato lo hubiera dejado para aprender las bases necesarias en fuentes externas para entender esto.
DERICK LOVATON
Qué ricas clases, qué rico curso! 🐱👤✨ El fondo o la vista detrás del profesor, el ambiente en general, luce magnifico 🙌 🌍
clint martinez
X2
Angel Gerardo Ochoategui Occampo
Cuando trabajas en Machine Learning o realizando analitica de datos, ¿Se tienen que realizar este tipo de calculos? ¿O solamente los estamos viendo por demostracion?
Miguel Torres
Hola, @angelochoategui. :D
Los cálculos se hacen, pero los hace una computadora con algún programa en Python, por ejemplo. En la clase lo vemos porque es necesario entender cómo funciona para saber diseñar las soluciones y utilizar librerías especializadas. 🐍🤓

Daniel Noreña
Como lo menciona @datormx normalmente los cálculos los realiza el programa elegido(python o R como preferencia mayoritaria). No obstante algo que me permitió a mi tener mejor conocimiento fue programar las funciones desde cero y no usar librerías, especialmente para las funciones de costo. Así he logrado entender mucho mejor el funcionamiento y adaptar hiperparametros mucho mas eficientemente.

JAVIER SANTIAGO SALGADO
Alguna bibliografía de este tema:
Daniel Andrés Giraldo Benites
genial gracias por compartirlo
JAVIER SANTIAGO SALGADO
Se podría concluir, que la mejor forma de realizar una función que minimice el error, es mediante encontrar el MLE, de esta función. ¿Existe alguna demostración que me pueda dar esta conclusión para cualquiera o es por cada caso puntual?
Manuel Oviedo
No es la mejor forma. Es más, suele ser de las peores formas porque hay veces que los resultados te pueden dar mayores a 1 o inferiores a 0. Existen otros métodos mejores como el PROBIT y LOGIT
Hugo Montoya Diaz


Brian Reina
No lo puedo creer! esto es básicamente una ecuación diferencial aplicada a un modelo sigmoidal.
Pablo Joaquín Cruz
Che, no estoy entendiendo nada de las últimas clases. ¿Alguien me orienta a qué debería saber previamente? ¿O simplemente me perdí en clases anteriores y debería rever?
Fabio Alvarez
Realmente está dando saltos muy grandes. Yo entendí esto porque ya he hecho muchos cursos, pero como primera vez está complicado entender el cross entropy y demás.

Kevin Toruño
Totalmente de acuerdo con Fabio, el salto de complejidad se volvio grande de una clase a otra.
Jose Potes
si no entendiste nada. no te preocupes lo de formulas es solo para que veas el origen de todo lo que harás pero en sintesis.
la regresión logistica es una tecnica estadistica(en probabilidad) que te ayuda a considerar muchas variables y en funcion de 2 valores(Verdadeo o Falso) y que la idea es que estas variables se puedan ir semejando a 1 o 0.
se usa la sigmoide porque es una funcion que demuestra claramente el comportamiento de estas variables en funcion de esas 2 condiciones o valores.
si es 1 o es 0.

Jorge Luis Castillo Ruz
Ando amor odio con este curso, cuando dijo lo de bernulli ya hasta la tercera vez que veo la clase entiendo que es por ser un problema binario, me gustaría que expliquen mejor ese tipo de cosas y no darlo por sentado