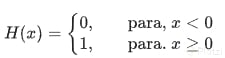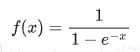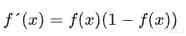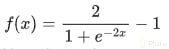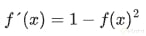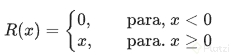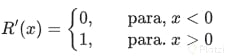Mediante la función derivada discreta que programamos en clases anteriores, podemos obtener una derivada aproximada de las funciones de activación.
def df(f): h=0.000001return(f(x+h)-f(x))/h
Derivada de una función lineal
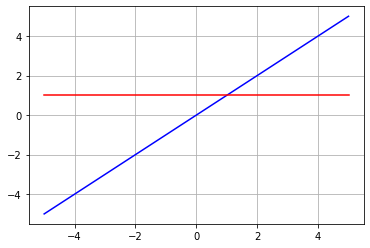
Las funciones lineales también pueden servir como funciones de activación de una red neuronal. Por esto es importante entender que la derivada de una función lineal es simplemente su pendiente. Es decir
""""""Sea
f(x)= mx+b
f'(x)= m
""""""deff(x):return x
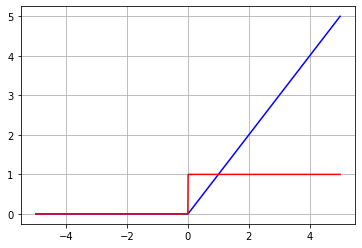
plt.plot(x, f(x),'b')plt.plot(x,df(f),'r')plt.grid()
Derivada de la función de Heaviside
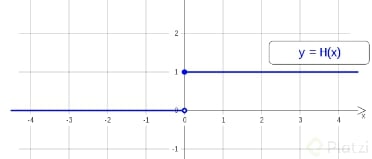
Recordemos que la función de Heavyside está dada por partes, de la siguiente forma:
Si vemos la gráfica de la función, nos damos cuenta que para x=0 la función ""crece"" completamente vertical hasta y=1. Es decir, la recta tangente en x=0 tiene pendiente infinita. Se puede demostrar que la derivada de la función de Heavyside corresponde a la ""Delta de Dirac"". Te invito a investigar la Delta de Dirac por tu cuenta, pero en resúmen, esta función tiende a infinito cuando x tiende a cero (en este caso), y vale cero para todos los demás valores.
Derivada de la función sigmoide
La función sigmoide es usada tanto en redes neuronales como en regresión logística. Esta función se expresa como:
Y su derivada:
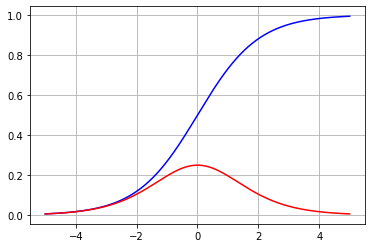
Optimizar esta función en redes neuronales puede llevar a un problema conocido como ""vanishing gradient"", debido a la complejidad de la función. Te invito a investigarlo. Por ahora, te dejo el código y el gráfico de esta función con su derivada.
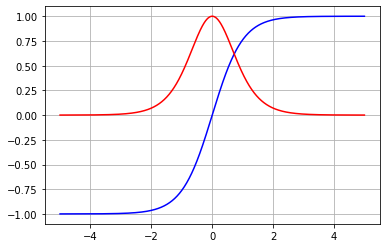
Con esta función ocurre algo similar que con la sigmoide. La complejidad de su derivada puede causar problemas durante la optimización. La función tangente hiperbólica está dada por:
Y su derivada
Derivada de la función ReLU
La función ReLU es especialmente útil en las capas intermedias de una red neuronal, gracias a su relativa sencillez. La función ReLu está definida como $R(x)=max(0,x)$, o bien:
Y su derivada está dada por
Nota: ReLu no tiene derivada en cero
Conclusión
Entender estas funciones y sus derivadas nos ayudará a comprender los fundamentos necesarios para desarrollar algoritmos de machine learning y redes neuronales. Esto no se trata de una receta de cocina, y sino de pensar de manera analítica usando dichos fundamentos.
Contribución creada por Ciro Villafraz con los aportes de: Joan Blanco, RubenSH y Faustino Correa Muñoz.
¿Cómo son las derivadas en las funciones de activación?
Hay algunas gráficas que no me gustan nada. Presentan conflicto en x=0. Me refiero a esas funciones por partes como la de Heaviside. Hay una linea vertical de color azul en x=0, lo que daría a entender que para ese valor de x la función toma TODOS los valores de y entre el 0 y el 1, y eso no es correcto. Solo hay un valor. En el caso de Heaviside, para x=0, y=1.
Las derivadas de las funciones de activación son importantes en el contexto de las redes neuronales y el aprendizaje automático, ya que se utilizan en el proceso de retropropagación del error para calcular los gradientes y actualizar los pesos de la red durante el entrenamiento.
HIII There!!!!, lo que El Profesor habla de Muerte Neuronal refierese al proceso de Aprendizaje por el Algoritimo del BackPropagation. a traves del Descenso del Grandeinte . la siguiente formula MultiParametrica.
en la
cual , utilizamoslas derivadas de los n_parametros de nuestra red newuronal incluso bias tambien, l uego si la derivada de estoas parametros tiende a '0.0' porque nuestra Funcion d'Activacion se satura en valores muy Negativos/Muy Positivos no habra un cambio significativo en L'Ecuacion del Descenso del Gradiente, pues esta depende de las derivadas parciales para actualizara parametros en minimizar la funcion del Error Cuadratico Medio, esto se conoce co Gradient Vanishing "desvanesimiento del gradiente" --> Muerte Neuronal , por lo que Nuestra red neuronal dejar'a de aprender porque ya no existe una derivada != 0.0 para actualizar parametros, luego tambien el learning_rate --> 0..0 por definicion de hiperparametro, luego nuestras neuronas tristemente nunca llegaran al minimo del error cuadratico medio y nunca aprenderan nada, por tanto es muy importante escoger una buena funcion de activacion entre caapas conectadas que no desvanezca el gradiente durante las derivadas sucesivas en capas neuronales durante el Training Process.
Algo que si es bueno que sepan desde ya es .
Descenso Gradiente != Dsevanecimiento del Gradiente. No son lo mismo .
LO Ideal seria evitar el desvanecimiento del gradiente durante el Descenso del Gradiente, El Objetivo es llegar al minimo posible de ECM usando el Algoritmo del Descenso del Gradiente en pendiente negativa hacia abajo en busca de un minimo relativo de una Gran Funcion MultiDimencional con miles de parametros en un HiperEspacio Infinito.
Esta clase parece desconectada de las clases anteriores. No se da una explicación clara de qué son las funciones de activación ni para qué sirven (gracias a los aportes en los comentarios de compañeros que ya pasaron por acá). Creo que se toman conceptos que en teoría debimos haber visto antes en clases anteriores, pero no fue así.
We use derivatives in machine learning when we have to perform back propagation.
What is “Back propagation”? Well, we have to start from the very very beginning.
INSIGHT: THE DERIVATIVE HERE IS THE GRADIENT. So, gradient descent is when we apply the derivative to some weights to control those weights and minimize the error. That’s why we call it “descent” — because we want to find a minimum to understand how to reduce the error. Applying the derivative to those functions lets us see how much we can adjust a weight to control it. Naturally, we reduce that weight because it was the one causing the error.
How a multilayer perceptron works
Let’s suppose we have to catalog 5 images; those images might be: “a dress,” “a t-shirt,” “some shoes,” “a jean,” “a ball.” So what we have here is 5 variables—this is our corpus. Since we have 5 variables, we need at least 5 input perceptrons. Each perceptron in the second layer connects to every perceptron in the first layer. In the second layer, each of those 5 perceptrons is fully connected back to the first layer, so it’s exponential: the more layers we add, the more computational operations we perform.
How do activation functions work?
Well, each perceptron receives our 5 variables, and THE MOST IMPORTANT THING: THE PERCEPTRON MULTIPLIES EACH VARIABLE BY ITS SYNAPTIC WEIGHT. After multiplying those, we get a result, and that result is applied to an activation function (ReLU, Leaky ReLU, Sigmoid, Heaviside…). After applying that function, we obtain an output, and that output is passed on to other neurons. After propagating through all layers, we end up with 5 outputs in the final layer, each representing a probability.
Where is the derivative?
Now, to check if we have the correct output, we apply a method called “BACK PROPAGATION.” First, we compute the error; for example:result = 5
expected output = 7
Then, with back propagation we differentiate the synaptic weights to determine which weight has the greatest influence on the error. Once we identify those weights via the derivative, we run our model again with updated, more controlled weights. We repeat this process until we reach the expected output.
Las derivadas de las funciones de activación son fundamentales en el entrenamiento de redes neuronales, porque permiten ajustar los pesos durante el aprendizaje usando backpropagation. Aquí te explico cómo son y por qué importan:
🧠 ¿Por qué necesitamos derivadas en activaciones?
Cuando entrenamos una red neuronal, usamos una técnica llamada descenso del gradiente, que necesita calcular cómo cambia el error al ajustar cada peso. Eso se hace a través de derivadas (o gradientes).
La derivada de la función de activación permite propagar el error hacia atrás desde la salida hasta las capas ocultas.
⚙️ Ejemplos comunes de funciones de activación y sus derivadas:
Función de ActivaciónFórmulaDerivadaSigmoideσ(x)=11+e−x\sigma(x) = \frac{1}{1 + e^{-x}}σ′(x)=σ(x)(1−σ(x))\sigma'(x) = \sigma(x)(1 - \sigma(x))Tanhtanh(x)=ex−e−xex+e−x\tanh(x) = \frac{e^x - e^{-x}}{e^x + e^{-x}}tanh′(x)=1−tanh2(x)\tanh'(x) = 1 - \tanh^2(x)ReLUReLU(x)=max(0,x)\text{ReLU}(x) = \max(0, x)ReLU′(x)={1six>00six≤0\text{ReLU}'(x) = \begin{cases} 1 & \text{si } x > 0 \\ 0 & \text{si } x \leq 0 \end{cases}Leaky ReLULReLU(x)=max(0.01x,x)\text{LReLU}(x) = \max(0.01x, x)LReLU′(x)={1x>00.01x≤0\text{LReLU}'(x) = \begin{cases} 1 & x > 0 \\ 0.01 & x \leq 0 \end{cases}SoftmaxSoftmax(xi)=exi∑exj\text{Softmax}(x_i) = \frac{e^{x_i}}{\sum e^{x_j}}Tiene una derivada más compleja (matriz Jacobiana) usada en clasificación multiclase
🟢 ¿Qué significa esto en la práctica?
La sigmoide y tanh son suaves, pero pueden causar el problema de gradientes pequeños (vanishing gradients).
La ReLU es muy usada porque es simple y eficiente, y no sufre tanto del problema anterior.
La Softmax se usa en la última capa para clasificación multiclase.
📌 Resumen
Las derivadas permiten que el modelo aprenda ajustando pesos.
Elegir la función de activación adecuada impacta directamente en la velocidad y eficacia del aprendizaje.
Las funciones de activación son transformaciones matemáticas aplicadas a la salida de cada neurona en una red neuronal. Su objetivo principal es introducir no linealidad, controlar el rango de salida y permitir que la red pueda aprender patrones complejos mediante backpropagation.
Una conclusión que saco de esta clase es que elegir una función de activación es también elegir cómo se comporta su derivada. La clase advierte que la complejidad de la sigmoide y de la tangente hiperbólica puede causar problemas durante la optimización, y para la sigmoide menciona el vanishing gradient. La ReLU, definida como el máximo entre cero y x, se presenta en cambio como especialmente útil en las capas intermedias gracias a su relativa sencillez. De ahí que la sencillez de una función no sea un detalle menor: parece pesar al decidir cuál usar en cada parte de la red.