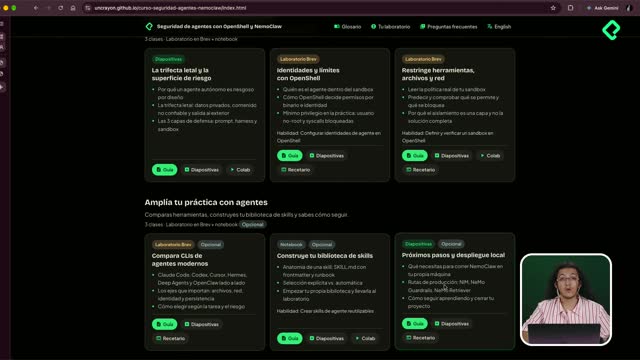
Aprender a diseñar un agente de IA seguro es el objetivo central de este curso de Platzi en conjunto con el NVIDIA Deep Learning Institute. Está pensado para cualquier persona, sin necesidad de saber programar ni tener una computadora poderosa, porque todo se hace con modelos gratuitos de NVIDIA y un cupón de cloud. Si trabajas con asistentes de IA y te preocupa darles acceso sin control, aquí encuentras el camino.
La idea es sencilla de imaginar: contratas a alguien nuevo, llega a trabajar y su computador tiene accesos restringidos. No puede abrir todos los documentos ni editarlos libremente. Eso es exactamente lo que construimos con este agente y sus restricciones.
Qué diferencia hay entre un LLM y un agente de IA
Antes de hablar de seguridad, conviene separar dos cosas que suelen confundirse: un modelo y un agente.
Un LLM o modelo es una simple llamada. Recibe un texto, lo procesa en un servidor y devuelve una respuesta [00:48]. Así funcionan los chats de ChatGPT, Claude o Gemini: les das una entrada, te dan una salida y normalmente no tienen memoria. Los más sencillos, como los chatbots, ni siquiera acceden a herramientas.
¿Qué es un agente de IA? Es un modelo puesto en un loop que puede observar, leer documentos, ver imágenes o escuchar audios, tomar decisiones y actuar usando herramientas y memoria. Repite ese ciclo hasta terminar la tarea.
Y aquí viene un detalle clave: estos loops no corren de manera infinita. Tienen un budget asignado, es decir, la cantidad máxima de ciclos que permitimos [01:50].
Por qué importa la seguridad en un agente de IA
Imagina que a este nuevo asistente le dejas leer documentos, escribirlos y ejecutar programas. Si además le das libertad para entrar a Internet, puede encontrar un documento con instrucciones maliciosas.
A eso se le llama prompt injection, y puede cambiar por completo el comportamiento del agente [02:18]. La gran pregunta del curso nace justo de ahí.
¿Qué es el prompt injection? Es cuando un agente lee contenido externo con instrucciones ocultas o maliciosas que alteran su comportamiento sin tu permiso. Por eso se controla su acceso a Internet y a herramientas.
¿Cómo dejamos trabajar al agente sin darle las llaves de todo, pero que siga siendo útil? Esa tensión es la que resuelve la arquitectura que viene.
Cómo funcionan NeMo, OpenShell y OpenCloud juntos
La solución se desglosa en tres piezas que trabajan en conjunto. Vale la pena entender el rol de cada una antes de pasar a la práctica.
- OpenCloud es el agente, el asistente, el cerebro de la operación [03:02].
- OpenShell, de NVIDIA, es la caja donde encerramos a OpenCloud para que siga las reglas, reforzadas no solo por un prompt sino también en código [03:10].
- NeMo Cloud es el kit que arma todo: donde instalas, configuras las reglas y dejas vivir al asistente [03:22].
En el esquema, NeMo Cloud es el espacio donde todo vive, OpenShell es la configuración de seguridad que llamamos sandbox, y OpenCloud es el cerebro [03:40]. Un matiz importante: OpenShell no necesita a NeMo Cloud para funcionar, puedes usarlo gratis para crear tu propio sandbox.
Cómo fluye una petición hacia el agente
Supón que ya tienes todo tu NeMo Cloud configurado y le pides al agente que busque una reservación, redacte un documento o envíe un email.
Ese mensaje llega a un túnel llamado gateway de OpenShell [04:30]. Piénsalo como el túnel que conecta el exterior con el cuarto cerrado donde vive tu asistente. Ahí viven las llaves, los modelos y las reglas configuradas.
Lo mejor: nada de tus datos personales, como credenciales, tarjeta de banco o cuenta de correo, abandona el gateway de OpenShell [05:04]. Y poner estas reglas no implica código, solo hacer clic en algunos botones y rellenar campos.
Qué modelos usa el agente y cómo accedes gratis
OpenCloud por sí solo no sirve de nada sin un cerebro detrás, y ese cerebro es un modelo de NVIDIA [05:24].
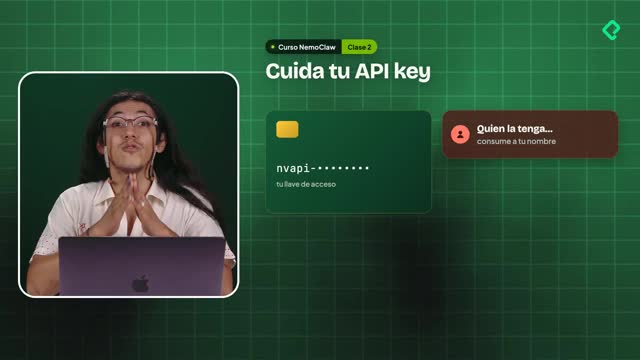
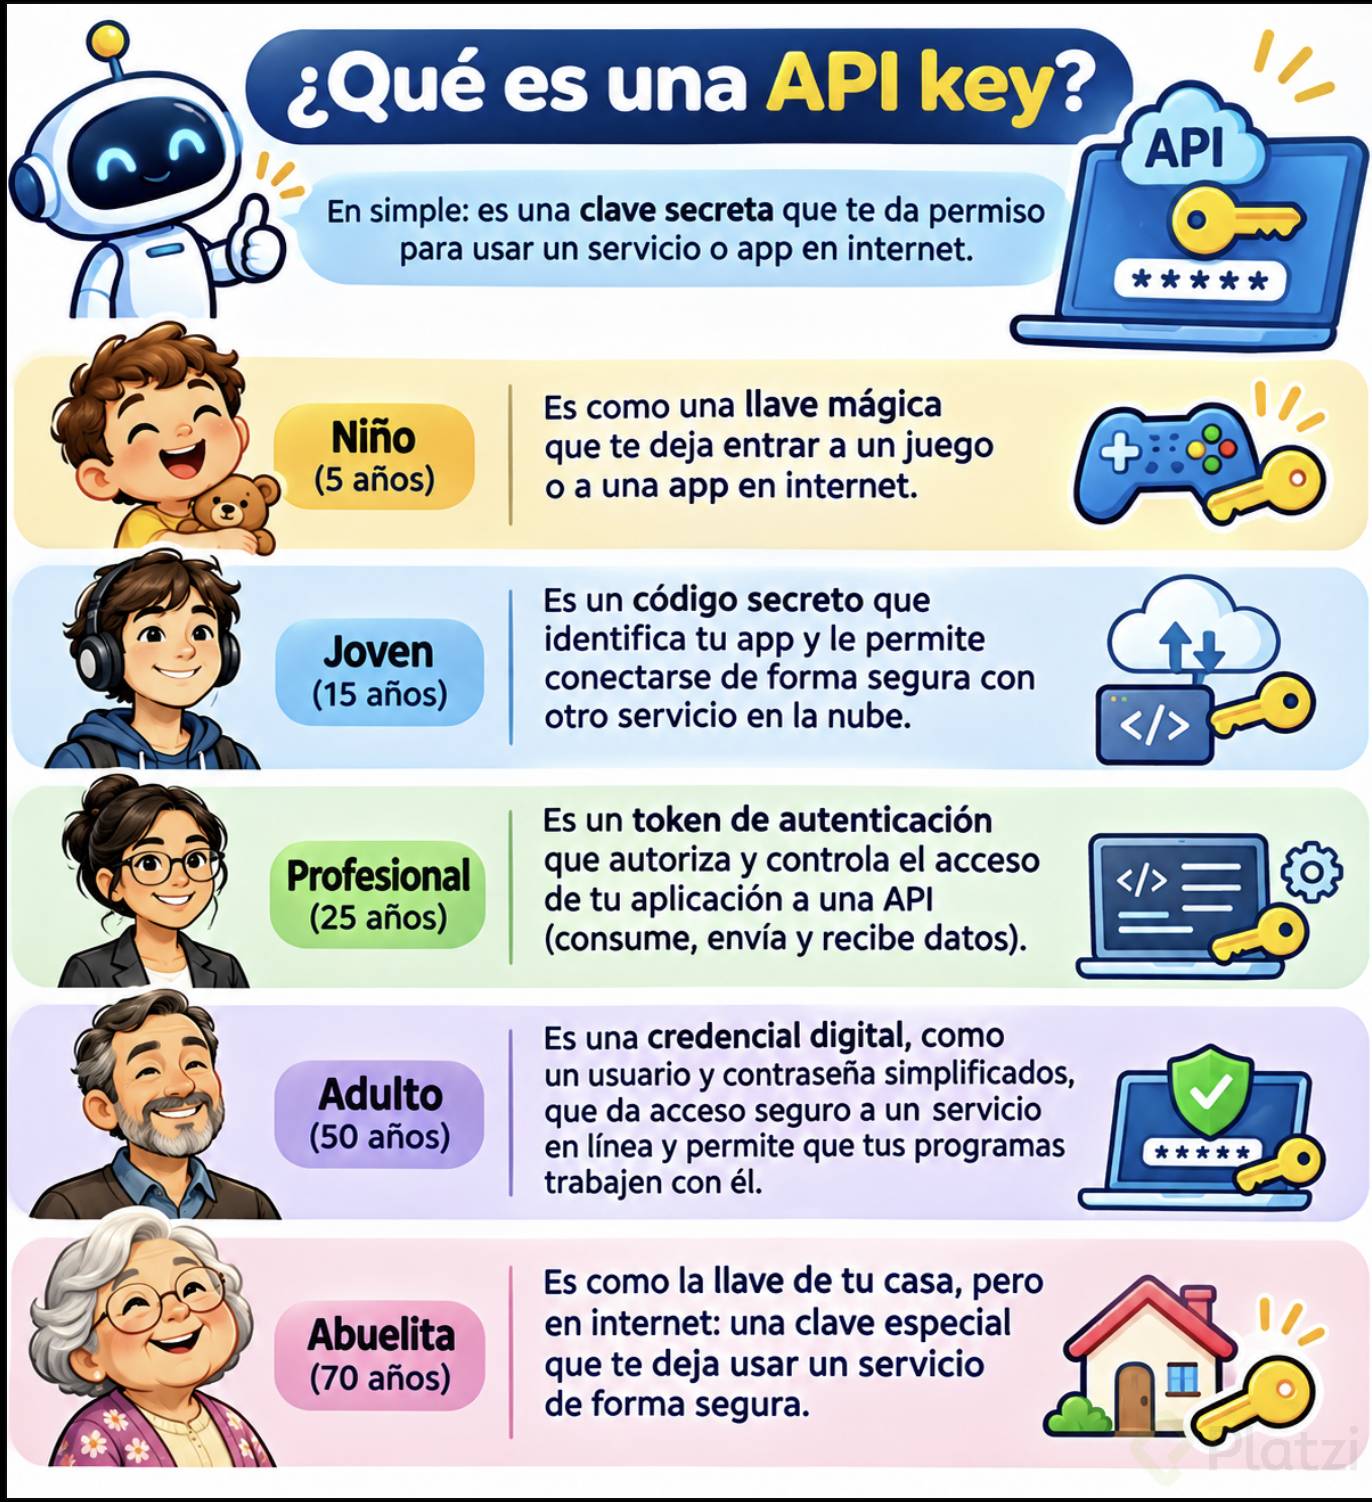
A través de la plataforma build.nvidia.com obtienes una API key que usarás para acceder a los modelos gratuitos. Estos modelos se llaman Nemotron y son los que utilizaremos directamente [06:15]. Cuidado con la confusión frecuente: NeMo Cloud no es un modelo, es una plataforma, un framework que arma y maneja todo el cuarto.
Un punto de seguridad que no debes olvidar: el agente por default no tiene acceso a Internet a menos que tú lo permitas [05:48]. Tener conciencia de cuándo abrir y cuándo cerrar ese acceso es parte del trabajo.
- Laboratorio en la nube con un cupón de un dólar, suficiente para trabajar entre cuatro y siete horas [06:50].
- No necesitas instalar nada: con un navegador basta [07:04].
- Puedes hacer tantas consultas como quieras a los modelos gratuitos de NVIDIA.
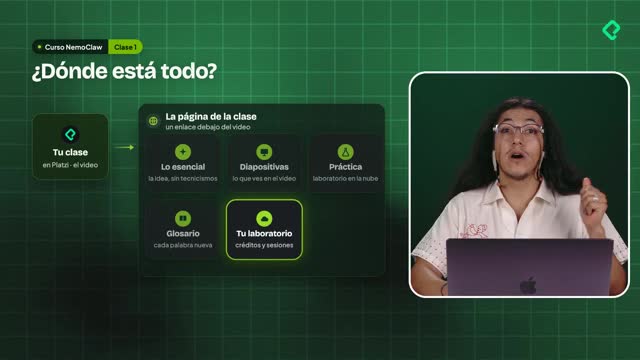
Todo tu material está en la clase de Platzi, con video, recursos y una página tipo GitHub donde encuentras lo esencial, las diapositivas, un glosario y las guías para redimir créditos y usar el laboratorio. Si sabes programar, puedes clonar el repositorio, pero no es requisito.
¿Qué parte de la arquitectura te genera más dudas? Déjalo en los comentarios antes de pasar a crear tu cuenta en build.nvidia.com y hacer tu primera llamada a un modelo.